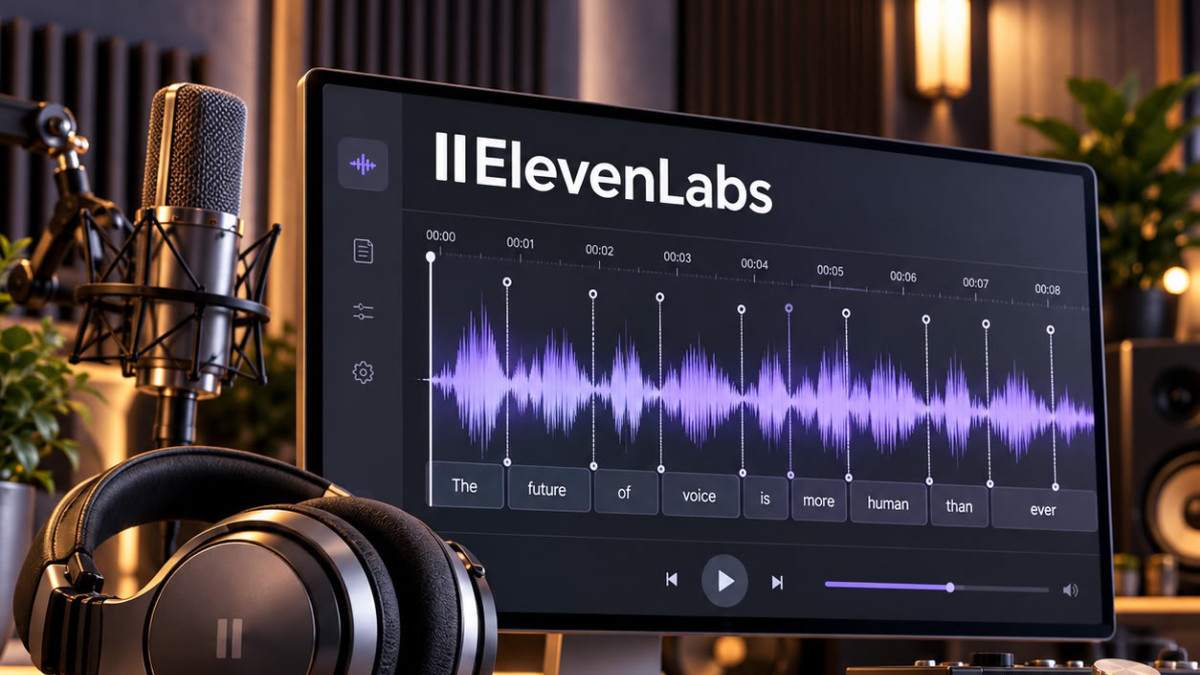

تقدم إيلفين لابس Cue، وهو نموذج محاذاة قسري يضع كل حرف من ملف صوتي على خط زمني دقيق. وفقًا للشركة، فهو أكثر دقة من جميع أدوات المحاذاة التي تم اختبارها على تسجيلات حقيقية، ضمن لغات المعيار الـ29. وهو يغذي بالفعل عائلة نماذج Scribe، نموذج النسخ المكتوب الخاص بإيلفين لابس.
كل مشاهد يعرف تأثير ظهور الترجمة النصية متأخرة ثانية واحدة: المشهد يفقد تماسكه. تواجه الفيديوهات والبرامج التي تستخدم نماذج صوتية المشكلة نفسها، عندما تبرز النسخة المكتوبة الكلمة الخاطئة. المحاذاة القسرية هي عملية ربط كل كلمة في النسخة المكتوبة باللحظة الدقيقة التي نُطقت فيها. لا يجب الخلط بينها وبين محاذاة الذكاء الاصطناعي، التي تهدف إلى جعل سلوك الأنظمة يتوافق مع القيم والتفضيلات البشرية. هنا، الأمر يتعلق فقط بمطابقة النص والصوت.
دانييلا كوزلوف، باحث في إيلفين لابس ويعمل على المحاذاة، يشرح الصعوبة: «البشر جيدون إلى حد ما في محاذاة الوسائط، على الأقل على مستوى الكلمة. غالبًا ما تكون لدينا فكرة بديهية عن مكان بداية الكلمة، ولكن على مستوى الحرف وبدقة أقل من جزء من الألف من الثانية، يكون الأمر أكثر صعوبة بكثير.»
حدود لأدوات المحاذاة التقليدية
قبل Cue، كانت الشركة تستخدم أداة محاذاة كانت مجهزة في جميع منتجاتها. استجوب الفريق العملاء والمستخدمين الداخليين حول إحباطاتهم، وتطابقت الشكاوى مع حدود الأدوات مفتوحة المصدر التي تم اختبارها. المشكلة الأولى تتعلق بالمدة: العديد من أدوات المحاذاة تعمل جيدًا على مقاطع مدتها حوالي 30 ثانية، ولكن الملفات الأطول يجب تقسيمها. كل جزء يمكن أن يضيف خطأ تزامن صغير، وربط المقاطع يمكن أن يضيف أخطاء أخرى.
على التسجيلات الكاملة، متوسط خطأ Cue هو 179 ميلي ثانية، مقابل 283 ميلي ثانية إلى أكثر من 6000 ميلي ثانية للأدوات مفتوحة المصدر. الظروف الواقعية تجعل المهمة أكثر تعقيدًا. الضوضاء الخلفية، والأصوات المتداخلة، والموسيقى الخلفية تجعل العديد من الأدوات تفقد مراجعها، في حين أن هذه بالضبط هي الملفات التي يرغب العديد من المستخدمين في تحويلها إلى نص. على التسجيلات الإنجليزية التي تحتوي على مثل هذه العيوب، يصل متوسط خطأ Cue إلى 57 ميلي ثانية، مقابل 65 ميلي ثانية إلى 920 ميلي ثانية للأدوات الأخرى.
التغطية اللغوية تطرح تساؤلات أيضًا. معظم أدوات المحاذاة مفتوحة المصدر تتطلب نموذجًا منفصلًا لكل لغة، بحيث تكون اللغات التي لديها بيانات تدريب قليلة معالجة بشكل أقل جودة، أو غير مدعومة. MMS-FA هو الأداة الوحيدة الأخرى التي تغطي لغات المعيار الـ29، وقد أظهر Cue عمومًا سرعة أكبر في تحديد الحدود بين الكلمات.
السرعة مهمة أيضًا، لأن محاذاة كميات كبيرة من الصوت يمكن أن تصبح مكلفة بسرعة. وفقًا لإيلفين لابس، يقوم Cue بمحاذاة ساعة من الصوت في حوالي نصف ثانية على وحدة معالجة الرسومات الإنتاجية الخاصة به. ثاني أسرع أداة، Qwen3-ForcedAligner، تستغرق قرابة ثانيتين، والأبطأ تجاوز الدقيقة.
أغانٍ تمت محاذاتها
الموسيقى تمثل تمرينًا صعبًا، لأن الغناء يمطط الكلمات ويشوشها. ومع ذلك، عالج Cue مجموعة فرعية من الأغاني من مجموعة بيانات JamendoLyrics MultiLang، المرخصة بموجب رخصة المشاع الإبداعي، بالإنجليزية والفرنسية والإسبانية والألمانية، في جولة واحدة. وضع 92.7% من الكلمات ضمن أقل من 0.3 ثانية من المرجع، مقابل 82.0% للأداة التالية. متوسط خطأه في بداية الكلمات هو 0.82 ثانية، أي حوالي نصف خطأ أقرب منافس. تفوق على جميع الأدوات الأخرى في 19 أغنية على الأقل من أصل 22 أغنية.
تم نشر Cue بسرعة، وأبلغ أحد العملاء أن اللغة الجورجية وبعض اللغات الأخرى محدودة الموارد أعطت نتائج أقل من المتوقع. تؤكد إيلفين لابس أنها حددت المشكلة، وأجرت بحثًا حول التحسينات الممكنة، ودربت نسخة جديدة، ونشرتها في أقل من 24 ساعة بعد أول إبلاغ.
يستخدم Cue بالفعل في جميع عمليات تحويل الكلام إلى نص في إيلفين لابس. لاستخدامه مباشرة، توجه الشركة إلى واجهة برمجة تطبيقات المحاذاة القسرية الخاصة بها.
