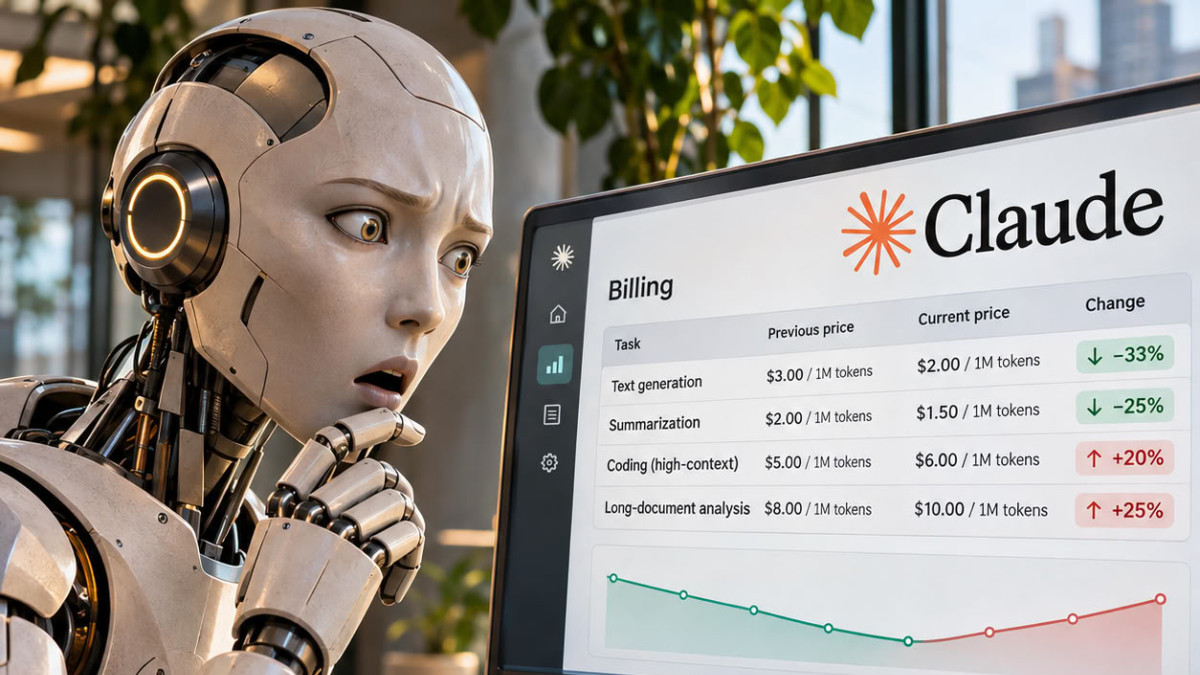

Nowy model Claude Fable 5.2 firmy Anthropic jest taniej wyceniany niż jego poprzednik, ale koszt wykonania zadania może wzrosnąć. Według Artificial Analysis, które oceniło model przy maksymalnych ustawieniach, każde zadanie kosztuje go średnio 26,54 dolara, wobec 12,99 dolara dla Fable 5.1 przy tych samych ustawieniach.
Wydany 9 listopada Fable 5.2 kosztuje 8 dolarów za milion tokenów wejściowych i 40 za wyjściowe, wobec 10 i 50 dolarów dla Fable 5.1, którego cennik Anthropic zalicza teraz do starych modeli. Token to fragment słowa służący jako jednostka rozliczeniowa: rachunek za model oblicza się więc jako cenę pomnożoną przez wolumen. Przy maksymalnych ustawieniach, gdzie model poświęca najwięcej czasu na przemyślenie przed odpowiedzią, Fable 5.2 wygenerował 275 milionów tokenów wyjściowych w całym zestawie testów, wobec 163 milionów dla Fable 5.1, czyli o 69% więcej przy jednostkowej cenie niższej o jedną piątą. Nowy model uzyskał też indeks 65 wobec 49, według tej samej oceny.
Cena spada, wolumen rośnie szybciej
Firma doradcza Accenture, która przepytała 750 menedżerów w 17 krajach, widzi w agentach mnożnik konsumpcji, ponieważ ich wywołania następują po sobie w wydłużającym się kontekście. Google obserwuje to zjawisko w przypadku własnego modelu. Gemini 4 Carbon, udostępniony deweloperom 10 listopada, jest sprzedawany po cenie wprowadzeniowej Gemini 4 Argon, czyli 2 dolary za milion tokenów wejściowych i 10 za wyjściowe. Według ogłoszenia Google DeepMind, Carbon zużywa więcej tokenów niż Argon do rozumowania i wydłużania pętli weryfikacyjnych, a Artificial Analysis mierzy mu prawie dwa razy więcej tokenów wyjściowych.
Cena wprowadzeniowa wygasa 30 listopada. Od 1 grudnia cena Carbon wzrośnie do 4 i 20 dolarów, a to samo zadanie będzie kosztować dwukrotnie więcej przy tym samym zużyciu. Argon, którego cena promocyjna kończy się tego samego dnia, również podwaja cenę. Dziewięciu na dziesięciu ankietowanych przez Accenture menedżerów twierdzi, że tańszy token skłoni ich do rozszerzenia przypadków użycia, a nie do ograniczenia wydatków.
Sprzedawany na stanowisko, płatny za token
«Tokeny mają znaczący wpływ na marżę brutto», podsumował Jean-Philippe Couturier, prezes wydawcy Whoz i administrator Numeum, w wywiadzie dla LeMagIT opublikowanym 12 listopada. SaaS stanowi 67% przychodów ze sprzedaży oprogramowania firm badanych w rankingu Top 250 EY i Numeum, przedstawionym 4 listopada, i historycznie sprzedawany był na stanowisko lub w formie licencji. Klient, który intensywniej wykorzystuje agenta, płaci jednak tę samą abonamentową stawkę, podczas gdy wydawca korzystający z modelu zewnętrznego rozlicza się z dostawcą za każdy token.
W tej grupie 29% wydawców nie zdefiniowało strategii cenowej dla AI. Moduł premium, pierwsza wymieniana opcja z 26%, pozostaje pakietem, rozliczenie według użycia przyciąga 22%, a cennik według wartości lub wyniku – 5%. Od 1 czerwca klienci GitHub, spółki zależnej Microsoft, widzą, że Copilot jest rozliczany w kredytach AI wliczonych w ich pakiet, a przekroczenie jest płatne. EY zauważa, że te koszty uzależnione od konsumpcji utrudniają przewidywanie wydatków IT.
Ustawienie wysiłku, prawdziwa cena modelu
Jean-Philippe Couturier widzi rozwiązanie w routingu, który powierza każde żądanie wystarczającemu modelowi. Podobny wybór odbywa się również wewnątrz tego samego modelu. Ustawiony na średni wysiłek, domyślny w Anthropic, Fable 5.2 generuje 41 milionów tokenów przy indeksie 56, wobec 275 milionów i 65 punktów przy maksimum. Przy tym ustawieniu radzi sobie lepiej niż Fable 5.1 wykorzystany maksymalnie, przy czterokrotnie mniejszej liczbie tokenów.
W badaniu TCS opublikowanym 4 listopada wśród 1333 menedżerów w 25 krajach, 9% deklaruje ciągłe poprawianie wartości generowanej na token. Na drugim końcu skali, 6% przyznaje się do ograniczonej widoczności związku między zużytymi tokenami a wynikami, a 31% śledzi swoje koszty bez systematycznego sprawdzania, czy uzyskana wartość je uzasadnia. Łącznie 37% respondentów nie zestawia regularnie swoich wydatków z uzyskiwanymi korzyściami.
