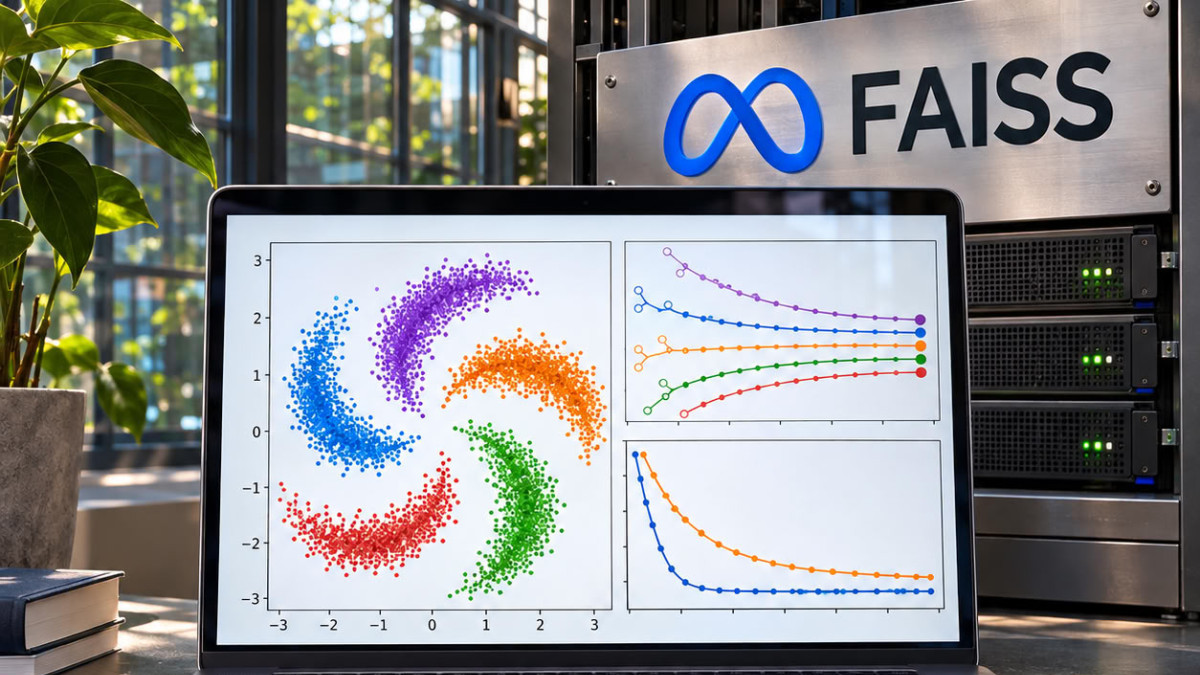

Forscher von Meta FAIR haben e-means veröffentlicht, einen Algorithmus, der als direkter Ersatz für den Lloyd-k-means-Algorithmus vorgestellt wird. Laut den Autoren erreicht er in 1,4 bis 2,6 Epochen den Verlustwert, für den Lloyd-k-means 25 Epochen benötigt. Er ist in FAISS 1.16.0 verfügbar, unter dem Modul faiss.contrib.e_means.
k-means ist eine Clustering-Methode, die Daten in Gruppen einteilt, die jeweils durch ein Zentrum namens Centroid repräsentiert werden. Für diejenigen, die Vektorindizes, Quantizer oder Datenvorbereitungs-Pipelines erstellen, ist diese Berechnung oft der langsamste Offline-Schritt – genau hier setzt e-means an.
Ein gleitender Durchschnitt statt einer vollständigen Neuberechnung
Alle Varianten von k-means speichern für jede Gruppe eine Summe S und einen Zähler N, wobei der Centroid der Quotient aus S und N ist. Sie unterscheiden sich hauptsächlich darin, wie S und N aktualisiert werden. Der Lloyd-Algorithmus berechnet diese Werte in jeder Iteration aus dem gesamten Datensatz neu. MacQueen führte 1967 eine kontinuierliche Addition von Batch-Statistiken ein, sodass alte Zuweisungen nie verschwinden.
e-means wählt einen Mittelweg: Es dämpft alte Statistiken mit einer Rate α gemäß der Formel S ← (1−α)S + αs, und analog für N. Alte Zuweisungen verblassen so allmählich, und die Centroids folgen den aktuellen Daten. Der Lloyd-Fall entspricht einem kompletten Batch mit α = 1. Auf dem DEEP-Datensatz liegt dieser Fall 1,8 % über dem besten erzielten Verlust.
Die Autoren testeten auch klassischen Gradientenabstieg. In seiner besten Konfiguration bleibt er auf DEEP 1,6 % über EMA und auf SIFT 0,4 %. Sie vermuten, dass die EMA-Methode überlegen ist, weil die Centroids immer innerhalb der konvexen Hülle ihrer zugewiesenen Punkte bleiben.
Parameter durch Skalierungsgesetze festgelegt
Zwei empirisch angepasste Skalierungsgesetze bestimmen die Batch-Größe B und den anfänglichen Schritt α0 basierend auf der Datensatzgröße, der Anzahl der Cluster und der Epochenzahl. Auf zurückgehaltenen Datensätzen erreicht der Median des Bedauerns 0,07 % für das Schrittgesetz. Der Schritt folgt dann einem Kosinus-Zeitplan von α0 bis 0,1α0. Zwei weitere Mechanismen ergänzen das System: das Wiederbeleben « toter » Cluster, die unter eine Größenschwelle fallen und durch Aufspalten eines großen Clusters neu gestartet werden, sowie eine Finalisierung mit dem exakten Durchschnitt der letzten Epoche.
Laut den Autoren sind die angegebenen Leistungen auf der GPU 10- bis 45-mal schneller als Flash-KMeans und auf der CPU 8- bis 15-mal schneller als Faiss k-means. Im VIBE-Benchmark benötigten die 11 Embedding-Datensätze zwischen 1,6 und 2,4 Epochen. Für das Skalierungsexperiment wurde der DINO10B-Datensatz mit 10 Milliarden Embeddings von 1024 Dimensionen in 16,7 Millionen Clustern in 2,5 Epochen verteilt. Die GPU-Ergebnisse wurden auf H100 erzielt. Bei Konfigurationen mit 16 Millionen Centroids erreichen die float32-Akkumulatoren 64 GiB, was eine Verteilung der Centroids auf mehrere GPUs erfordert.
Eine Single-Thread-CPU-Demo im Ankündigungsthread zeigt 4,39 s für Lloyd über 25 Epochen gegenüber 0,43 s für e-means über 2,2 Epochen. e-means wird unter der MIT-Lizenz über FAISS verteilt.
