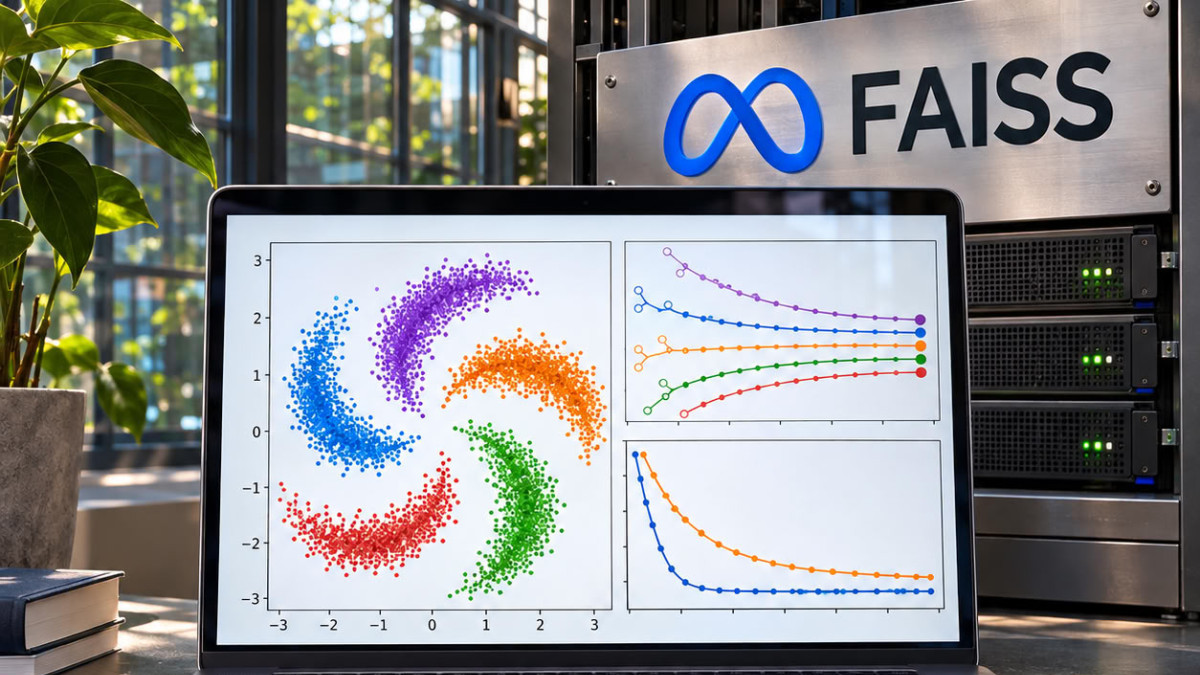

Investigadores de Meta FAIR han publicado e-means, un algoritmo presentado como un reemplazo directo del algoritmo k-means de Lloyd. Según los autores, alcanza en 1,4 a 2,6 épocas la pérdida que el k-means de Lloyd obtiene en 25 épocas. Está disponible en FAISS 1.16.0, bajo el módulo faiss.contrib.e_means.
El k-means es un método de agrupamiento que distribuye datos en grupos, cada uno representado por un centro llamado centroide. Para quienes construyen índices vectoriales, cuantificadores o pipelines de preparación de datos, este cálculo suele ser la etapa offline más lenta, y es precisamente la que apunta e-means.
Una media móvil en lugar de un recálculo completo
Todas las variantes del k-means conservan, para cada grupo, una suma S y un contador N, siendo el centroide el cociente de S entre N. Difieren principalmente en la manera en que S y N evolucionan. El algoritmo de Lloyd recalcula estos valores a partir del conjunto de datos completo en cada iteración. MacQueen, en 1967, añade continuamente las estadísticas de los lotes, de modo que las asignaciones antiguas nunca desaparecen.
e-means adopta una vía intermedia: atenúa las estadísticas antiguas a una tasa α, según la fórmula S ← (1−α)S + αs, y lo mismo para N. Las asignaciones antiguas se borran así poco a poco, y los centroides siguen los datos recientes. El caso de Lloyd corresponde a un lote completo con α = 1. En el conjunto de datos DEEP, este caso se sitúa un 1,8 % por encima de la mejor pérdida obtenida.
Los autores también probaron un descenso de gradiente clásico. En su mejor configuración, se mantiene un 1,6 % por encima del EMA en DEEP y un 0,4 % en SIFT. Suponen que el método EMA se impone porque los centroides permanecen siempre dentro de la envolvente convexa de sus puntos asignados.
Parámetros fijados por leyes de escala
Dos leyes de escala, ajustadas empíricamente, determinan el tamaño del lote B y el paso inicial α0 a partir del tamaño del conjunto de datos, del número de clusters y del número de épocas. En conjuntos de datos apartados, la mediana del arrepentimiento alcanza el 0,07 % para la ley del paso. El paso sigue luego un calendario coseno, de α0 hasta 0,1α0. Otros dos mecanismos completan el dispositivo: el relanzamiento de clusters ‘muertos’, es decir, aquellos que caen bajo un umbral de tamaño y son relanzados dividiendo un cluster grande, y una finalización sobre la media exacta de la última época.
Según los autores, el rendimiento anunciado es de 10 a 45 veces más rápido en GPU que Flash-KMeans, y de 8 a 15 veces más rápido en CPU que Faiss k-means. En el benchmark VIBE, los 11 conjuntos de datos de embeddings necesitaron entre 1,6 y 2,4 épocas. Para la escalabilidad, el conjunto DINO10B, compuesto por 10 mil millones de embeddings de 1.024 dimensiones, se distribuyó en 16,7 millones de clusters en 2,5 épocas. Los resultados en GPU se obtuvieron en H100. Para configuraciones de 16 millones de centroides, los acumuladores en float32 alcanzan 64 GiB, lo que obliga a distribuir los centroides en varias GPU.
Una demostración en un solo hilo de CPU, publicada en el hilo de anuncio, da 4,39 s para Lloyd en 25 épocas, frente a 0,43 s para e-means en 2,2 épocas. e-means se distribuye bajo licencia MIT, a través de FAISS.
