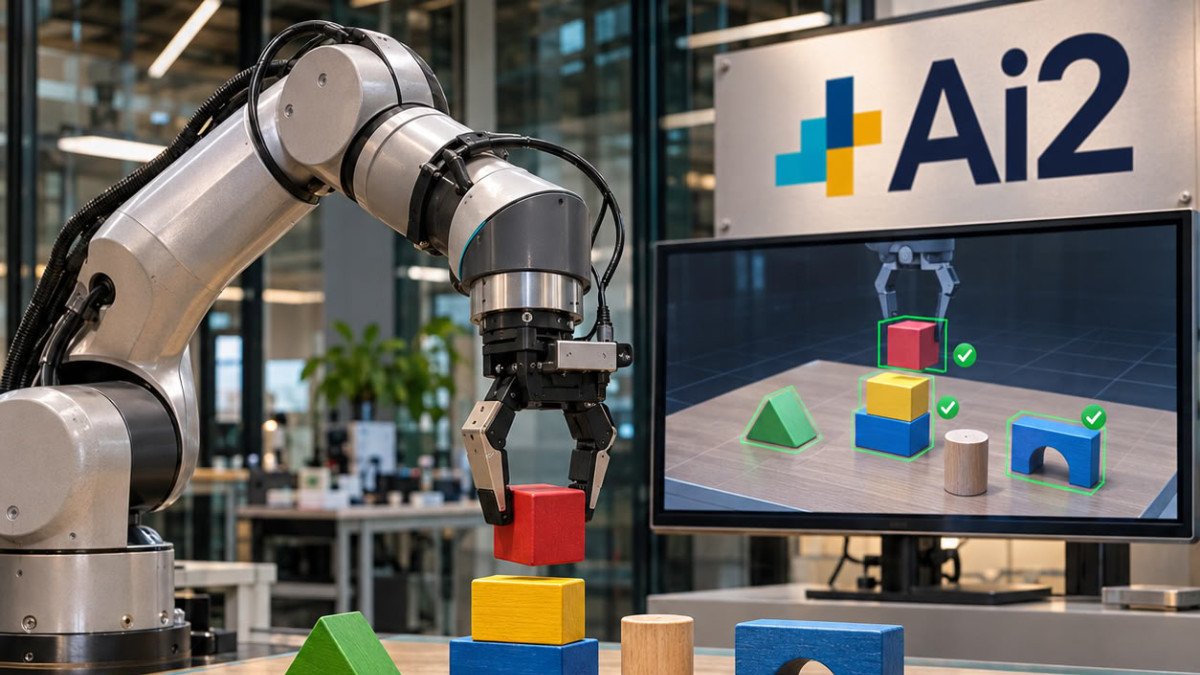

Ai2は、ロボティクス研究のための制御された環境を作成するためのフレームワーク「FoundationWorlds」を発表し、その最初の例としてToyBlocksを公開した。これは、ロボットアームとテーブル上のブロックを中心に構築されたオープンなシミュレーションフレームワークである。
洗濯物を畳んだり部品を仕分けたりするロボットの最近のデモは、しばしば限定的であり、ロボットが何を学習したか、なぜ失敗したかを十分に説明しない。そのため研究者は、トレーニングデータやモデル設計を変更し、テストを繰り返し、失敗の原因を特定できる環境を必要としている。各FoundationWorldは、シミュレートされた世界、タスクとデモの自動生成ツール、および時間経過に伴うロボットの動作測定を組み合わせたものである。
テレオペレーションなしでのデモ生成
ToyBlocksは、人が遠隔でロボットを操作するテレオペレーションを用いずに、シミュレーション内でタスクを遂行するロボットの記録であるデモを自動的に生成する。ブロックを押したり、掴まずにひっくり返したりするような短期間のスキルを学習するために、システムは強化学習(試行錯誤によるRL)とモーションプランニングを組み合わせる。トレーニングは、Nvidiaのシミュレーション内ロボット学習用オープンソースフレームワークであるIsaac Labで行われる。
タスク・モーション・プランナー(TAMP)は、その後、これらのスキルを連鎖させてタスクを解決する。Ai2によれば、数百の計画を単一のGPU上で並列実行でき、最大24倍のリアルタイム速度が可能だという。
モデルの汎化性能のテスト
言語による指示と画像をロボットの動作に変換する視覚-言語-動作(VLA)モデルは、大規模データセットでの事前学習により迅速に汎化することが期待されている。しかし、利用可能な研究結果は依然として矛盾している。Ai2は、ManiFlow、π0.5、MolmoAct 2を用いたテストでは初期状態での汎化性能が低く、その後チームがこれらの結果を改善したと述べている。同社は、この問題はまだ解決には程遠いと判断している。
別の側面では、視覚-言語モデルであるMolmo 2が高レベルプランナーとして、ManiFlowが実行エージェントとして機能する。ブロックの塔で「Ai2」と綴るタスクでは、最初は文字が見えない場合があり、エージェントはまず情報を探す必要がある。
自ら実験を行うエージェント
別の一連の試験では、Ai2はClaude Opus 5.5を使用し、AIアプリケーションとツール間の接続標準であるModel Context Protocol(MCP)を介してToyBlocksのスキルを公開している。情報源によると、エージェントが自らの経験から独自のスキル記述を作成できるようにした場合、成功率はデフォルトの記述での24%から63%に向上し、人間の専門家による記述での36%を上回った。
別のテストは、ロボットの動作に基づいてシーンの変化を予測するアクション駆動型世界モデルに関するものだ。スキルごとに900の軌跡において、50億パラメータのビデオ予測モデルであるWan 2.2が、ブロックの動きとタスクの結果を最もよく予測した。Ai2は、このモデルで生成された100の軌跡により、未知の領域におけるポリシーの成功率が19%から78%に向上したと付け加えている。
シミュレータから実機アームへ
Robotiqグリッパーを装備したFranka FR3アームを用い、30のシーン構成において、ManiFlowは個別スキルでシミュレーション80.0%、実世界81.1%の成功率を達成した。階層型システムMolmo 2 + ManiFlowは、シミュレーションで55.5%(200中111)、実環境で50.0%(30中15)の成功率に達した。Ai2は、統計的信頼性を確立するにはさらなる試験が必要だと述べている。
公開された初期データには、85,336件の長期視野デモ、約1,600時間のロボット実行時間、1億4,400万枚の画像が含まれている。より大規模なデータセットとより多くのスキルを備えた第2版が数週間以内に目標とされている。
