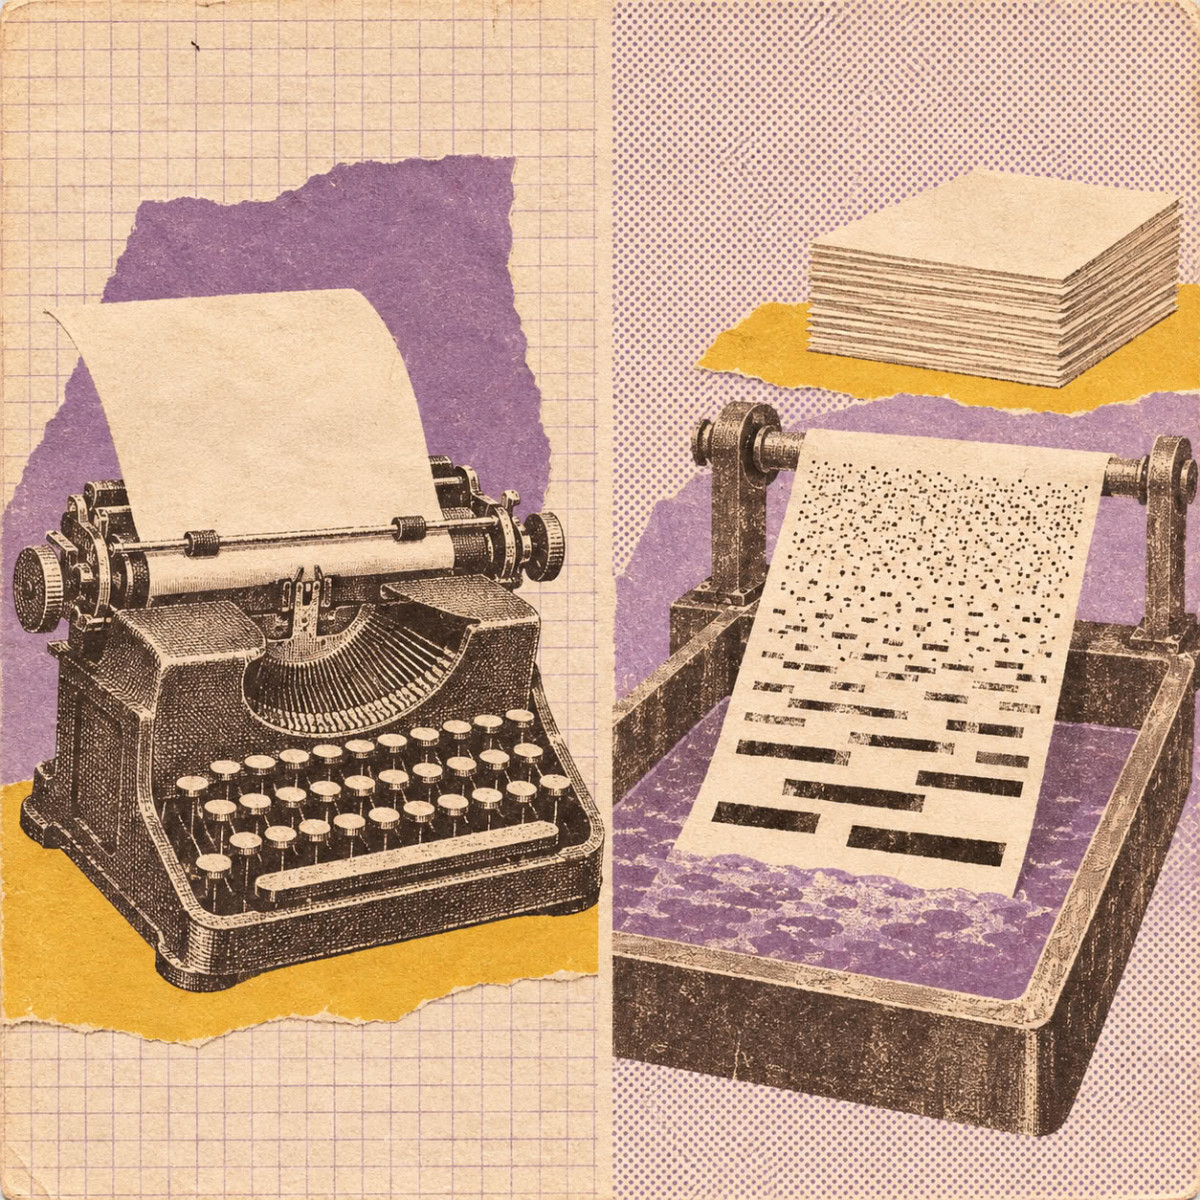

拡散言語モデルは、マスクされた系列を徐々に洗練させることでテキストを生成する。一方、GPTモデルはトークンを一つずつ生成する。この技術は画像生成では既知であったが、2025年にLLaDA、Mercury、Gemini Diffusion、そして2026年にGoogleのDiffusionGemmaが推論速度の速さで注目を集めた。
テキスト生成の二つの方法
GPTモデルは自己回帰的である。すなわち、既に生成されたトークンから次のトークンを推定する。学習時には複数の位置を並列処理できるが、推論時には各トークンが前のトークンを待たねばならず、逐次依存性の問題が生じる。ここで言うトークンとは、モデルが扱うテキストの単位(多くの場合単語の断片)を指す。
一方、マスク拡散モデルは、(未知の位置)で完全に埋められた系列から始め、徐々に単語を明らかにしていく。各ステップで複数の単語を選択でき、必ずしも左から右への順序に従う必要はない。 »The cat sat down »という文の場合、自己回帰モデルは各ターンで一語ずつ追加するが、拡散モデルは一度に複数の位置を埋め、完全な文が得られるまで系列を洗練する。両アプローチともトランスフォーマーアーキテクチャを使用するが、その目的と推論手順は異なる。前者は系列を延長し、後者は系列を洗練する。
拡散モデルの仕組み
画像の場合、拡散は二つのプロセスに依存する。順方向プロセスはクリーンデータに徐々にノイズを加えて劣化させ、逆方向プロセスはニューラルネットワークにその劣化を元に戻すことを学習させる(通常は平均二乗誤差関数を用いる)。サンプリング時、この修正は多数のステップを経て行われる。
テキストの場合、トークンはピクセルのような連続値ではなく離散的な識別子であるため、難しさが生じる。劣化はトークンをに置き換えることで行われ、各トークンは0から1の範囲の破損レベルに等しい確率でマスクされる。推論時、サンプラーはマスクされた位置を初期化し、未解決の各位置に対して語彙上の分布を予測し、どの予測を保持するかを決定する。この選択は通常、信頼度の尺度に基づく。このプロセスは系列全体が埋まるまで繰り返される。一部のサンプラーは、既に確定したトークンを再マスクすることもでき、これはリビジョンと呼ばれるが、すべてのモデルに共通する特性ではない。
さらに、これらのモデルは、ノイズ除去中の系列内で双方向アテンションを使用する。一方、GPTは前の位置しか見ない。したがって、マスクされた単語は前後の文脈に依存でき、これは編集や構造化された生成に役立つ。著者によれば、GPUが位置を効率的に並列処理する場合、拡散は実遅延でも優位に立つ可能性があるが、品質が決定的要因となる。自己回帰モデルは、推論やコードに関する一部のベンチマークで依然として優れた性能を示す。DiffusionGemma 26BとGemma 26Bの比較結果はモデルカードに記載されており、確率的ノイズ除去拡散モデルに関する参照論文がこのアプローチの起源である。
残された課題
トークン間の依存関係が最初の障害である。二つの位置が並列にサンプリングされると、それぞれが単独では妥当に見えても互いに矛盾する可能性があり、より多くのノイズ除去ステップや結合サンプリングが必要になる場合がある。サンプリングバジェットも別の問題を提起する。ステップ数を減らすと遅延は改善するが品質が低下するリスクがあり、一方でパス数を増やすと速度面での利点が失われる可能性がある。
可変長応答も、固定サイズのマスクグリッドにとって自然ではないが、ブロック単位のアプローチやより柔軟な方法がこの課題に対処しようとしている。最後に、キー・バリューキャッシュ(KVキャッシュ)は、既に行った計算を記憶することで生成を高速化するが、双方向の洗練によってブロック全体の表現が変更される可能性があるため、その活用がより困難になる。完了したブロックを固定するブロックデコーディングは、この問題を回避するのに役立つ。
