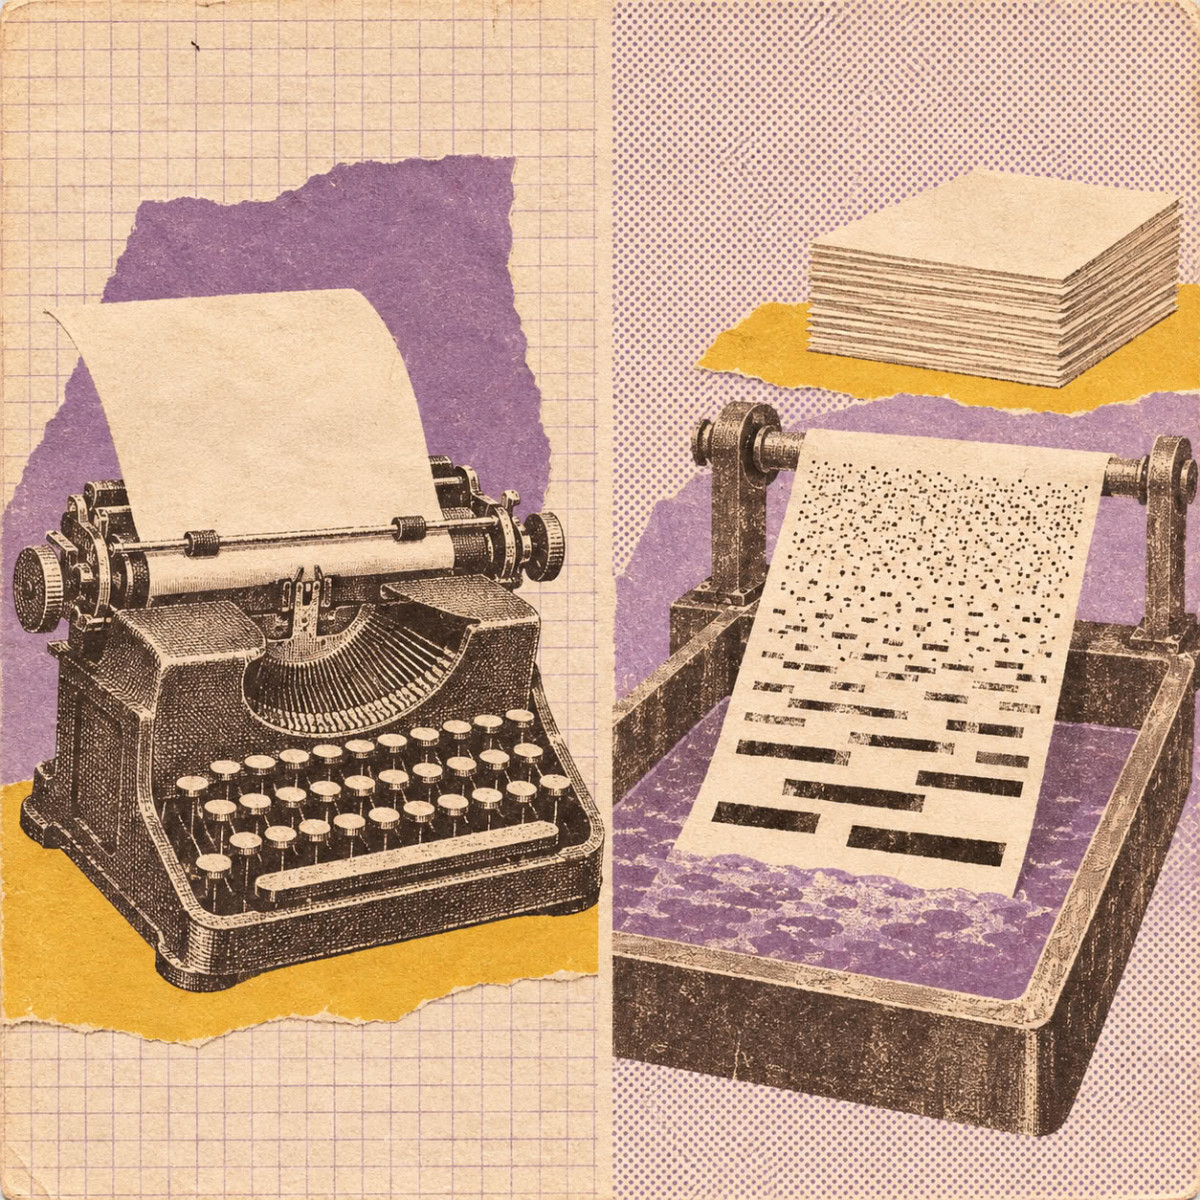

تنتج نماذج اللغة بالانتشار نصًا من خلال تحسين تسلسل مُقنَّع تدريجيًا، بينما تولد نماذج GPT رمزًا تلو الآخر. هذه التقنية، المعروفة بالفعل في مولدات الصور، جذبت انتباه المجتمع في عام 2025 مع LLaDA وMercury وGemini Diffusion، ثم في عام 2026 مع DiffusionGemma من جوجل، لا سيما لسرعة الاستدلال فيها.
طريقتان لتوليد النص
نماذج GPT هي ذاتية الانحدار: فهي تُقدِّر الرمز التالي بناءً على الرموز المُنتَجة سابقًا. أثناء التدريب، يمكن معالجة عدة مواضع بالتوازي، لكن عند الاستدلال، يجب أن ينتظر كل رمز الرمز السابق، مما يخلق مشكلة الاعتماد التسلسلي. يشير الرمز هنا إلى وحدة نصية، غالبًا جزء من كلمة، يتعامل معها النموذج.
على العكس من ذلك، ينطلق نموذج الانتشار المقنَّع من تسلسل مملوء بالكامل بـ ، أي مواضع مجهولة، ويكشف الكلمات تدريجيًا. يمكنه اختيار عدة كلمات في كل خطوة، دون الالتزام بالضرورة بالترتيب من اليسار إلى اليمين. بالنسبة لجملة « The cat sat down »، يضيف النموذج الذاتي الانحدار كلمة واحدة في كل دورة، بينما يملأ نموذج الانتشار عدة مواضع في وقت واحد ويحسن التسلسل حتى الحصول على الجملة الكاملة. يستخدم كلا النهجين معماريات المحولات، لكن أهدافهما وإجراءات الاستدلال تختلف: الأول يمتد بتسلسل، والثاني يحسنه.
كيف تعمل نماذج الانتشار
بالنسبة للصور، يعتمد الانتشار على عمليتين. العملية المباشرة تُتلف البيانات النظيفة بإضافة ضوضاء تدريجيًا، بينما العملية العكسية تُدرِّب شبكة عصبية على إزالة هذا التلف، عادةً باستخدام دالة خطأ متوسط المربعات. أثناء أخذ العينات، تتم عملية التصحيح هذه في خطوات عديدة.
يشكل النص صعوبة، لأن الرموز هي معرفات منفصلة وليست قيمًا مستمرة مثل البكسلات. لذلك يتم التلف باستبدال الرموز بـ ، حيث يتم إخفاء كل رمز باحتمال يساوي مستوى فساد يتراوح بين 0 و1. عند الاستدلال، يقوم جهاز أخذ العينات بتهيئة المواضع المقنَّعة، ويتنبأ بتوزيع على المفردات لكل موضع غير محلول، ثم يقرر أي تنبؤات يحتفظ بها. يعتمد هذا الاختيار عادةً على مقياس للثقة. تتكرر العملية حتى ملء التسلسل بالكامل. يمكن لبعض أجهزة أخذ العينات أيضًا إعادة إخفاء رموز تم التحقق منها بالفعل، وهي عملية تسمى المراجعة، وهي ليست خاصية مشتركة بين جميعها.
تستخدم هذه النماذج أيضًا انتباهًا ثنائي الاتجاه داخل التسلسل قيد إزالة الضوضاء، بينما يرى GPT المواضع السابقة فقط. وبالتالي يمكن لكلمة مقنَّعة الاعتماد على السياق الذي يسبقها والذي يليها، مما يفيد في التحرير والتوليد المنظم. وفقًا للمؤلف، يمكن للانتشار أيضًا التفوق في زمن الاستجابة الفعلي عندما تعالج وحدات معالجة الرسوميات المواضع بكفاءة بالتوازي، لكن الجودة تظل حاسمة: تظل النماذج الذاتية الانحدار أكثر أداءً في بعض معايير الاختبار للاستدلال والبرمجة. تظهر نتائج DiffusionGemma 26B مقارنة بـ Gemma 26B في ورقة النموذج، حيث أن المقال المرجعي حول نماذج الانتشار الاحتمالية لإزالة الضوضاء هو أصل هذا النهج.
التحديات المفتوحة المتبقية
تشكل الاعتمادات المتبادلة بين الرموز العقبة الأولى. إذا تم أخذ عينات من موضعين بالتوازي، قد يبدو كل منهما معقولًا بمعزل عن الآخر بينما يكون غير متسق مع الآخر، مما قد يتطلب المزيد من خطوات إزالة الضوضاء أو أخذ عينات مقترنة. يطرح ميزانية أخذ العينات سؤالًا آخر: تقليل عدد الخطوات يحسن زمن الاستجابة لكنه قد يخفض الجودة، بينما تكرار الجولات قد يمحو ميزة السرعة.
كما أن الطول المتغير للإجابات ليس طبيعيًا لشبكة مقنَّعة ذات حجم ثابت، حتى لو كانت النهجات المعتمدة على الكتل أو الأكثر مرونة تسعى لمعالجته. أخيرًا، يصبح ذاكرة التخزين المؤقت مفتاح-قيمة (KV)، التي تسرع التوليد بتذكر الحسابات المنجزة بالفعل، أكثر صعوبة في الاستفادة منها، لأن التحسين ثنائي الاتجاه قد يعدل تمثيلات كتلة كاملة. يساعد فك الترميز بالكتل، الذي يجمد الكتل المكتملة، في تجاوز هذه المشكلة.
