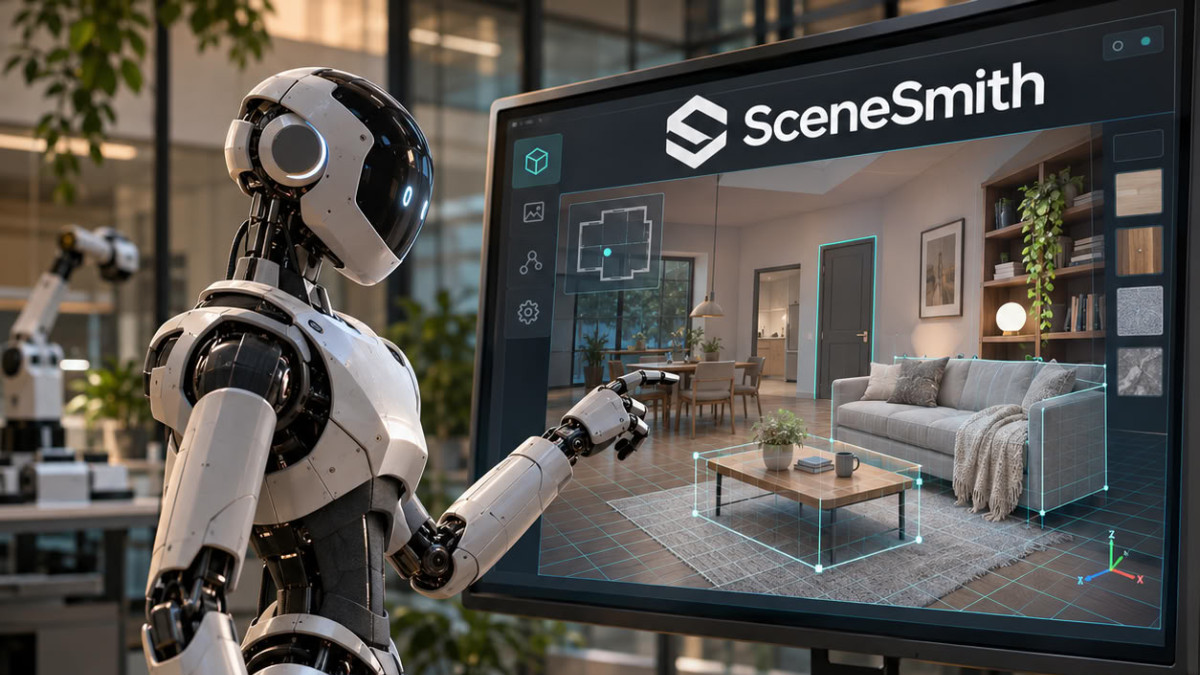

Forscher des MIT CSAIL und des Toyota Research Institute haben SceneSmith vorgestellt, ein System, das drei KI-Agenten nutzt, um 3D-Innenraumszenen für das Training von Robotern zu erstellen. Diese virtuellen Umgebungen ermöglichen es Maschinen, zu üben und verschiedene Wege zur Aufgabenerfüllung auszuprobieren, bevor sie eingesetzt werden. Die Arbeit wurde als Spotlight auf der International Conference on Machine Learning 2026 präsentiert.
Das Haupthindernis für allgemeine Robotik bleibt die Daten. Wie Menschen lernen Roboter vor allem durch Erfahrung, aber einer Maschine physisch eine große Anzahl von Aktionen an verschiedenen Orten beizubringen, erfordert enormen Aufwand und Zeit. Russ Tedrake, Professor am MIT und leitender Forscher am CSAIL, erinnert daran, dass Simulation ein natürlicher Ansatz ist. Die Physik-Engines von Simulatoren haben große Fortschritte gemacht, aber es bleibt schwierig, Inhalte zu erzeugen, die reichhaltig und vielfältig genug sind, um die Komplexität der realen Welt widerzuspiegeln.
Drei Agenten für einen Raum
KI-Agenten, semi-autonome Programme, die klar definierte Aufgaben erfüllen können, können genau bei der Erstellung dieser Szenen helfen. SceneSmith setzt auf drei Agenten, die Objekte, Wände und das Gesamterscheinungsbild einer 3D-Szene zusammenstellen. Jeder basiert auf einem Vision-Language-Modell (VLM, ein System, das sowohl Text als auch Bilder verarbeiten kann), in diesem Fall GPT-5.2 von OpenAI, das in der Quelle als eines der fortschrittlichsten Modelle auf diesem Gebiet vorgestellt wird.
Der Ablauf folgt einer dreistufigen Kette. Ein « Designer »-Agent generiert die Elemente der Szene, ein « Critic »-Agent beurteilt, ob das Ergebnis realistisch aussieht, und ein « Orchestrator »-Agent verwaltet den Austausch zwischen den beiden und entscheidet, wann der Entwurf abgeschlossen ist. Nach Abschluss dieser Zusammenarbeit kann die Szene direkt in eine Physik-Simulationssoftware geladen werden. Die Agenten gehen dabei schrittweise vor: Möbel, an Wänden platzierte Objekte, dann an der Decke, und schließlich Objekte, die der Roboter manipulieren kann, wie Schränke, die er öffnen und schließen kann.
Nicholas Pfaff, Doktorand in Elektrotechnik und Informatik am MIT und Hauptautor der Arbeit zusammen mit Russ Tedrake, beschreibt ein Ergebnis, das ihn überrascht: « Wir haben festgestellt, dass das System 3D-Szenen auf die Art eines menschlichen Designers konstruieren kann. » Seiner Ansicht nach hat das Team über 1.300 Szenen generiert, mit « insanely creative » (wahnsinnig kreativen) und vielfältigen Anordnungen, die dem System nicht explizit in seinen Anweisungen vorgegeben waren.
Laut den Forschern enthalten diese Szenen bis zu sechsmal mehr Objekte pro Raum als frühere Methoden, was sie nützlich macht, um einem Roboter beizubringen, eine Tasse ins Spülbecken zu stellen, Früchte auf Teller zu arrangieren oder eine Dose von einem Regal auf einen Tisch zu bewegen.
Ein Realismus auf dem Prüfstand
Um den Realismus dieser virtuellen Welten zu überprüfen, testeten die Forscher eine vortrainierte Policy, also einen KI-Controller, der größtenteils auf realen Daten trainiert wurde und noch nie eine SceneSmith-Szene gesehen hatte. Als die Anweisung lautete, « den Apfel aus der Schüssel zu nehmen und auf das Schneidebrett zu legen », erledigte der simulierte Roboter die Aufgabe. Die Teams steuerten auch ferngesteuerte Roboter in diesen Räumen, um Schränke zu öffnen, Flaschen wegzuräumen und von Raum zu Raum zu navigieren.
In einem anderen Test wurden 100 einzigartige Räume generiert und ein VLM-Agent bewertete die Aktionspläne des Roboters, die in vielen Fällen als fehlerhaft eingestuft wurden. Menschen stimmten diesen Urteilen in über 99 % der Fälle zu, so die Forscher, was es ermöglichen könnte, fehlerhafte Ansätze vor ihrem Einsatz in der Simulation auszuschließen. Mehr als 200 Nutzer bewerteten die visuellen Darstellungen zudem in über 90 % der Fälle als realistischer als die von konkurrierenden Systemen.
Das System hat jedoch einen Zeitaufwand. Es kann mehrere Stunden dauern, um eine einzige Szene zu produzieren, da die Agenten jedes Objekt genau erstellen und prüfen. Eine erhöhte Rechenleistung könnte die Effizienz verbessern, und das Team erwägt, das System auf verformbare Objekte wie Schwämme auszuweiten, falls umfangreiche 3D-Bibliotheken verfügbar werden.
