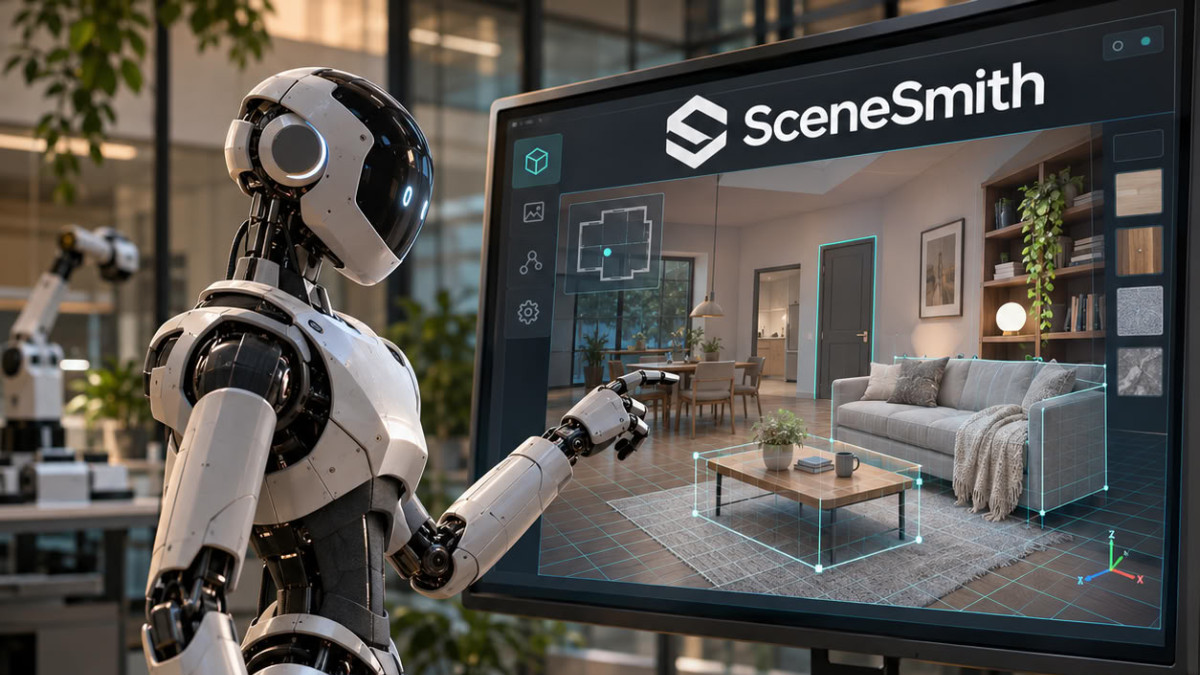

Investigadores del MIT CSAIL y del Toyota Research Institute han presentado SceneSmith, un sistema que emplea tres agentes de IA para construir escenas 3D de interiores destinadas al entrenamiento de robots. Estos entornos virtuales permiten a las máquinas practicar y probar diferentes formas de realizar una tarea antes de ser desplegadas. El trabajo se presentó como spotlight en la conferencia International Conference on Machine Learning 2026.
El principal obstáculo para la robótica generalista sigue siendo la donnée. Al igual que los humanos, los robots aprenden principalmente mediante la experiencia, pero enseñar físicamente a una máquina, para un gran número de acciones y lugares, requiere mucho trabajo y tiempo. Russ Tedrake, profesor del MIT e investigador principal en CSAIL, recuerda que la simulación constituye una vía natural. Los motores físicos de los simuladores han avanzado mucho, pero sigue siendo difícil producir contenidos lo suficientemente ricos y variados para reflejar la complejidad del mundo real.
Tres agentes para una habitación
Los agentes de IA, programas semiautónomos capaces de realizar tareas bien definidas, pueden ayudar precisamente a producir estos escenarios. SceneSmith se basa en tres agentes que ensamblan los objetos, las paredes y el aspecto general de una escena en 3D. Cada uno se apoya en un modelo visión-lenguaje (VLM, un sistema capaz de procesar tanto texto como imágenes), en este caso GPT-5.2 de OpenAI, presentado en la fuente como uno de los modelos más avanzados del campo.
El funcionamiento sigue una cadena en tres pasos. Un agente «designer» genera los elementos de la escena, un agente «critic» juzga si el resultado parece realista, y un agente «orchestrator» gestiona los intercambios entre los dos y decide cuándo el diseño está terminado. Una vez finalizada esta colaboración, la escena puede cargarse directamente en un software de simulación física. Los agentes proceden así paso a paso: mobiliario, objetos colocados en las paredes y luego en el techo, y finalmente objetos que el robot puede manipular, como armarios que puede abrir y cerrar.
Nicholas Pfaff, estudiante de doctorado en ingeniería eléctrica e informática en el MIT y autor principal del artículo junto a Russ Tedrake, describe un resultado que le sorprende: «Hemos comprobado que el sistema puede construir escenas 3D al estilo de un diseñador humano». Según él, el equipo ha generado más de 1.300 escenas, con disposiciones «insanely creative» (de una creatividad desbordante) y variadas, que el sistema no había recibido explícitamente en sus instrucciones.
Según los investigadores, estas escenas contienen hasta seis veces más objetos por habitación que los métodos anteriores, lo que las hace útiles para enseñar a un robot a colocar una taza en el fregadero, disponer frutas en platos o mover una lata de una estantería a una mesa.
Un realismo a prueba
Para verificar el realismo de estos mundos virtuales, los investigadores probaron una política preentrenada, es decir, un controlador de IA entrenado en gran parte con datos reales, que nunca había visto una escena de SceneSmith. Cuando se le pidió que «tomara la manzana del bol y la colocara en la tabla de cortar», el robot simulado completó la tarea. Los equipos también pilotaron robots a distancia en estos espacios para abrir armarios, guardar botellas y pasar de una habitación a otra.
En otra prueba, se generaron 100 espacios únicos y un agente VLM evaluó los planes de acción del robot, considerados deficientes en muchos casos. Los humanos coincidieron con estos veredictos en más del 99 % de los casos, según los investigadores, lo que podría permitir descartar en simulación los enfoques defectuosos antes de su despliegue. Más de 200 usuarios consideraron además que los visuales eran más realistas que los de los sistemas competidores en más del 90 % de los casos.
El sistema tiene sin embargo un coste en tiempo. Pueden necesitarse varias horas para producir una sola escena, ya que los agentes crean y examinan cada objeto de cerca. Una mayor potencia de cálculo podría mejorar la eficiencia, y el equipo contempla ampliar el sistema a objetos deformables, como esponjas, si llegaran a estar disponibles amplias bibliotecas 3D.
