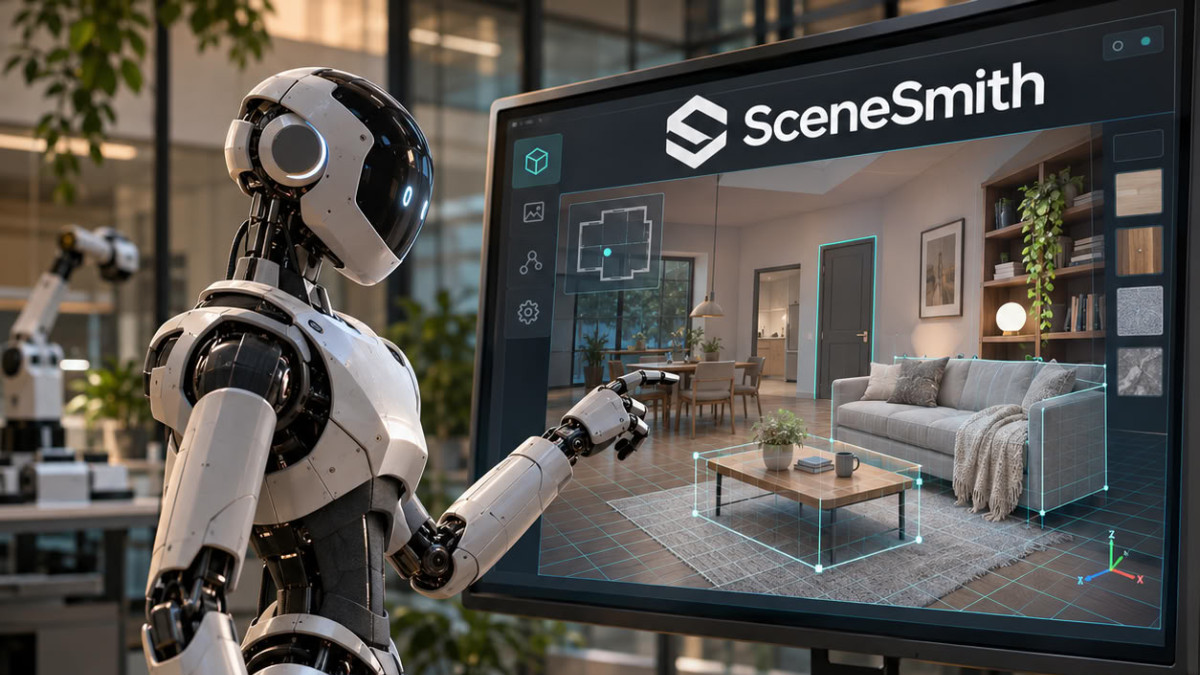

Investigadores do MIT CSAIL e do Toyota Research Institute apresentaram o SceneSmith, um sistema que utiliza três agentes de IA para construir cenas 3D de interiores destinadas ao treino de robôs. Estes ambientes virtuais permitem que as máquinas pratiquem e testem diferentes formas de realizar uma tarefa antes de serem colocadas em serviço. O trabalho foi apresentado como spotlight na conferência International Conference on Machine Learning de 2026.
O principal obstáculo à robótica de propósito geral continua a ser os dados. Tal como os humanos, os robôs aprendem principalmente através da experiência, mas ensinar fisicamente uma máquina, para um grande número de ações e locais, exige muito trabalho e tempo. Russ Tedrake, professor do MIT e investigador principal no CSAIL, recorda que a simulação constitui uma via natural. Os motores físicos dos simuladores evoluíram muito, mas continua a ser difícil produzir conteúdos suficientemente ricos e variados para refletir a complexidade do mundo real.
Três agentes para uma divisão
Os agentes de IA, programas semi-autónomos capazes de realizar tarefas bem definidas, podem precisamente ajudar a produzir estes cenários. O SceneSmith baseia-se em três agentes que montam os objetos, as paredes e o aspeto geral de uma cena em 3D. Cada um deles recorre a um modelo visão-linguagem (VLM, um sistema capaz de processar texto e imagens), neste caso o GPT-5.2 da OpenAI, apresentado na fonte como um dos modelos mais avançados da área.
O funcionamento segue uma cadeia em três etapas. Um agente «designer» gera os elementos da cena, um agente «critic» avalia se o resultado parece realista, e um agente «orchestrator» gere as trocas entre os dois e decide quando a conceção está terminada. Uma vez concluída esta colaboração, a cena pode ser carregada diretamente num software de simulação física. Os agentes procedem assim passo a passo: mobiliário, objetos colocados nas paredes e depois no teto, e finalmente objetos que o robô pode manipular, como armários que pode abrir e fechar.
Nicholas Pfaff, doutorando em engenharia elétrica e informática no MIT e autor principal do artigo com Russ Tedrake, descreve um resultado que o surpreende: «Verificámos que o sistema pode construir cenas 3D à maneira de um designer humano.» Segundo ele, a equipa gerou mais de 1300 cenas, com arranjos «insanely creative» (de uma criatividade louca) e variados, que o sistema não tinha recebido explicitamente nas suas instruções.
De acordo com os investigadores, estas cenas contêm até seis vezes mais objetos por divisão do que os métodos anteriores, o que as torna úteis para ensinar um robô a colocar uma chávena no lava-louça, dispor frutas em pratos ou mover uma lata de uma prateleira para uma mesa.
Um realismo à prova
Para verificar o realismo destes mundos virtuais, os investigadores testaram uma política pré-treinada, ou seja, um controlador de IA treinado maioritariamente com dados reais, que nunca tinha visto uma cena do SceneSmith. Quando lhe foi pedido para «apanhar a maçã da taça e colocá-la na tábua de cortar», o robô simulado cumpriu a tarefa. As equipas também pilotaram robôs remotamente nestes espaços para abrir armários, arrumar garrafas e passar de uma divisão para outra.
Noutro teste, foram gerados 100 espaços únicos e um agente VLM avaliou os planos de ação do robô, considerados deficientes em muitos casos. Os humanos concordaram com estes veredictos em mais de 99% dos casos, segundo os investigadores, o que poderia permitir descartar em simulação as abordagens defeituosas antes da sua implementação. Mais de 200 utilizadores consideraram ainda os visuais mais realistas do que os dos sistemas concorrentes em mais de 90% dos casos.
O sistema tem, no entanto, um custo em tempo. Pode demorar várias horas para produzir uma única cena, pois os agentes criam e examinam cada objeto de perto. Uma maior capacidade de cálculo poderia melhorar a eficiência, e a equipa pondera estender o sistema a objetos deformáveis, como esponjas, se vastas bibliotecas 3D se tornarem disponíveis.
