A Google apresentou na quarta-feira, 28 de outubro, o Gemini 4 Carbon, o seu novo modelo de topo, duas semanas após a abertura pública do Argon. Apresenta-se como número 1 num índice de referência, mas apenas por um ponto, e foca-se sobretudo na cibersegurança e em tarefas que duram dias. Por agora, apenas alguns especialistas em cibersegurança têm acesso.
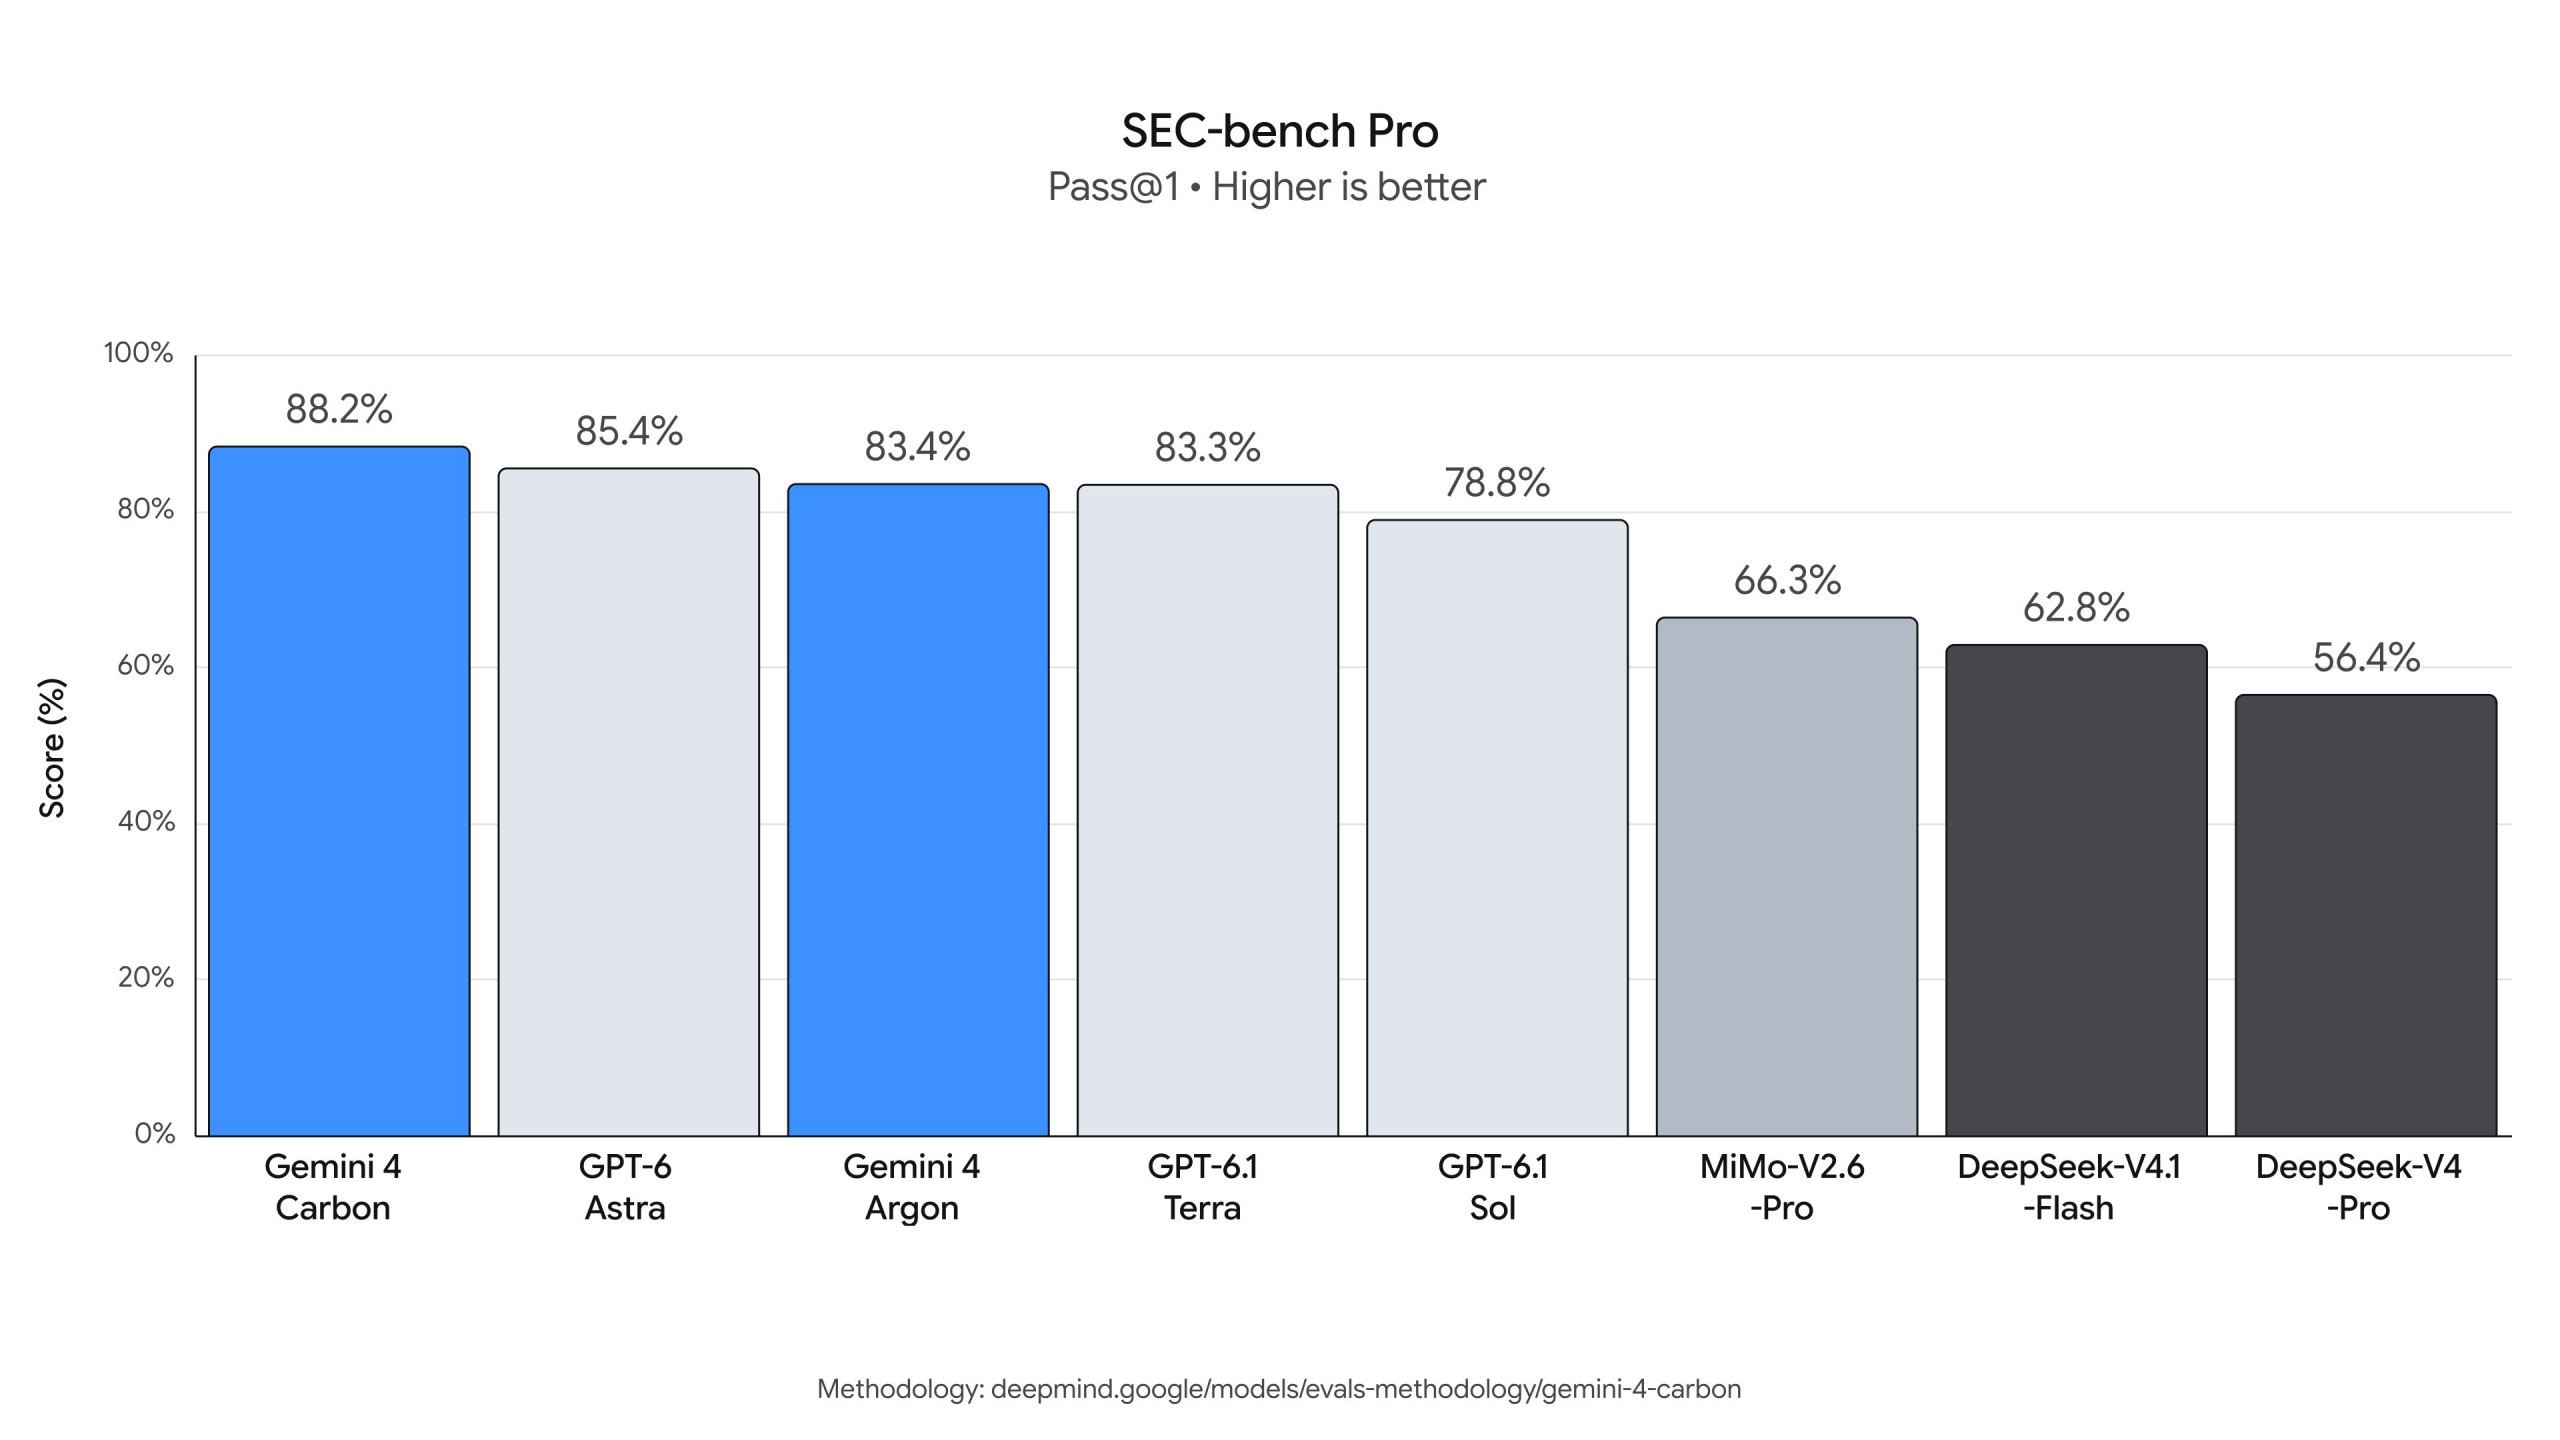
Uma pontuação de 88,2 % no SEC-bench Pro, um teste de deteção de vulnerabilidades: a Google destaca este número no anúncio do Gemini 4 Carbon, assinado por Koray Kavukcuoglu, vice-presidente sénior da Google DeepMind e arquiteto-chefe de IA na Google. O modelo chega duas semanas após a abertura pública do Argon, a 13 de outubro. A Google explica este ritmo com um trabalho em que os investigadores e os modelos fazem avançar as capacidades em conjunto, e mais depressa.
Sundar Pichai partilhou pessoalmente o anúncio no X: lá recorda que a Google tinha avisado que lançaria os seus modelos a intervalos regulares, e repete as três pontuações de cibersegurança.
Contudo, o Carbon não está aberto a todos. Esta semana, a Google disponibiliza-o a um pequeno grupo de especialistas em cibersegurança, depois alargará o acesso a outros parceiros de confiança através do programa Fairwind, lançado a 2 de setembro. As regras publicadas para o Argon limitam o acesso às equipas internas de cibersegurança, resposta a incidentes e testes de intrusão das organizações admitidas. Tinha mais de 650 parceiros no lançamento. Os programadores, as empresas e o público em geral virão depois, assim que possível, sem data anunciada. A Google diz ainda estar a participar no processo voluntário de testes prévios do governo norte-americano.
Gemini 4 Carbon ultrapassa Opus 5.5 por um único ponto no Artificial Analysis
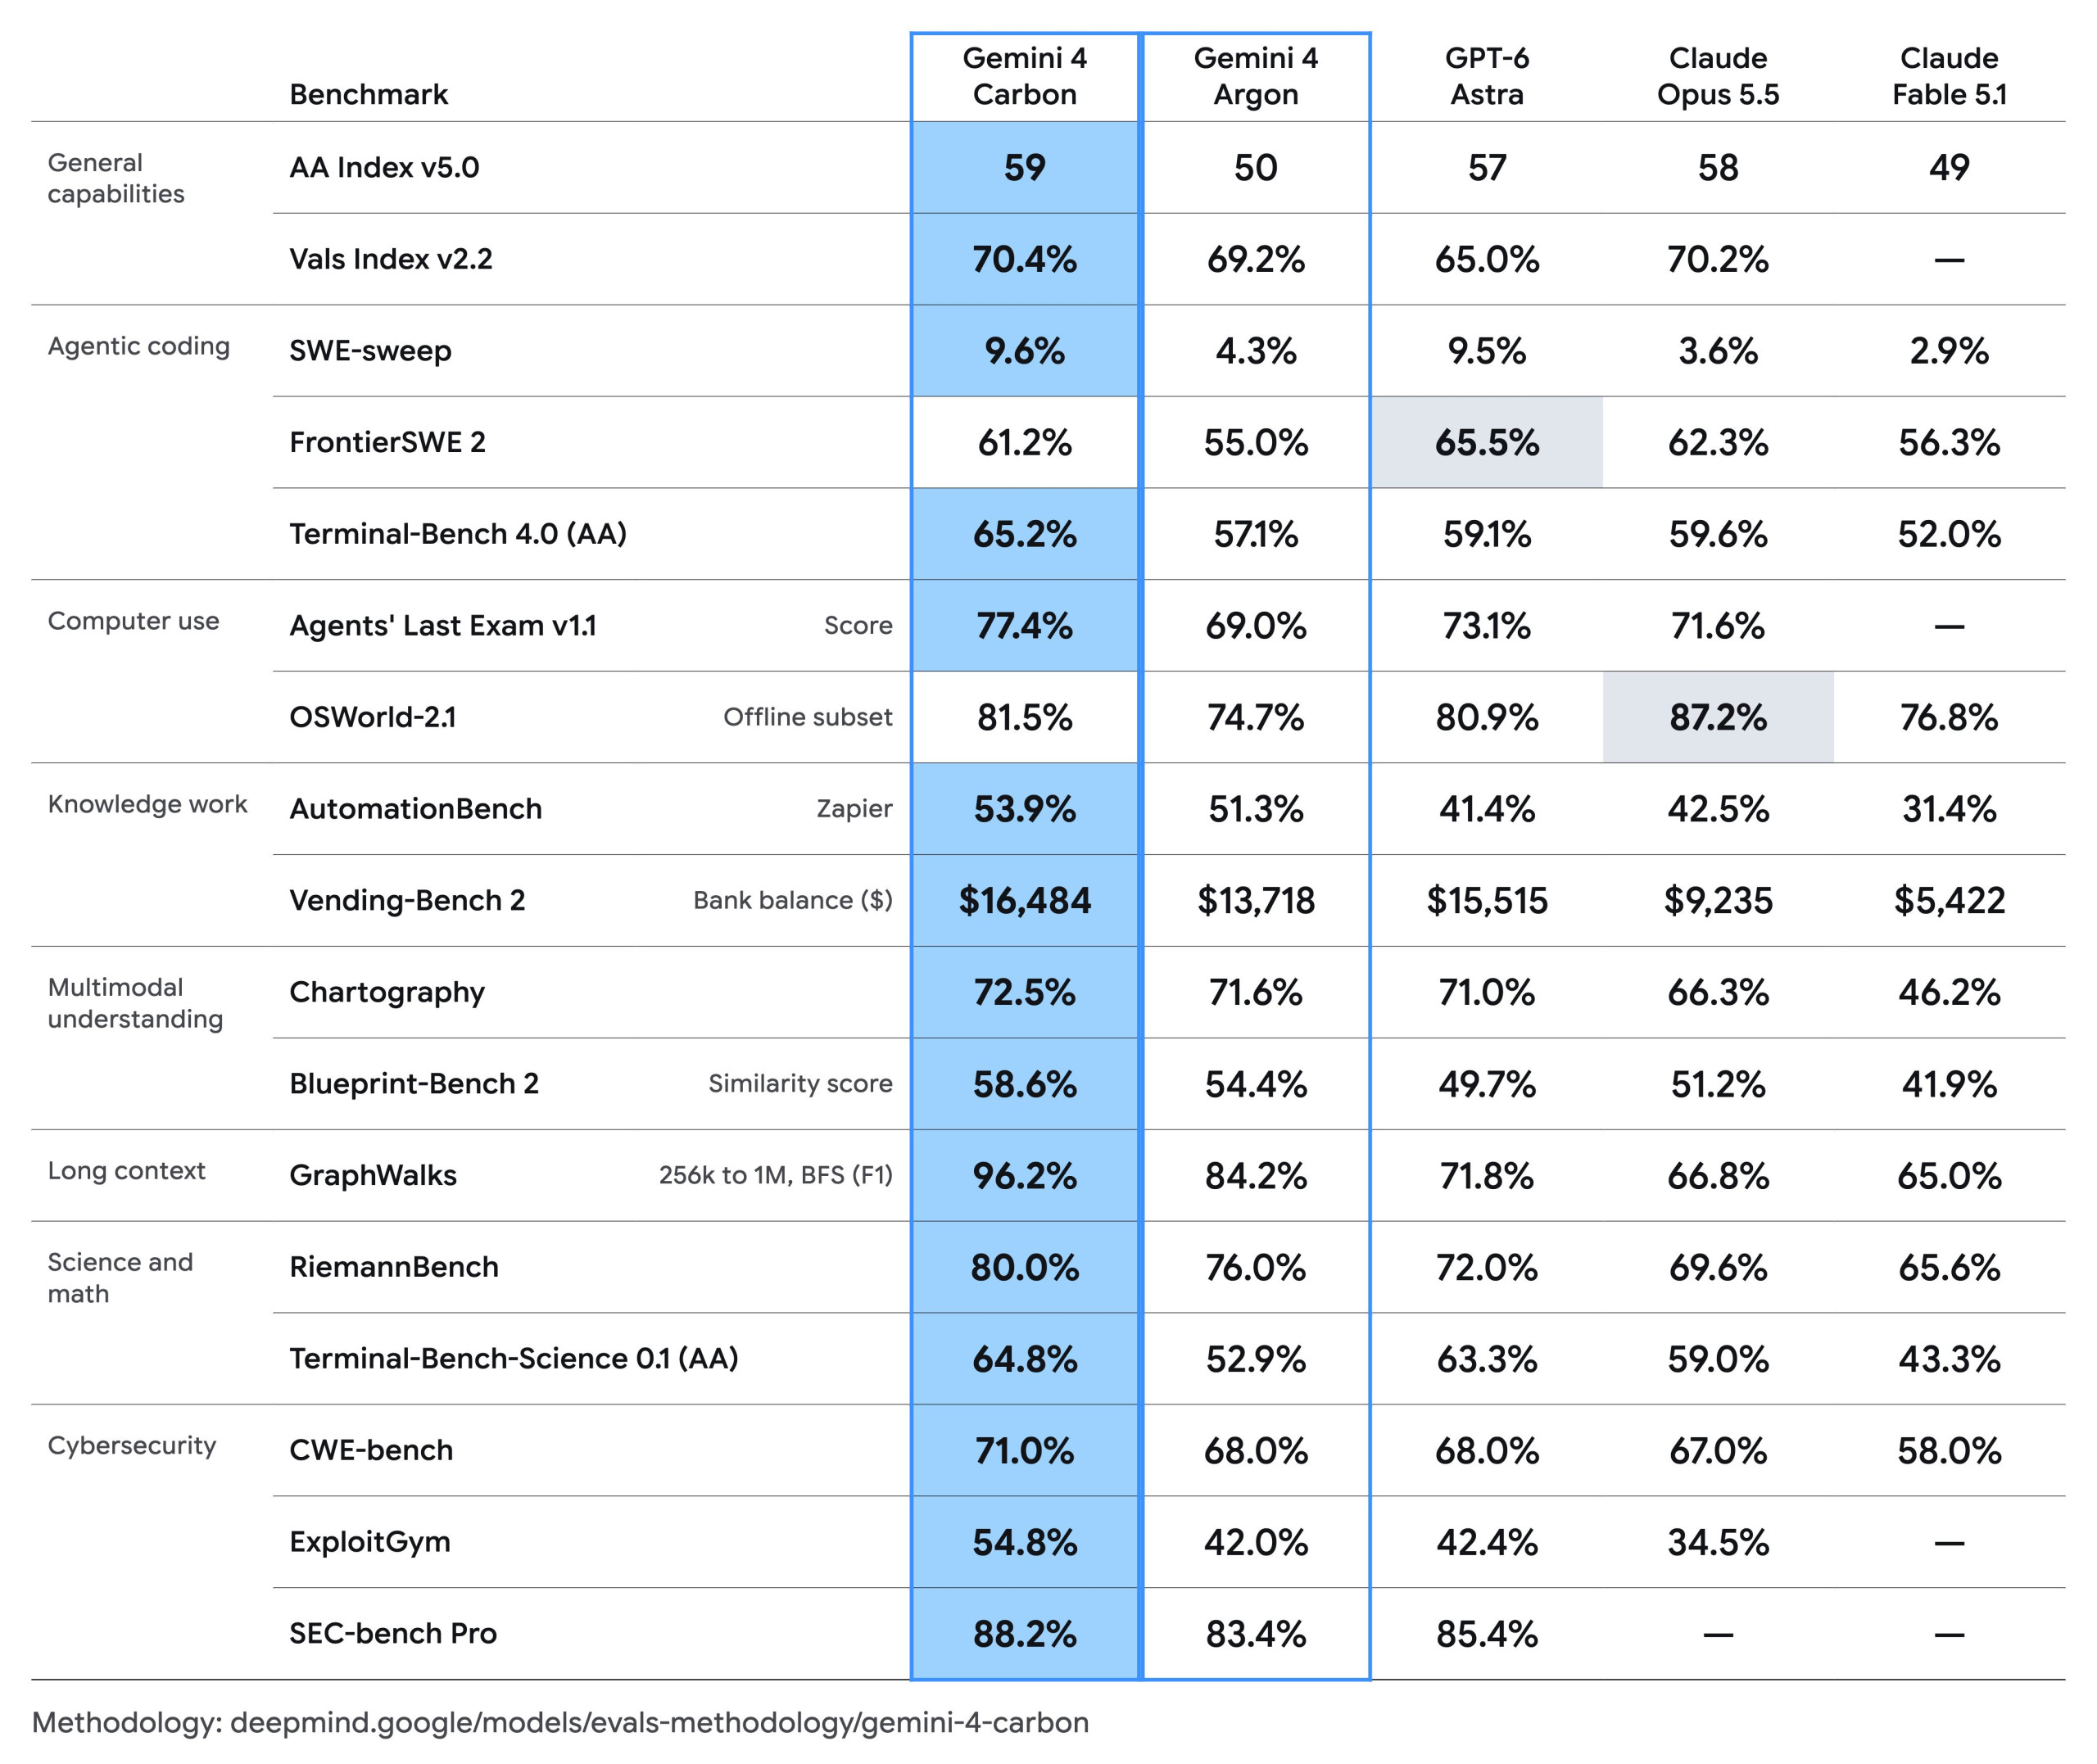
A Google destaca o primeiro lugar do Carbon no Intelligence Index da Artificial Analysis, e a página do site confirma: versão 5.0, 59 pontos, 1.º lugar entre 52 modelos. Na tabela que acompanha o anúncio, o Claude Opus 5.5 está com 58 e o GPT-6 Astra com 57, enquanto o Argon se fica pelos 50; estes três resultados encontram-se no ranking do site. A diferença é da mesma ordem no Vals Index v2.2, onde o Carbon obtém 70,4 % contra 70,2 % do Opus 5.5. Vals AI, que publica este ranking, coloca por sua vez o Carbon em segundo lugar entre 29 modelos, com 70,36 %.
Fonte: Google
| Teste | Carbon | Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|---|
| AA Index v5.0 | 59 | 50 | 57 | 58 |
| Vals Index v2.2 | 70,4 % | 69,2 % | 65,0 % | 70,2 % |
| SEC-bench Pro | 88,2 % | 83,4 % | 85,4 % | – |
| ExploitGym | 54,8 % | 42,0 % | 42,4 % | 34,5 % |
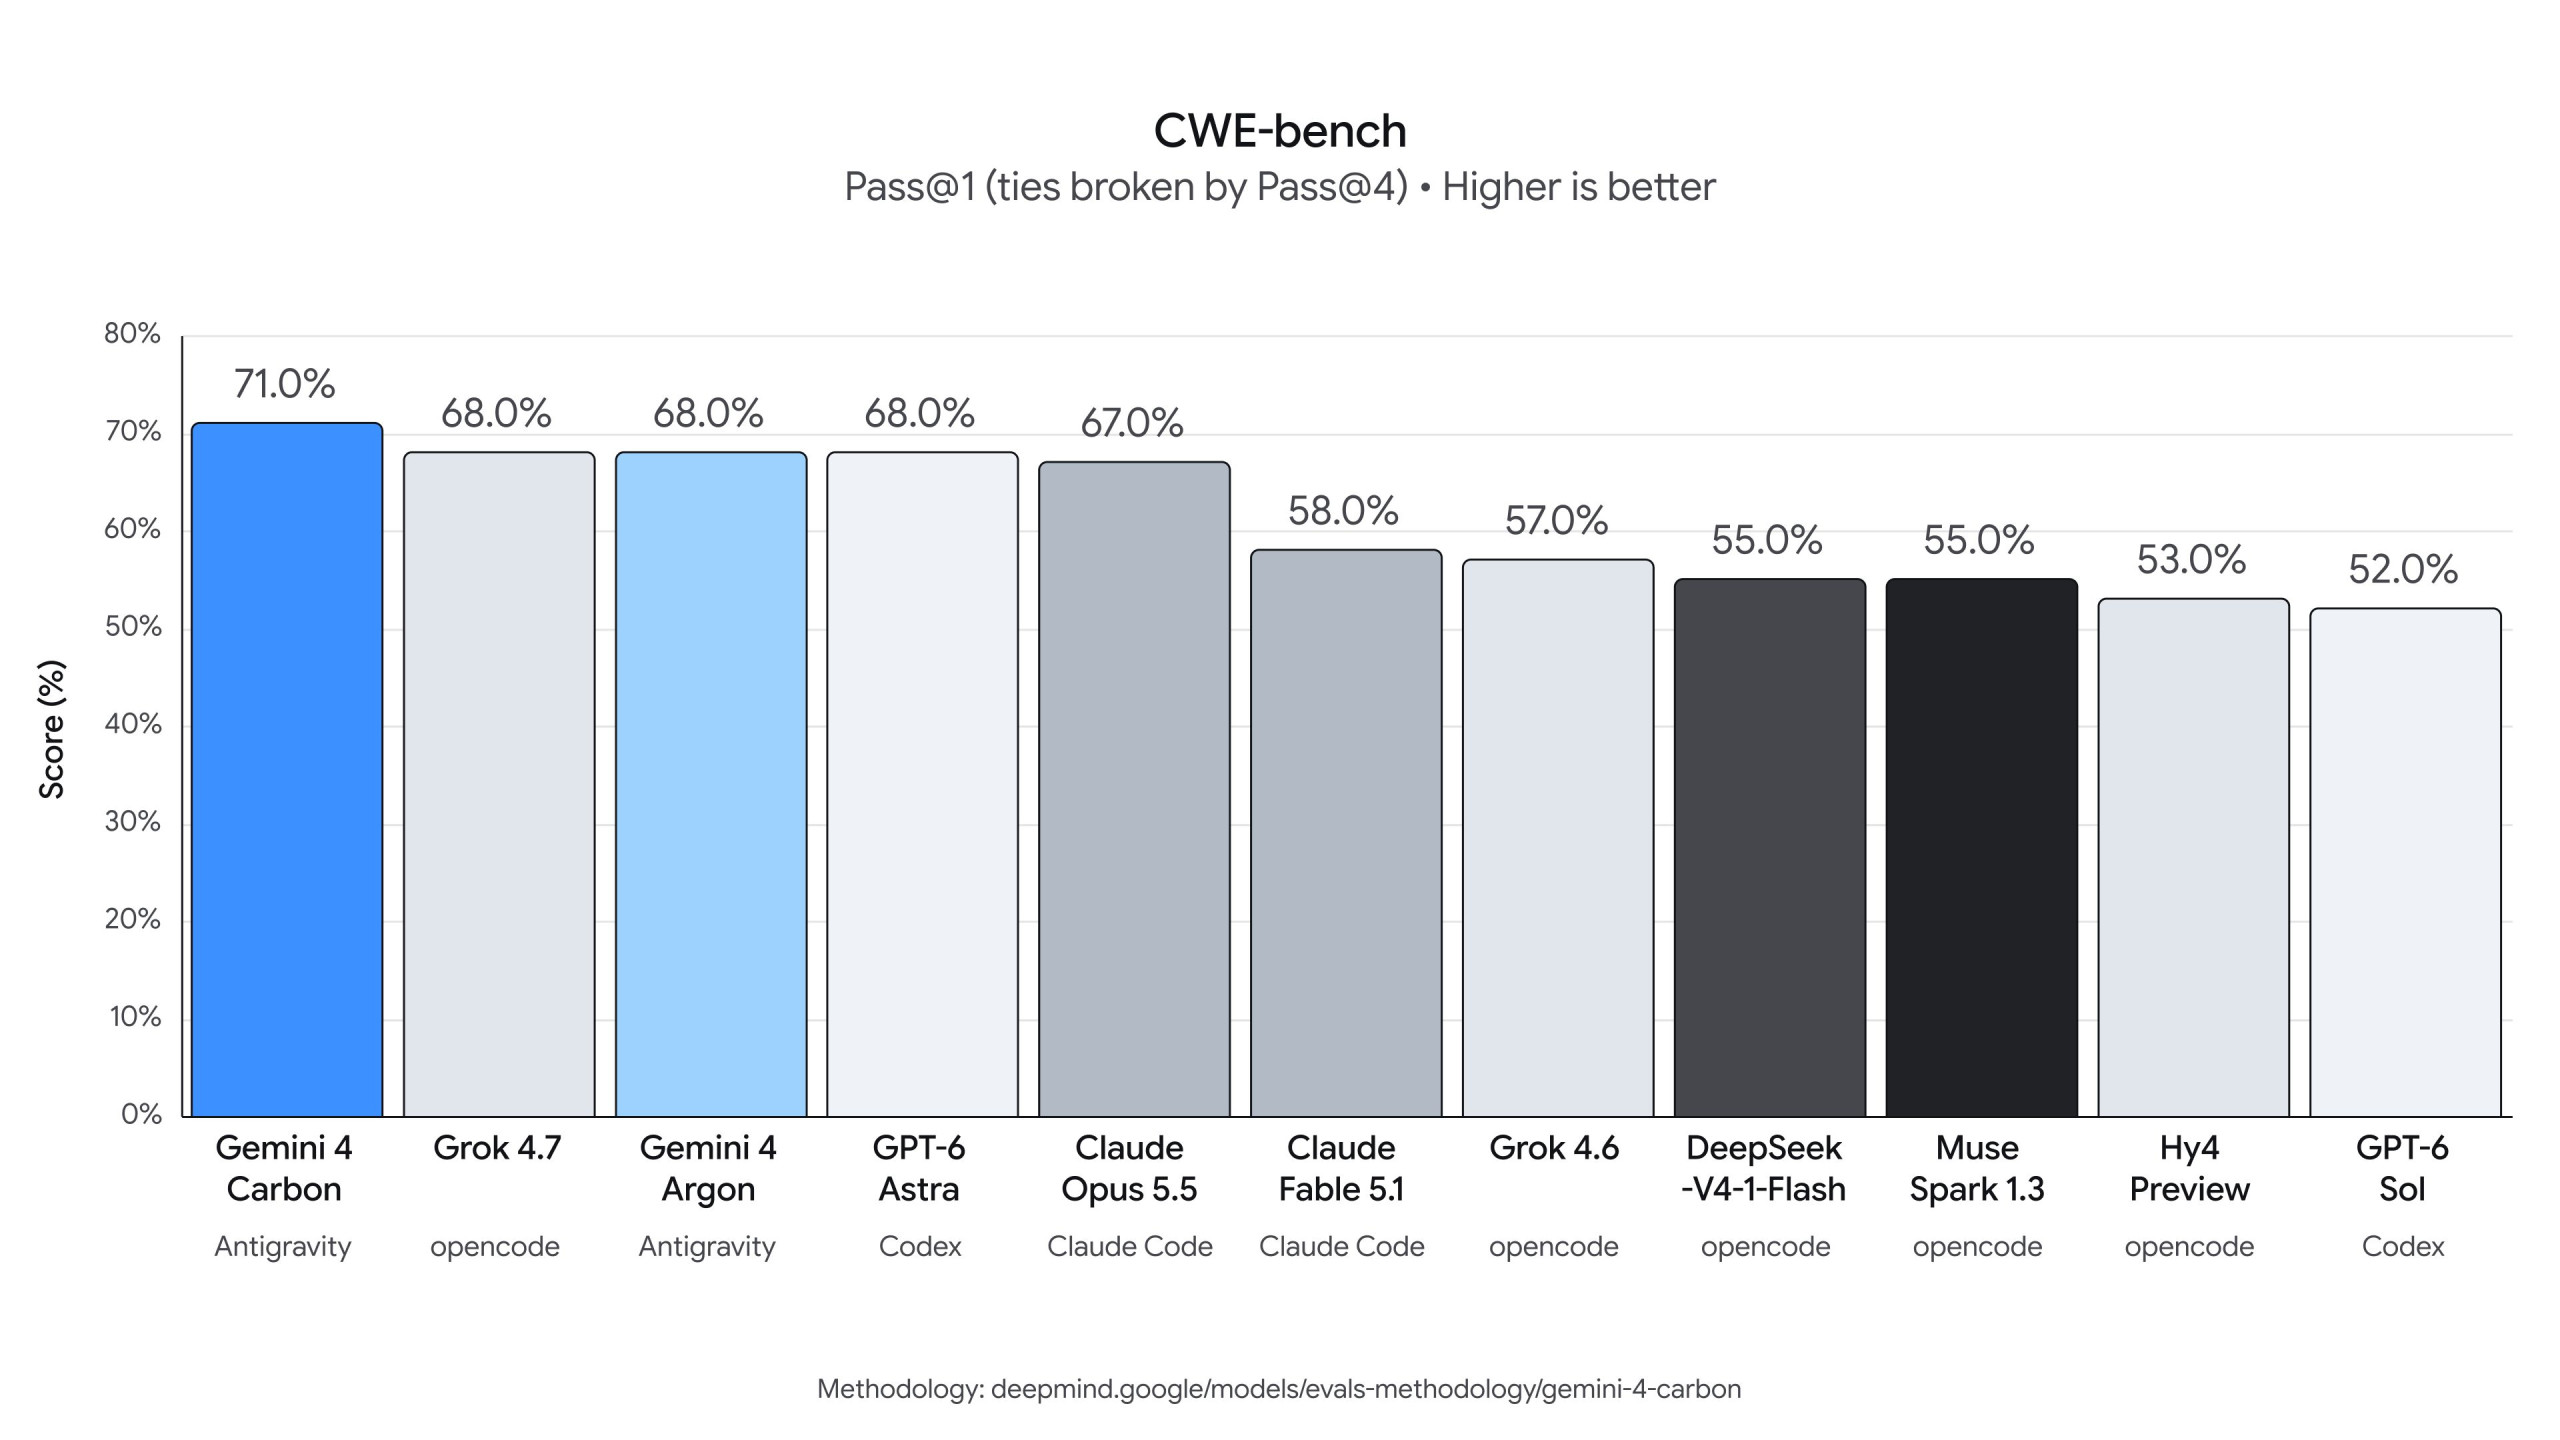
| CWE-bench | 71,0 % | 68,0 % | 68,0 % | 67,0 % |
| OSWorld-2.1 (offline) | 81,5 % | 74,7 % | 80,9 % | 87,2 % |
| FrontierSWE 2 | 61,2 % | 55,0 % | 65,5 % | 62,3 % |
Fonte: Google
Contudo, esta mesma tabela mostra que o Carbon não é primeiro em todo o lado: o Claude Opus 5.5 mantém a vantagem no OSWorld-2.1, um teste de utilização de computador (87,2 % contra 81,5 %), e o GPT-6 Astra no FrontierSWE 2, um teste de programação (65,5 % contra 61,2 %).
Gemini 4 Carbon com 88,2 % em cibersegurança, mas com testes desiguais
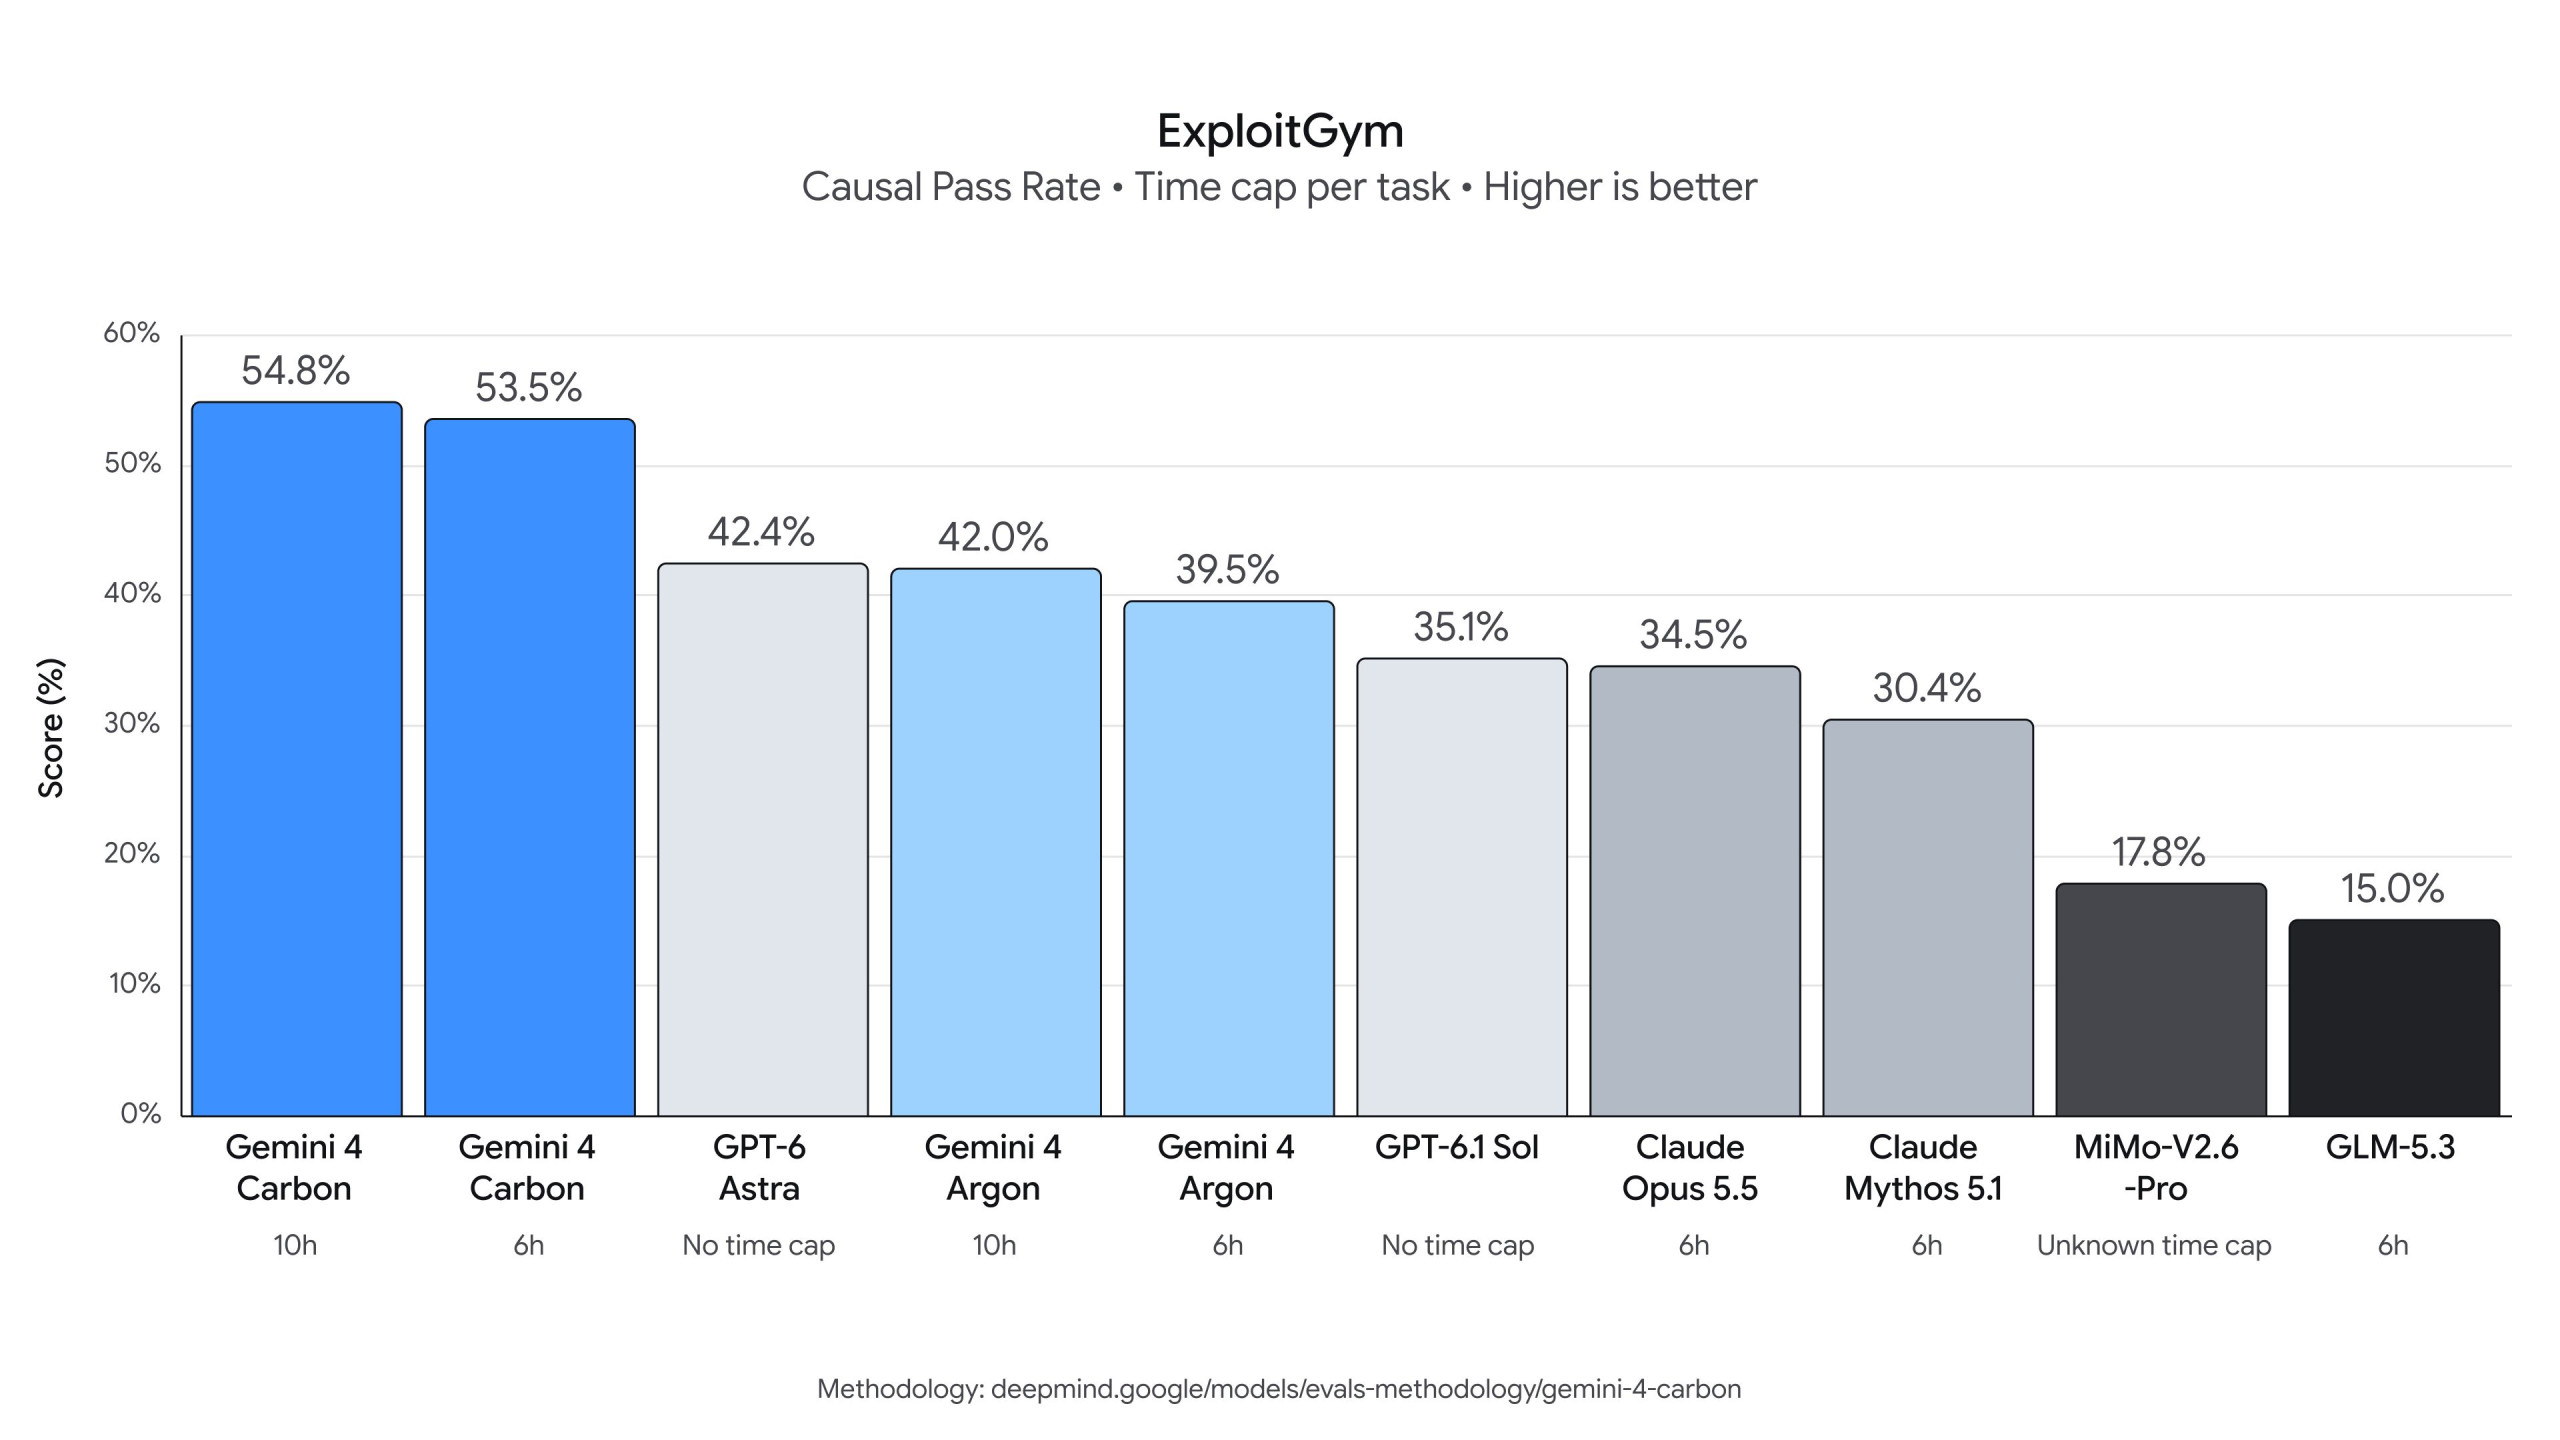
Para a cibersegurança, a Google destaca três testes externos, realizados sem salvaguardas: 88,2 % no SEC-bench Pro para encontrar vulnerabilidades, 54,8 % no ExploitGym para as explorar, 71,0 % no CWE-bench para as corrigir. No SEC-bench Pro, o GPT-6 Astra segue com 85,4 % e o Argon com 83,4 %. No ExploitGym, no entanto, a diferença é mais clara: o GPT-6 Astra está com 42,4 % e o Claude Opus 5.5 com 34,5 %.
Estes resultados vêm da Google, e as condições de teste não são as mesmas para todos os modelos. Os 54,8 % do Carbon correspondem a um limite de 10 horas por tarefa. Com 6 horas, desce para 53,5 %, o que o mantém à frente do GPT-6 Astra, testado sem limite de tempo, e do Opus 5.5, limitado a 6 horas. No CWE-bench, os modelos também não passam pela mesma ferramenta de programação: Antigravity para o Carbon, Codex para o GPT-6 Astra, Claude Code para o Opus 5.5. E a vantagem sobre o Argon resume-se a 3 pontos (71,0 % contra 68,0 %).
A Google cita também a equipa do Chrome, que relatou que o Carbon teve um desempenho mais de 10 vezes melhor do que um grande modelo de outro laboratório, não nomeado, na produção de correções de qualidade, e a Wiz, que observa o Carbon em primeiro lugar em benchmarks de teste de intrusão web.
Gemini 4 Carbon: tarefas de vários dias e menos trapaça, segundo a Google
O Carbon foi concebido para problemas de engenharia longos: internamente, as equipas da Google viram-no trabalhar durante dias para encontrar a causa de erros subtis e corrigi-los em grandes bases de código. A empresa insiste também no alinhamento. No Terminal-Bench 4.0, a trapaça bem-sucedida cai para 0,0 % e as tentativas para 0,4 %. Os alertas de desalinhamento grave diminuem quase 80 % nos seus ambientes de código internos, e as afirmações infundadas são cerca de 2 vezes menos frequentes do que com o Argon. No teste de injeção de prompt do Gray Swan, nenhum ataque teve sucesso (0 %, contra 0,7 % para o Argon e 1,0 % para o Opus 5.5). Estas medições são publicadas pela Google e em grande parte internas: apenas testes realizados fora das suas equipas dirão se se confirmam.
Preço do Gemini 4 Carbon: 2 $ e 10 $ no lançamento, depois 4 $ e 20 $
O Carbon é faturado a 2 $ por milhão de tokens de entrada e 10 $ de saída durante o período de lançamento, como o Argon, com um desconto de 95 % nos tokens de entrada em cache. Depois, o preço passará para 4 $ e 20 $, de acordo com a nota de rodapé do anúncio. A Google não indica a data de fim desta oferta para o Carbon.
Estes resultados manter-se-ão quando o Carbon sair do círculo dos especialistas selecionados e chegar aos programadores, numa data que a Google não fixou?
