Google heeft woensdag 28 oktober Gemini 4 Carbon gepresenteerd, zijn nieuwe vlaggenschipmodel, twee weken na de publieke opening van Argon. Het presenteert zich als nummer één in een benchmark, maar slechts met één punt verschil, en richt zich vooral op cybersecurity en taken die dagen duren. Voorlopig hebben alleen enkele cyberverdedigers er toegang toe.
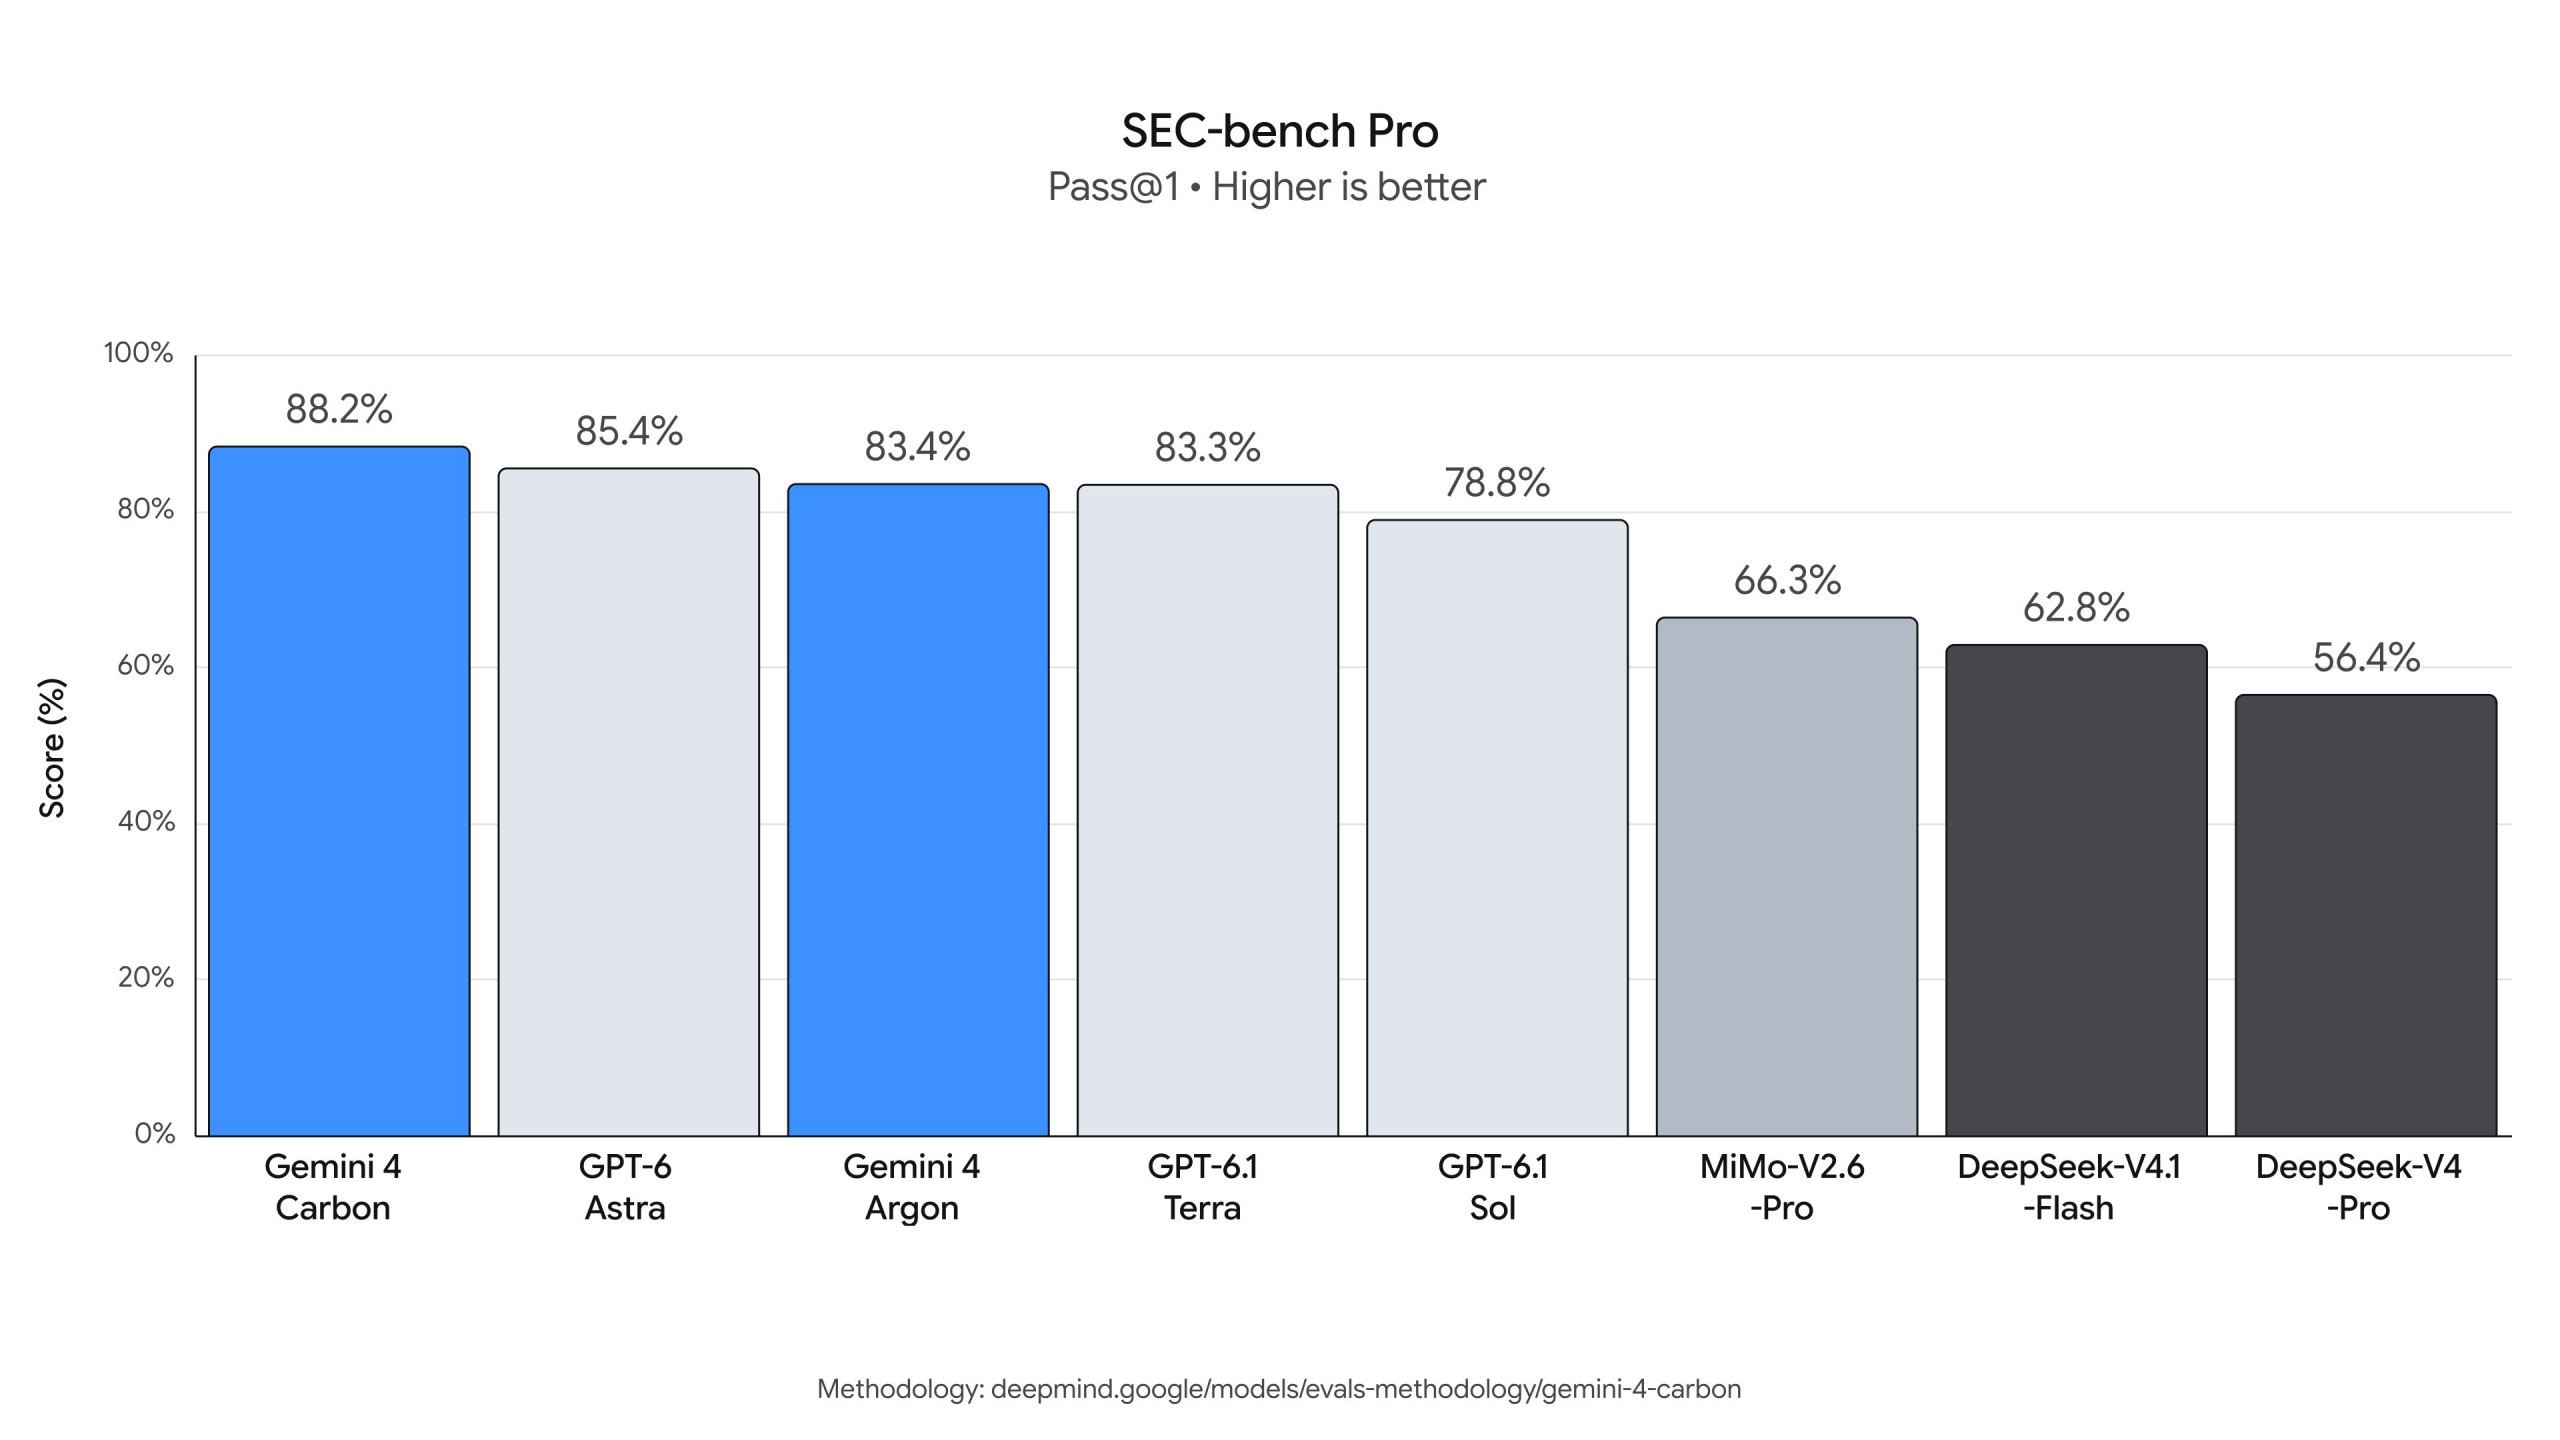
Een score van 88,2 % op SEC-bench Pro, een test voor het detecteren van kwetsbaarheden: Google zet dit cijfer voorop in de aankondiging van Gemini 4 Carbon, ondertekend door Koray Kavukcuoglu, senior vicepresident van Google DeepMind en hoofdarchitect AI bij Google. Het model komt twee weken na de publieke opening van Argon, op 13 oktober. Google verklaart dit tempo door werk waarbij onderzoekers en modellen samen de capaciteiten vooruit helpen, en sneller.
Sundar Pichai heeft de aankondiging zelf gedeeld op X: hij herinnert eraan dat Google had aangekondigd zijn modellen op regelmatige intervallen uit te brengen, en herhaalt de drie cybersecurity-scores.
Carbon is echter niet voor iedereen toegankelijk. Deze week stelt Google het beschikbaar aan een kleine groep cyberverdedigers, en zal daarna de toegang uitbreiden naar andere vertrouwde partners via het programma Fairwind, gelanceerd op 2 september. De gepubliceerde regels voor Argon beperken de toegang tot interne cybersecurity-teams, incident response-teams en penetration testers van toegelaten organisaties. Het telde meer dan 650 partners bij de lancering. Ontwikkelaars, bedrijven en het grote publiek volgen later, zodra mogelijk, zonder aangekondigde datum. Google zegt ook deel te nemen aan het vrijwillige vooraf-testproces van de Amerikaanse overheid.
Gemini 4 Carbon verslaat Opus 5.5 met slechts één punt op Artificial Analysis
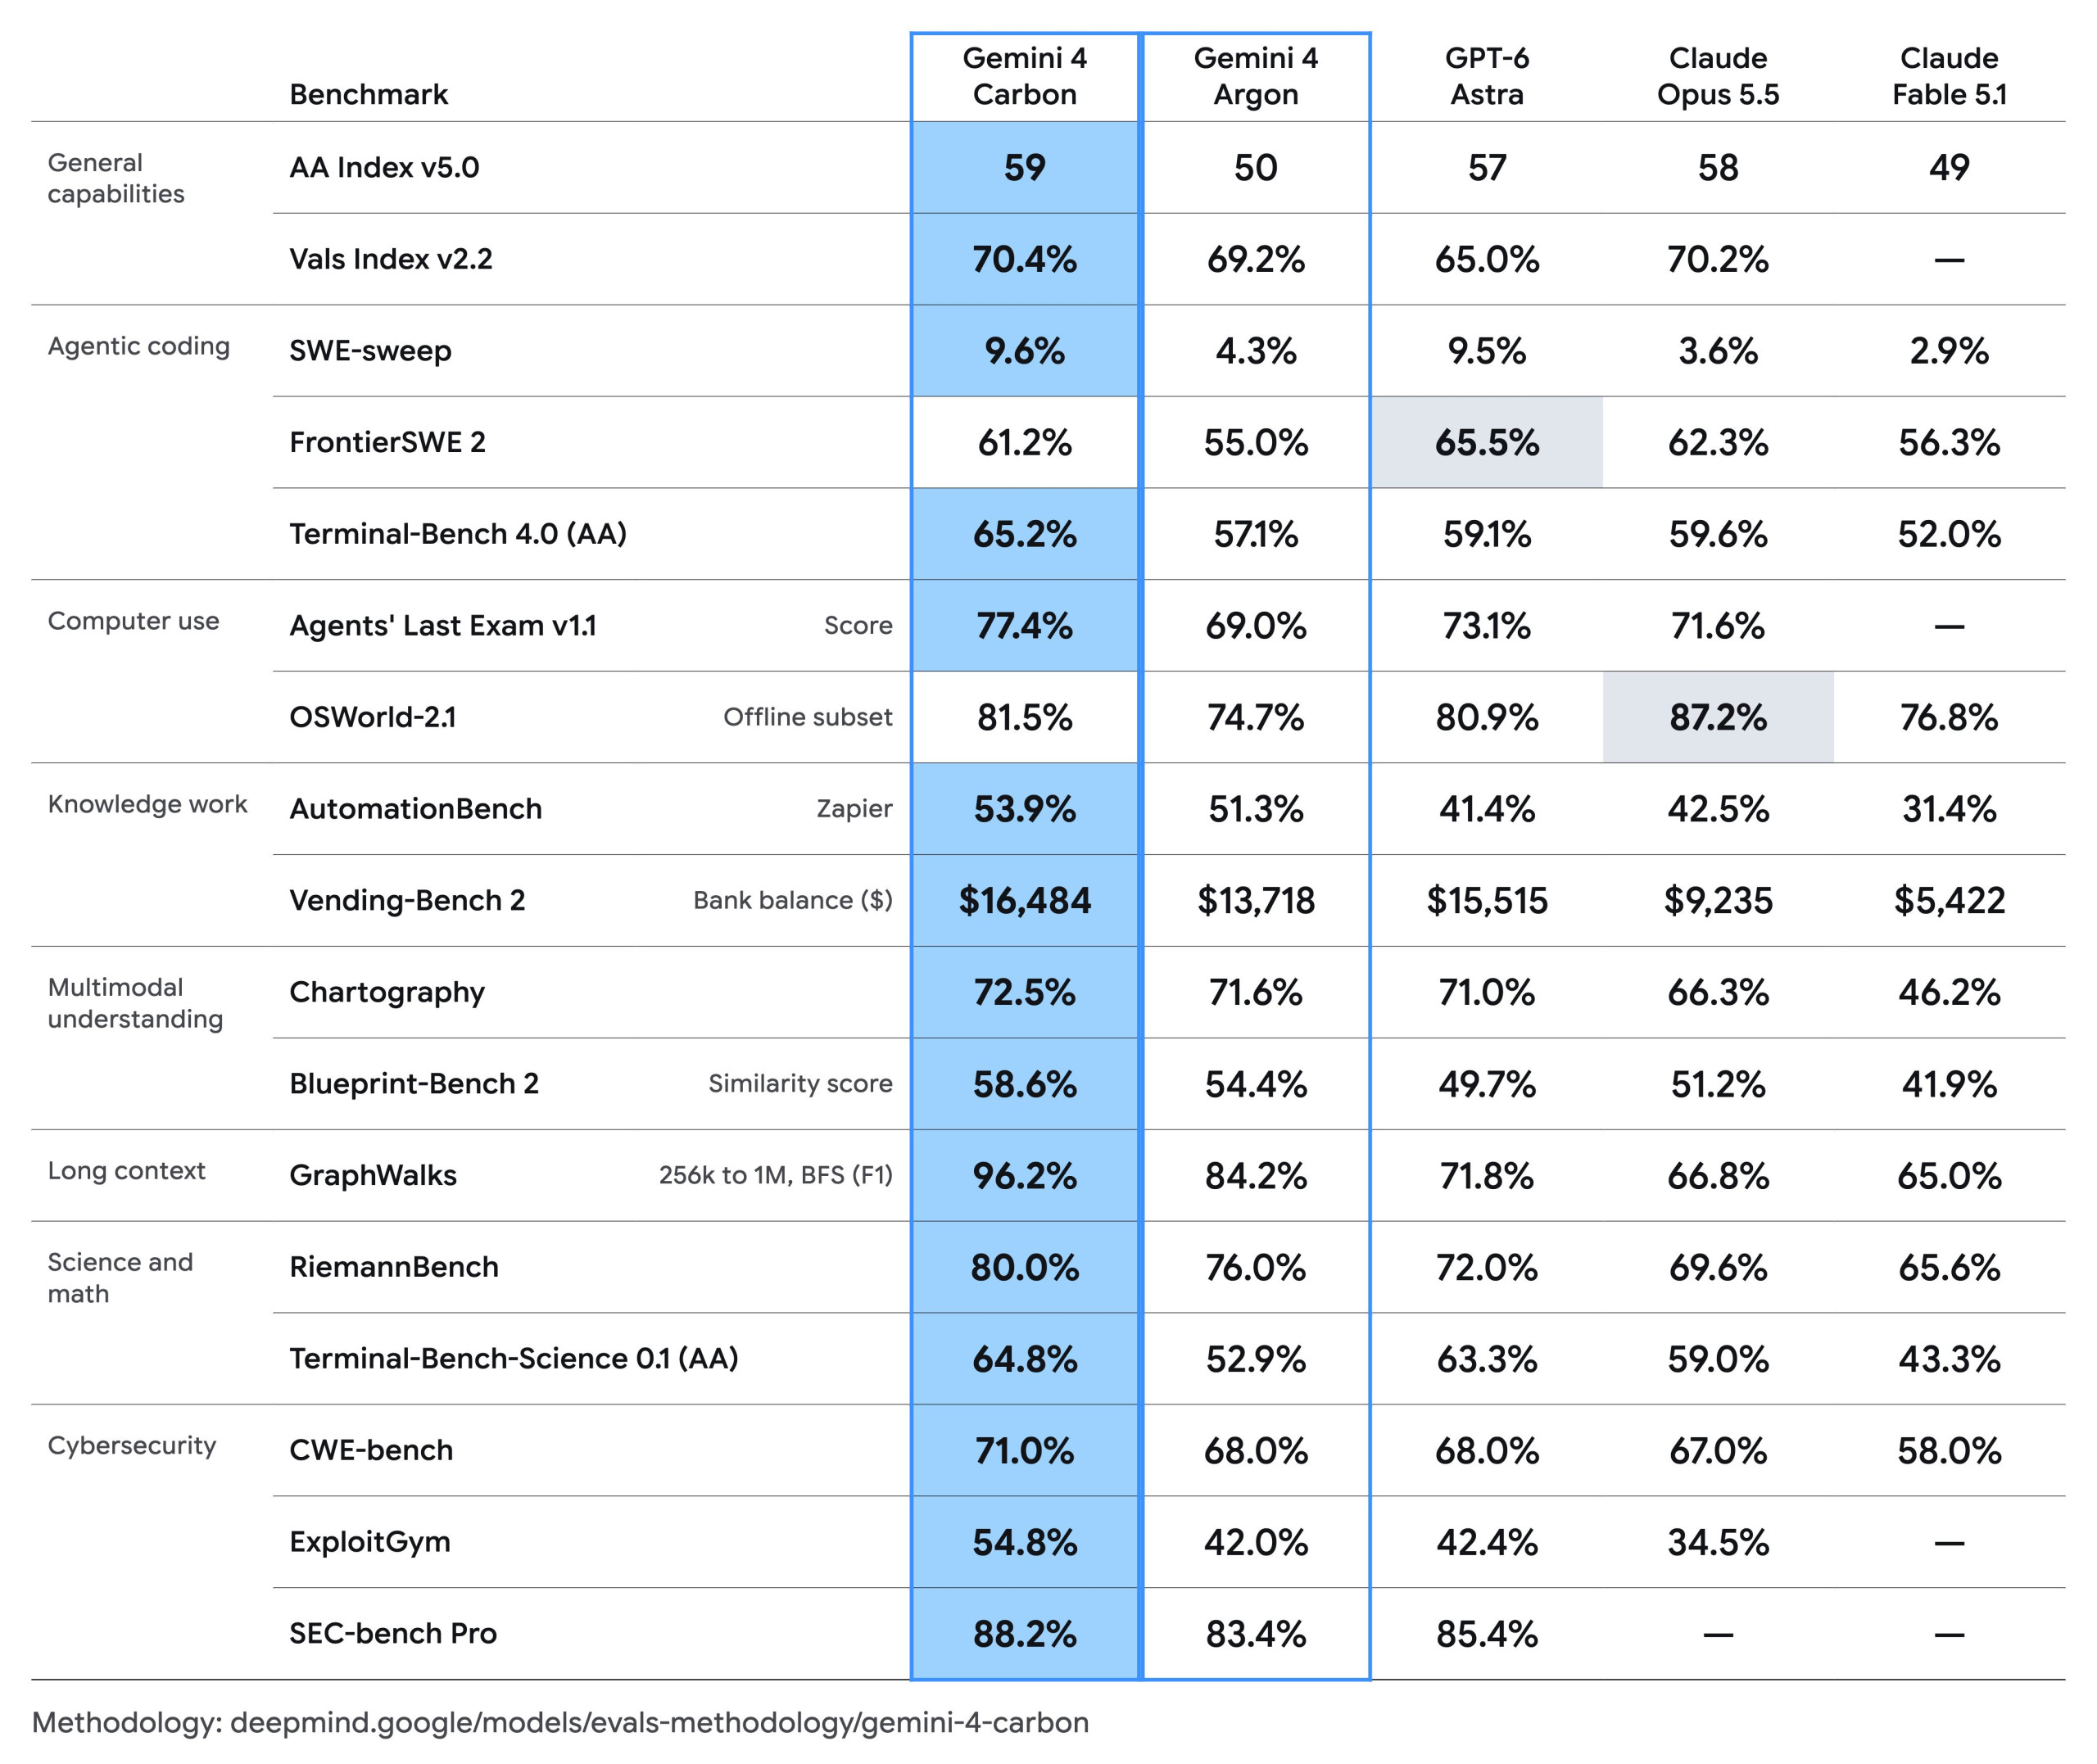
Google benadrukt de eerste plaats van Carbon op de Intelligence Index van Artificial Analysis, en de pagina van de site bevestigt dit: versie 5.0, 59 punten, nummer één van 52 modellen. In de tabel bij de aankondiging staat Claude Opus 5.5 op 58 en GPT-6 Astra op 57, terwijl Argon blijft steken op 50; deze drie scores zijn terug te vinden in de ranglijst van de site. Het verschil is van dezelfde orde op de Vals Index v2.2, waar Carbon 70,4 % haalt tegen 70,2 % voor Opus 5.5. Vals AI, dat deze ranglijst publiceert, plaatst Carbon zelf op de tweede plaats van 29 modellen, met 70,36 %.
Bron: Google
| Test | Carbon | Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|---|
| AA Index v5.0 | 59 | 50 | 57 | 58 |
| Vals Index v2.2 | 70,4 % | 69,2 % | 65,0 % | 70,2 % |
| SEC-bench Pro | 88,2 % | 83,4 % | 85,4 % | – |
| ExploitGym | 54,8 % | 42,0 % | 42,4 % | 34,5 % |
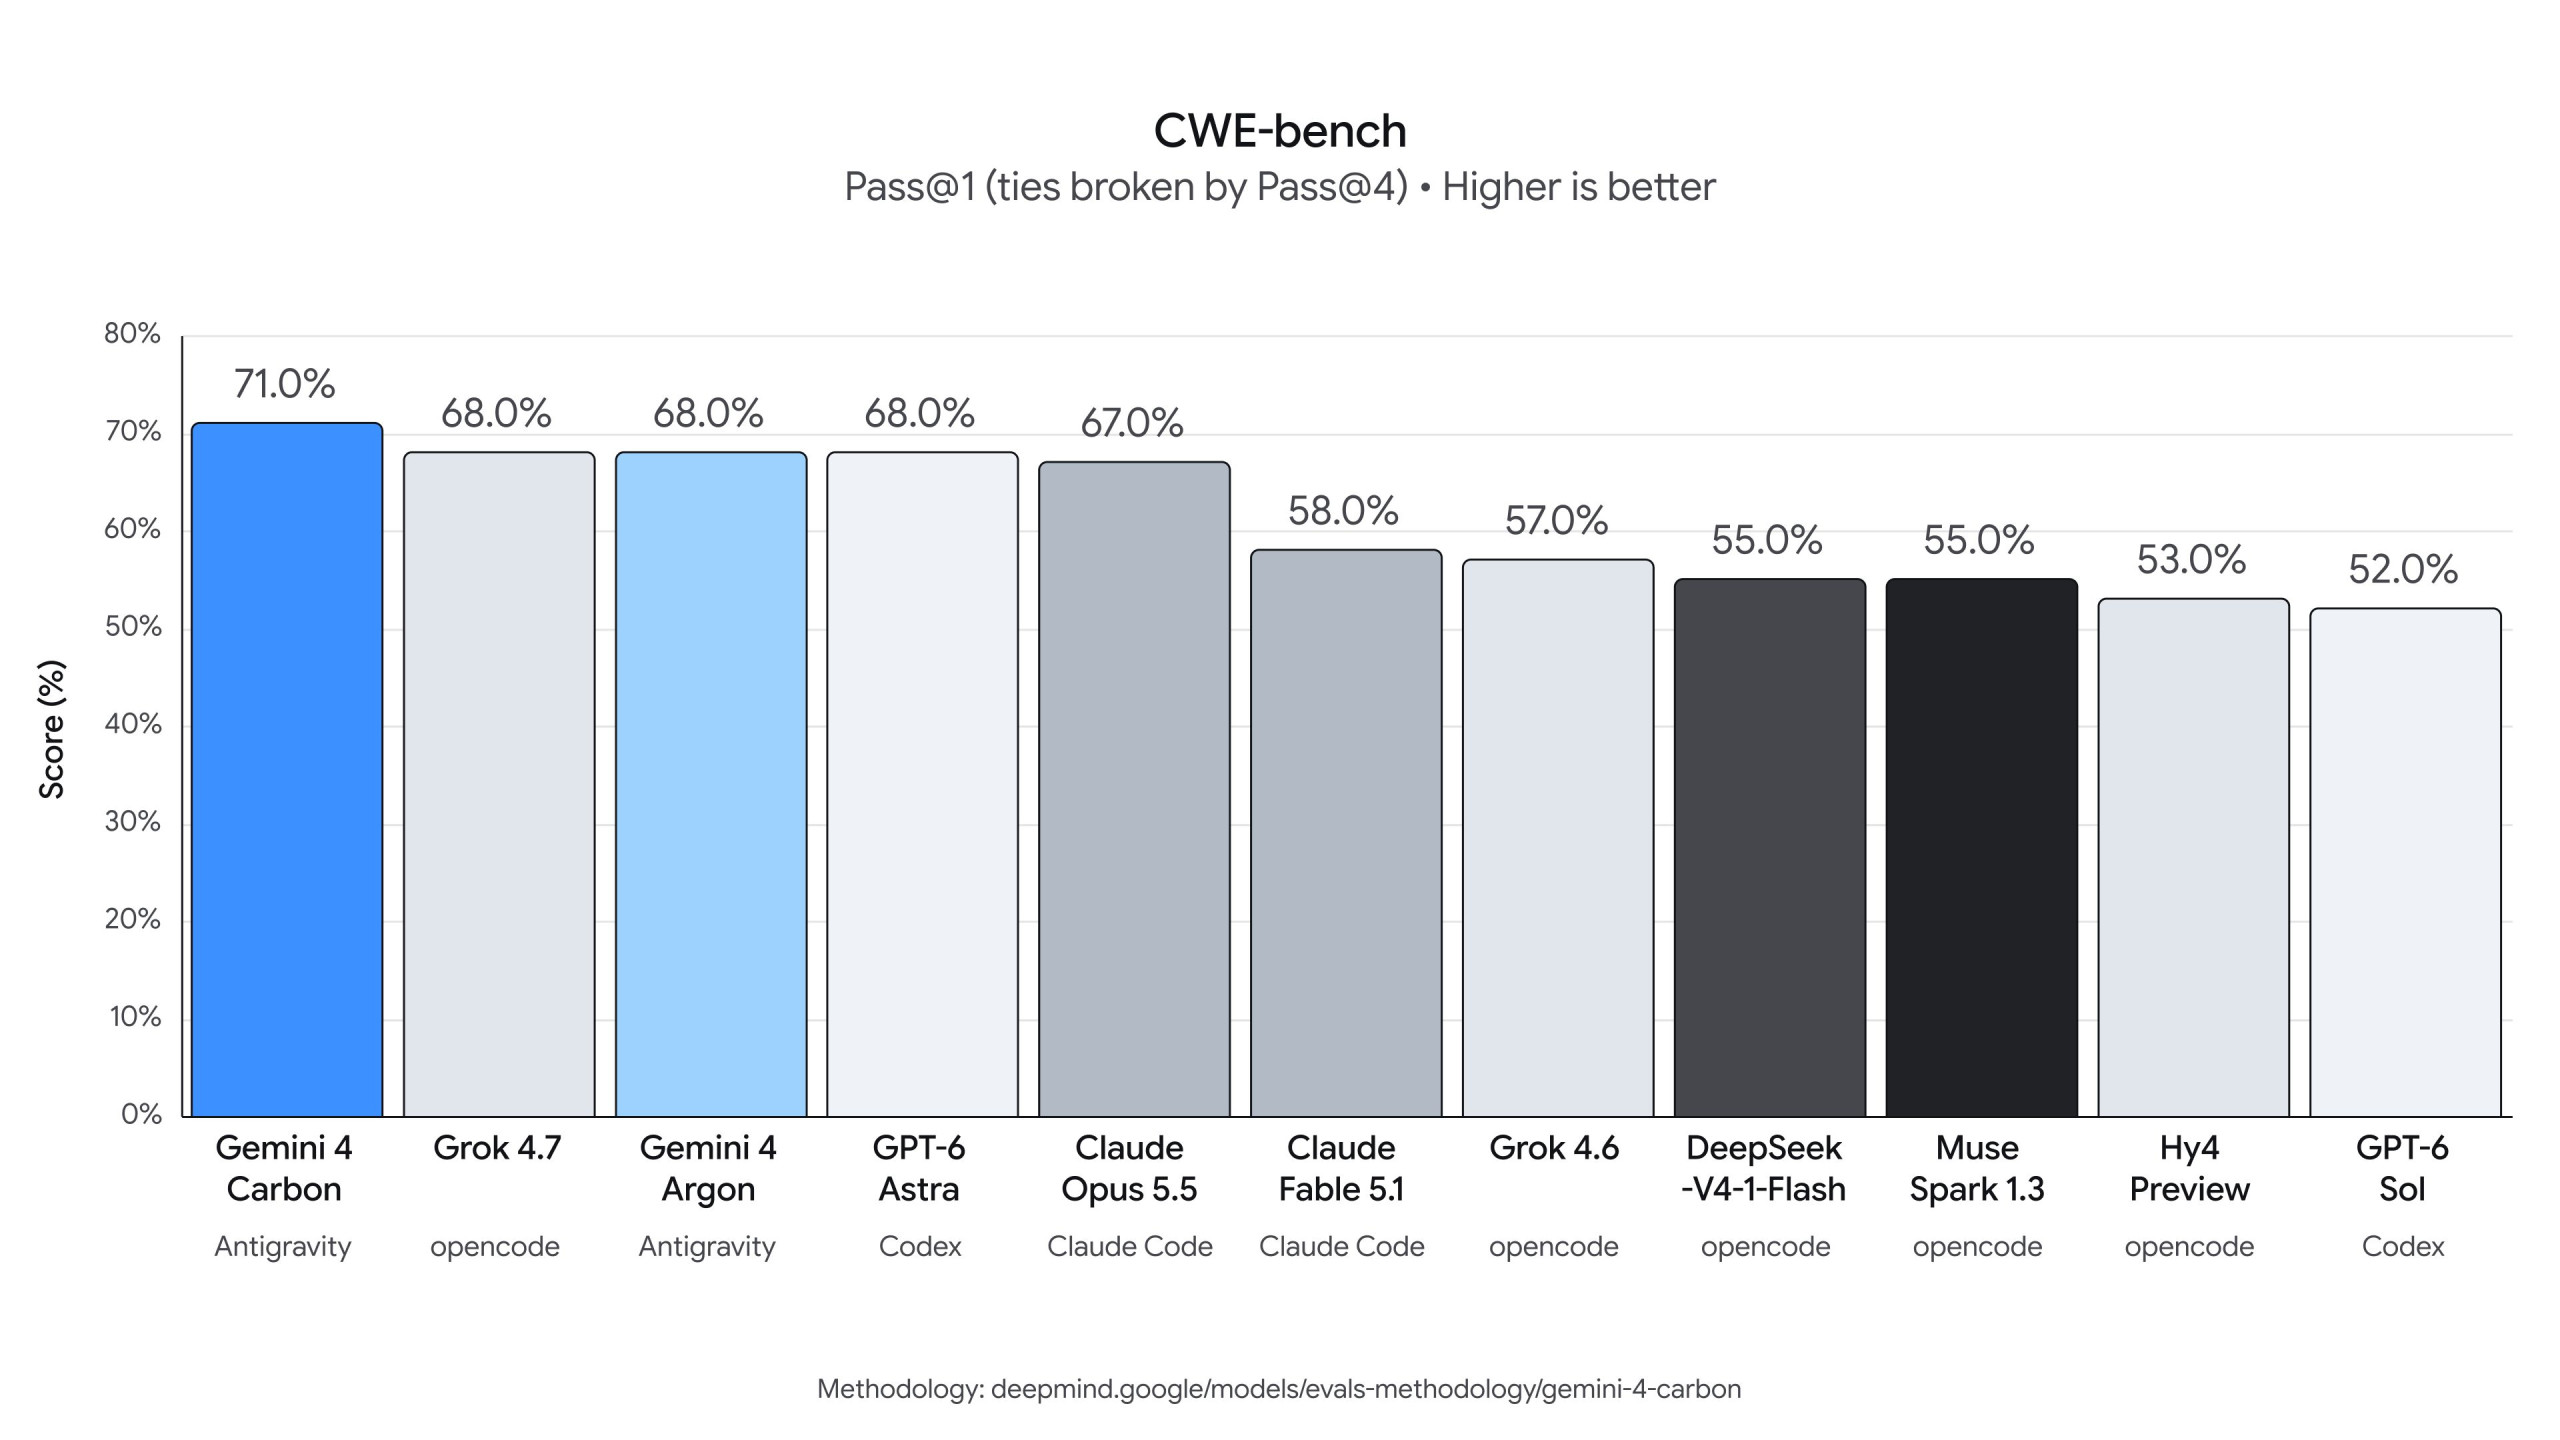
| CWE-bench | 71,0 % | 68,0 % | 68,0 % | 67,0 % |
| OSWorld-2.1 (offline) | 81,5 % | 74,7 % | 80,9 % | 87,2 % |
| FrontierSWE 2 | 61,2 % | 55,0 % | 65,5 % | 62,3 % |
Bron: Google
Dezelfde tabel laat echter zien dat Carbon niet overal eerste is: Claude Opus 5.5 houdt de voorsprong op OSWorld-2.1, een test voor computergebruik (87,2 % tegen 81,5 %), en GPT-6 Astra op FrontierSWE 2, een programmeertest (65,5 % tegen 61,2 %).
Gemini 4 Carbon haalt 88,2 % in cybersecurity, maar met ongelijke tests
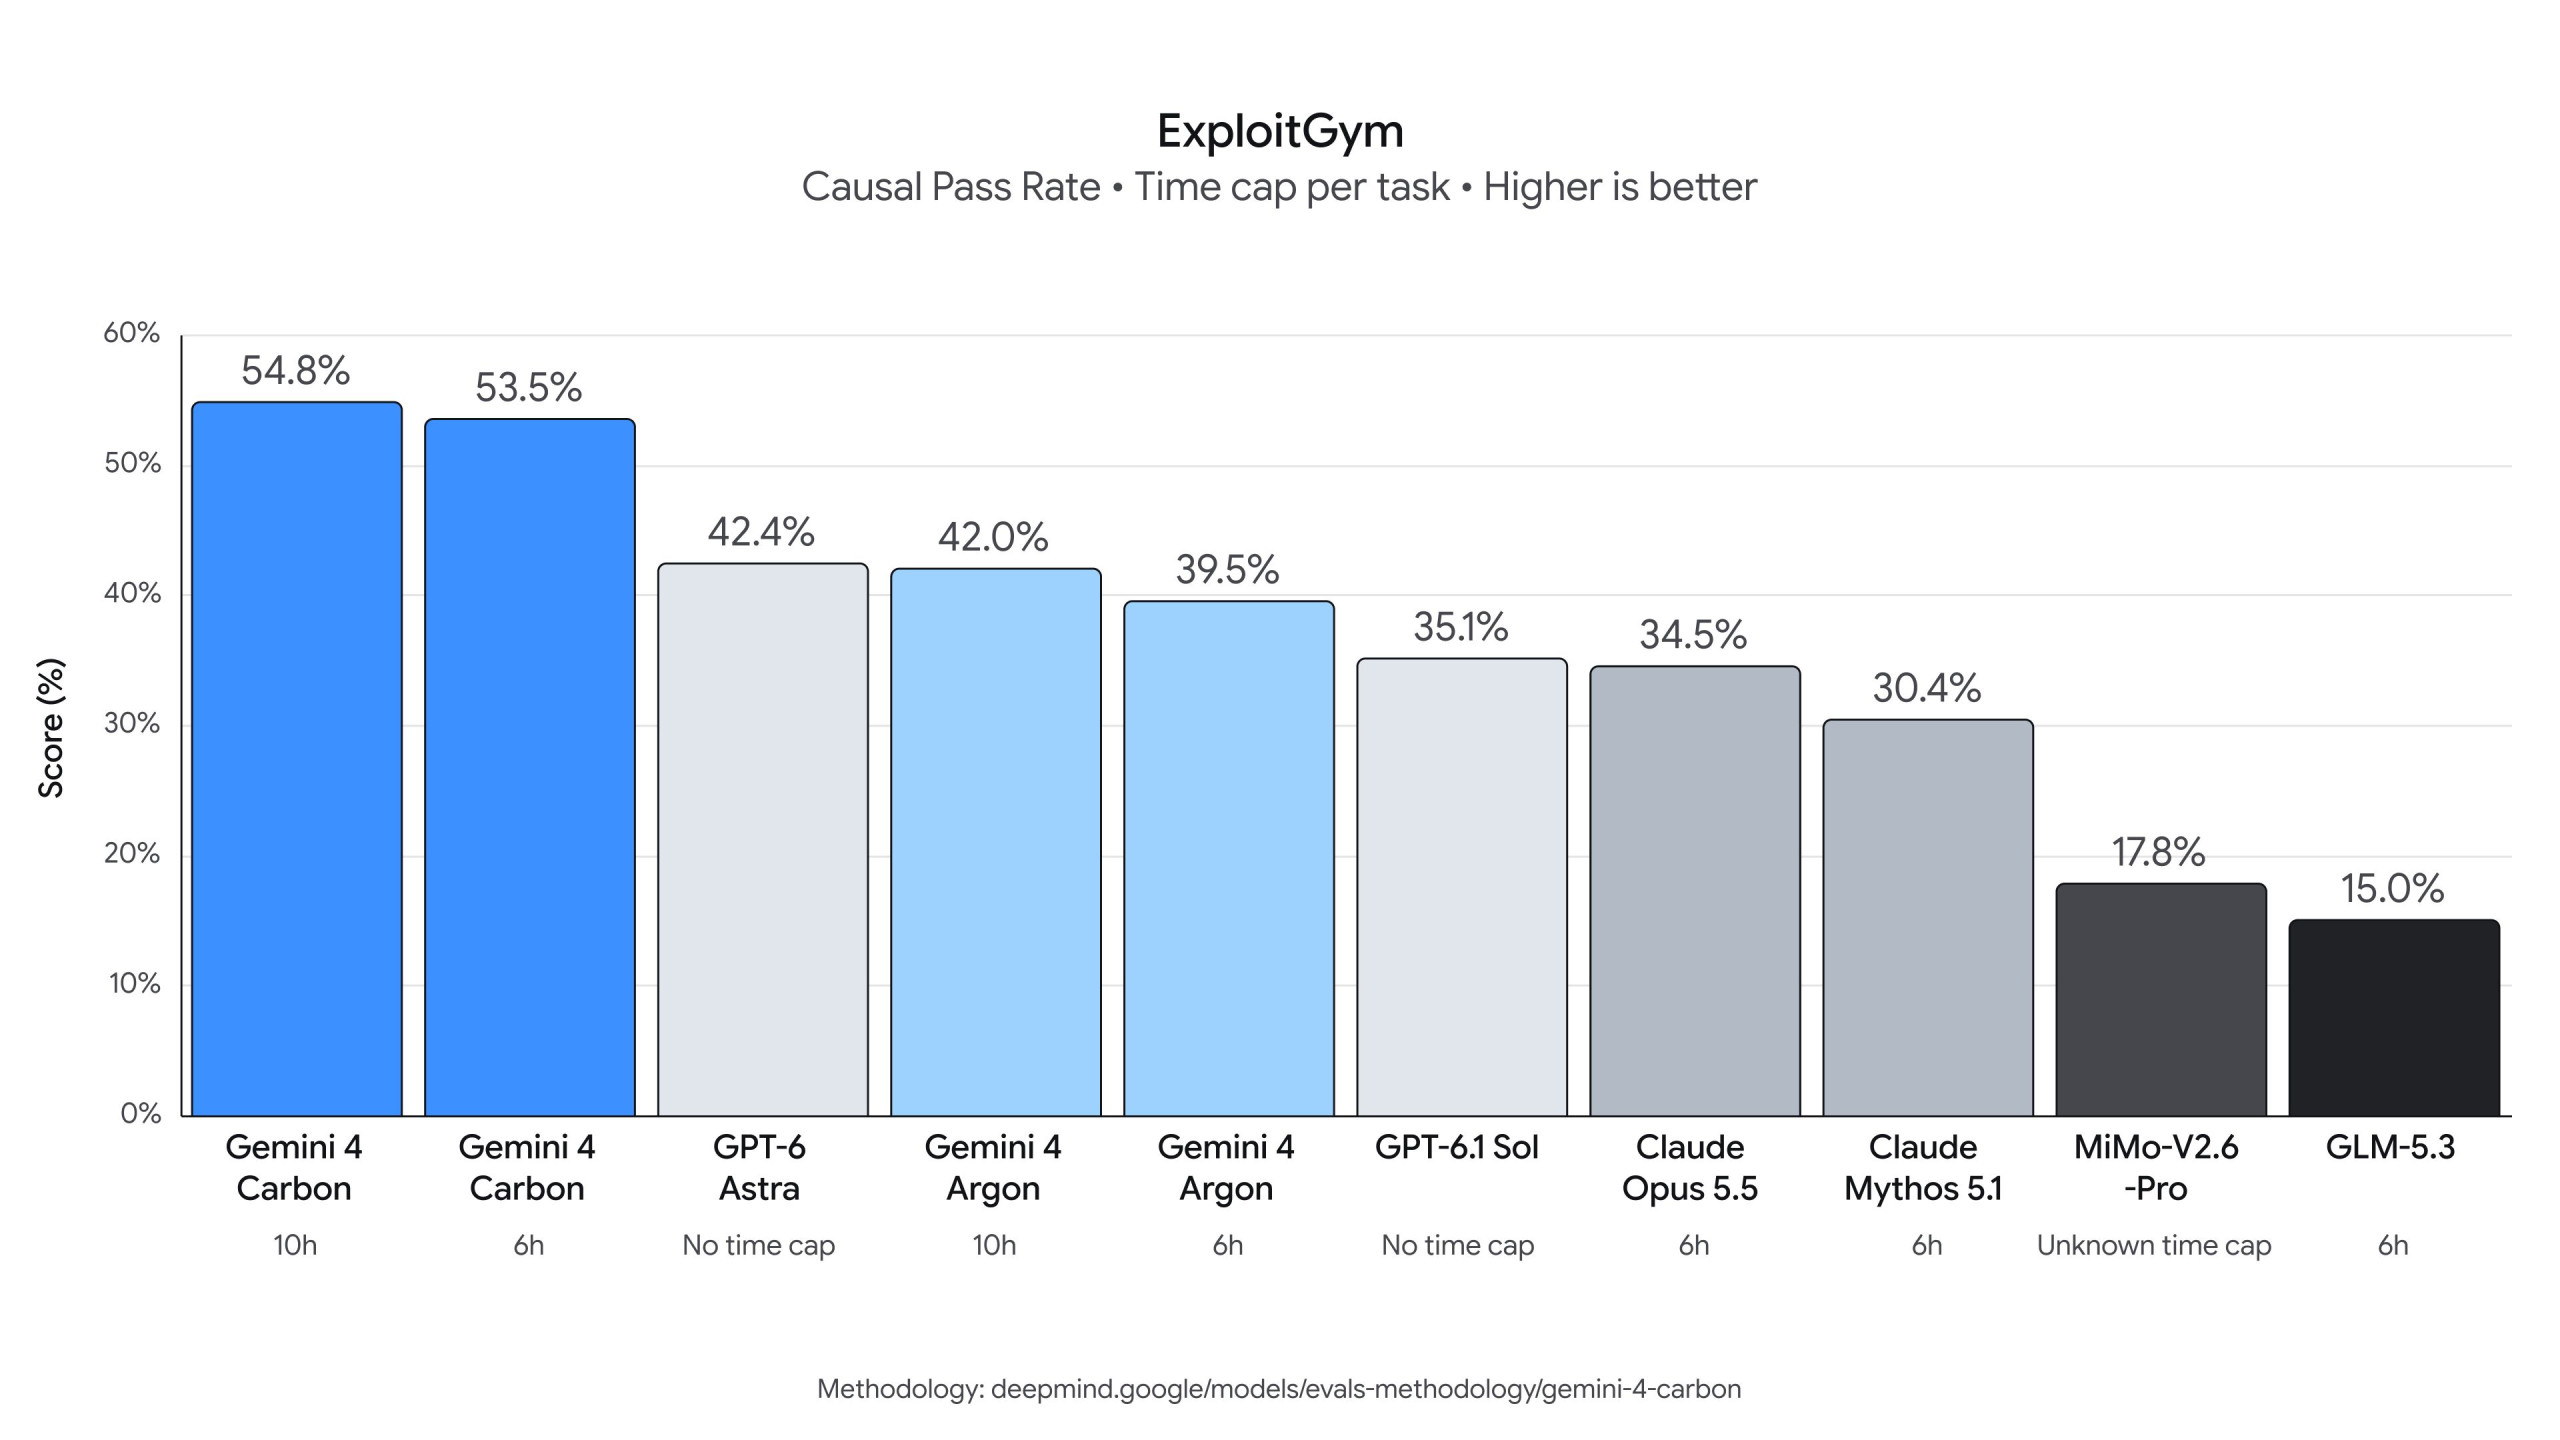
Voor cybersecurity benadrukt Google drie externe tests, uitgevoerd zonder veiligheidsmaatregelen: 88,2 % op SEC-bench Pro voor het vinden van kwetsbaarheden, 54,8 % op ExploitGym voor het uitbuiten ervan, 71,0 % op CWE-bench voor het corrigeren ervan. Op SEC-bench Pro volgt GPT-6 Astra met 85,4 % en Argon met 83,4 %. Op ExploitGym is het verschil echter groter: GPT-6 Astra staat op 42,4 % en Claude Opus 5.5 op 34,5 %.
Deze scores komen van Google, en de testomstandigheden zijn niet voor alle modellen hetzelfde. De 54,8 % van Carbon komt overeen met een plafond van 10 uur per taak. Met 6 uur daalt het naar 53,5 %, wat het nog steeds voor GPT-6 Astra plaatst, getest zonder tijdsplafond, en voor Opus 5.5, beperkt tot 6 uur. Op CWE-bench gebruiken de modellen ook niet hetzelfde programmeerhulpmiddel: Antigravity voor Carbon, Codex voor GPT-6 Astra, Claude Code voor Opus 5.5. En de voorsprong op Argon bedraagt slechts 3 punten (71,0 % tegen 68,0 %).
Google citeert ook het Chrome-team, dat rapporteerde dat Carbon meer dan 10 keer beter presteerde dan een groot model van een ander, niet genoemd lab, voor het produceren van kwalitatieve patches, en Wiz, die Carbon aan de top ziet op benchmarks voor web penetration testing.
Gemini 4 Carbon: taken van meerdere dagen en minder valsspelen, volgens Google
Carbon is ontworpen voor lange engineeringproblemen: intern hebben Google-teams gezien hoe het dagenlang werkte om de oorzaak van subtiele bugs te vinden en ze te corrigeren in grote codebases. Het bedrijf benadrukt ook de alignment. Op Terminal-Bench 4.0 daalt succesvol valsspelen naar 0,0 % en de pogingen naar 0,4 %. Ernstige misalignment-waarschuwingen nemen met bijna 80 % af in zijn interne code-omgevingen, en ongefundeerde beweringen komen ongeveer 2 keer minder voor dan bij Argon. Op de prompt injection-test van Gray Swan slaagde geen enkele aanval (0 %, tegen 0,7 % voor Argon en 1,0 % voor Opus 5.5). Deze metingen zijn gepubliceerd door Google en grotendeels intern: alleen tests buiten zijn teams zullen uitwijzen of ze standhouden.
Prijs van Gemini 4 Carbon: $2 en $10 bij lancering, daarna $4 en $20
Carbon kost $2 per miljoen input tokens en $10 per output token tijdens de lanceringperiode, net als Argon, met een korting van 95 % op gecachte input tokens. Daarna gaat het tarief naar $4 en $20, volgens de voetnoot van de aankondiging. Google geeft geen einddatum voor deze aanbieding voor Carbon.
Zullen deze scores standhouden wanneer Carbon de kring van geselecteerde verdedigers verlaat om bij de ontwikkelaars terecht te komen, op een datum die Google nog niet heeft vastgesteld?
