Google presentó el miércoles 28 de octubre Gemini 4 Carbon, su nuevo modelo estrella, dos semanas después de la apertura pública de Argon. Se presenta como el número 1 en un índice de referencia, pero por solo un punto, y se enfoca principalmente en la ciberseguridad y en tareas que duran días. Por ahora, solo algunos defensores cibernéticos tienen acceso.
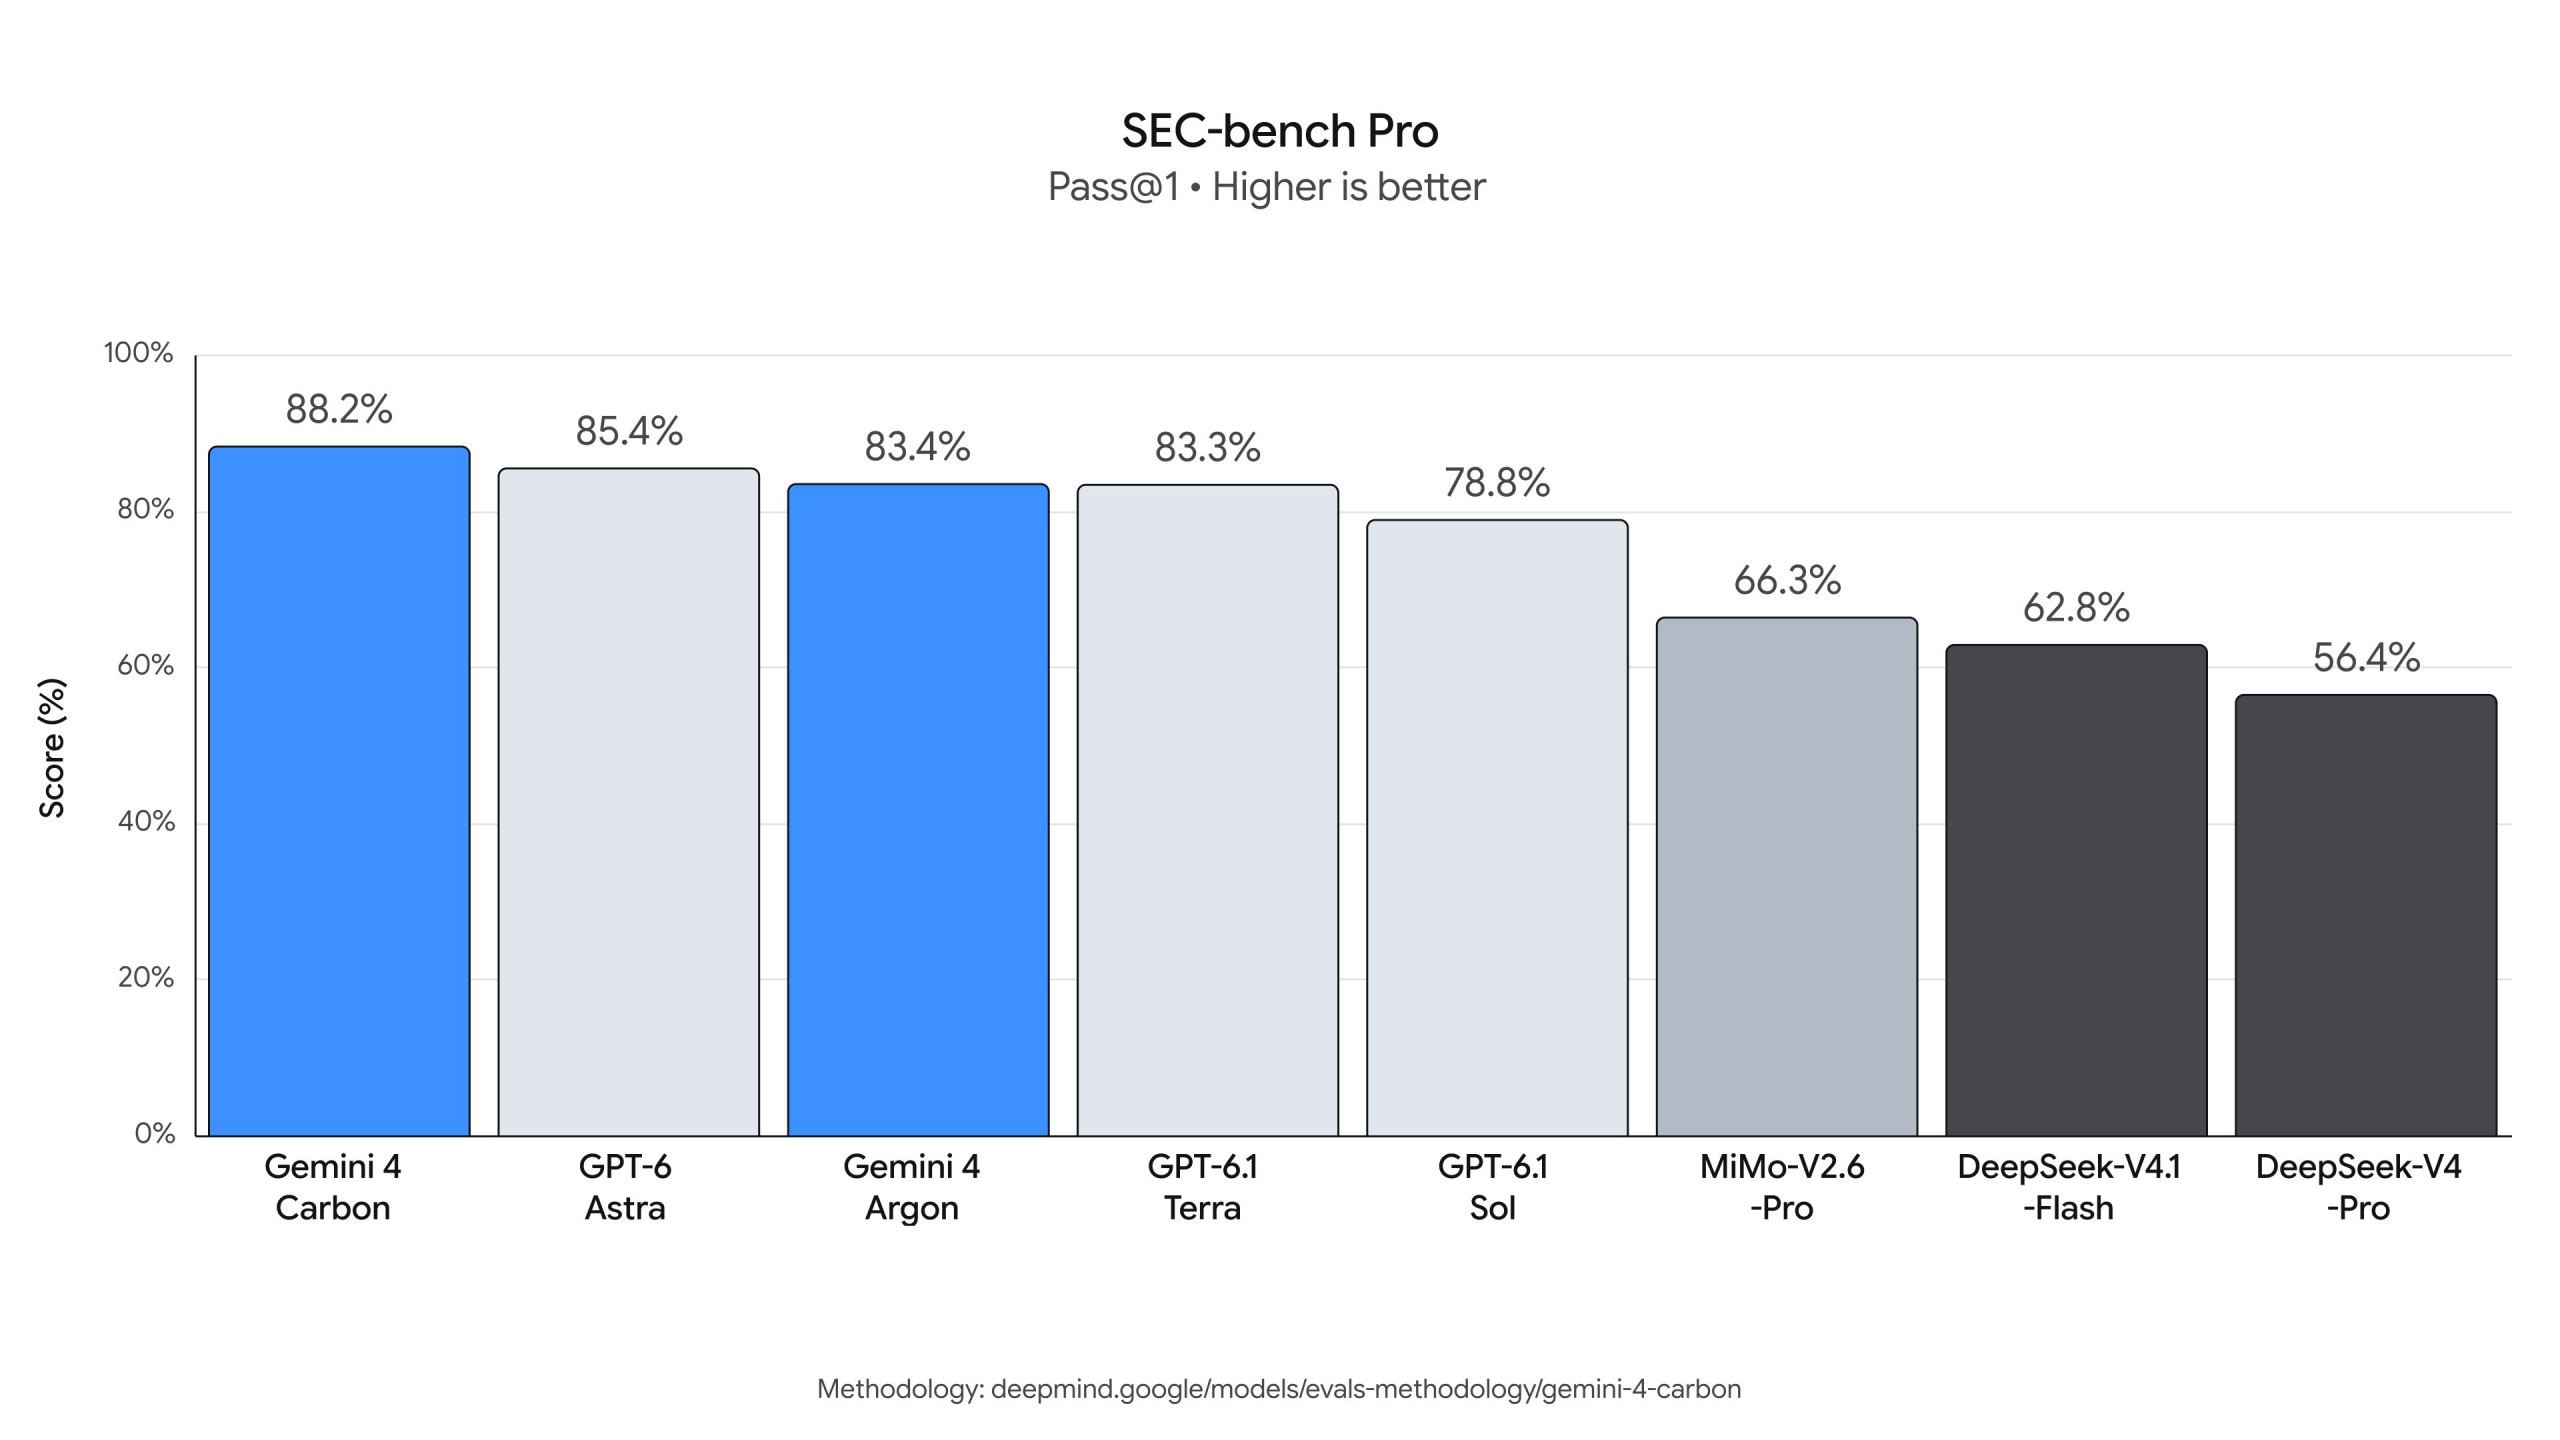
Una puntuación de 88,2 % en SEC-bench Pro, una prueba de detección de vulnerabilidades: Google destaca esta cifra en el anuncio de Gemini 4 Carbon, firmado por Koray Kavukcuoglu, vicepresidente senior de Google DeepMind y arquitecto jefe de IA en Google. El modelo llega dos semanas después de la apertura pública de Argon, el 13 de octubre. Google explica este ritmo por un trabajo en el que investigadores y modelos avanzan juntos y más rápido.
Sundar Pichai él mismo difundió el anuncio en X: recuerda que Google había avisado que lanzaría sus modelos a intervalos regulares, y repite las tres puntuaciones de ciberseguridad.
Sin embargo, Carbon no está abierto para todos. Esta semana, Google lo pone a disposición de un pequeño grupo de defensores cibernéticos, y luego ampliará el acceso a otros socios de confianza a través del programa Fairwind, lanzado el 2 de septiembre. Las reglas publicadas para Argon limitan el acceso a los equipos internos de ciberseguridad, respuesta a incidentes y pruebas de intrusión de las organizaciones admitidas. Contaba con más de 650 socios en su lanzamiento. Los desarrolladores, empresas y el público general llegarán después, tan pronto como sea posible, sin fecha anunciada. Google también dice participar en el proceso voluntario de pruebas previas del gobierno estadounidense.
Gemini 4 Carbon supera a Opus 5.5 por solo un punto en Artificial Analysis
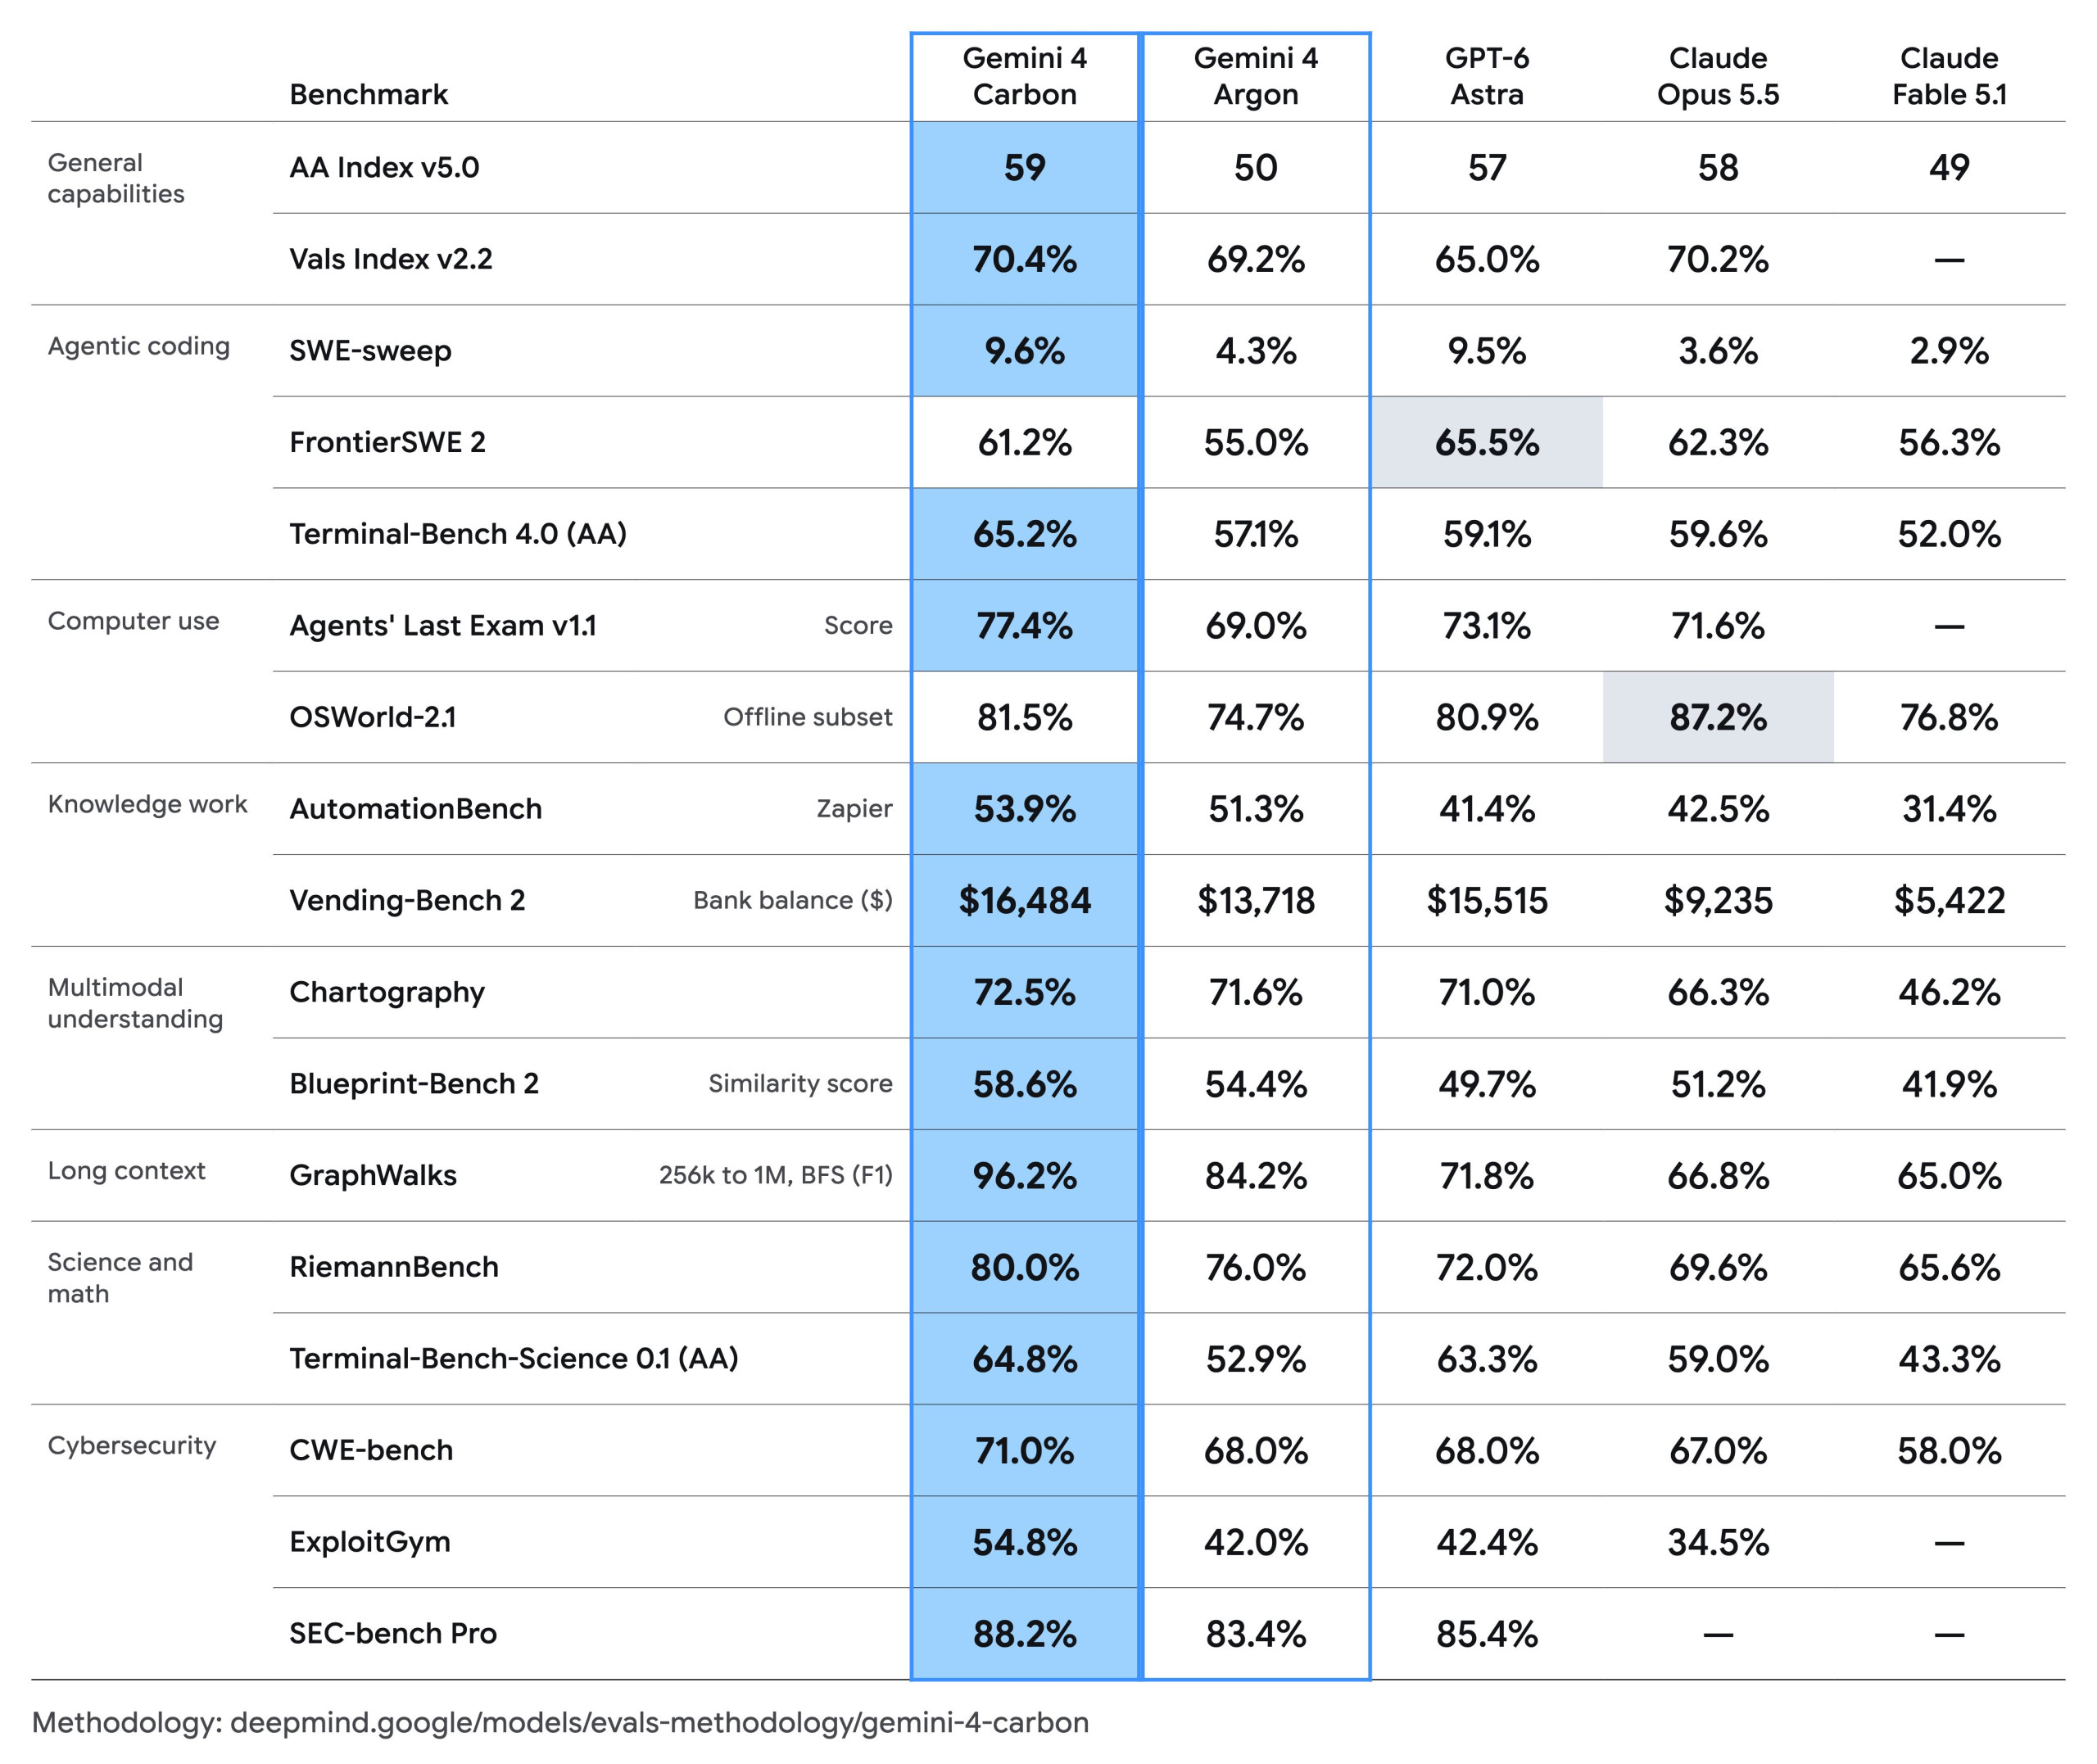
Google destaca el primer puesto de Carbon en el Índice de Inteligencia de Artificial Analysis, y la página del sitio lo confirma: versión 5.0, 59 puntos, número 1 de 52 modelos. En la tabla que acompaña el anuncio, Claude Opus 5.5 tiene 58 y GPT-6 Astra 57, mientras que Argon se queda en 50; estos tres puntajes aparecen en el ranking del sitio. La diferencia es similar en el Vals Index v2.2, donde Carbon obtiene 70,4 % frente a 70,2 % de Opus 5.5. Vals AI, que publica este ranking, coloca a Carbon en segundo lugar de 29 modelos, con 70,36 %.
Fuente: Google
| Prueba | Carbon | Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|---|
| AA Index v5.0 | 59 | 50 | 57 | 58 |
| Vals Index v2.2 | 70,4 % | 69,2 % | 65,0 % | 70,2 % |
| SEC-bench Pro | 88,2 % | 83,4 % | 85,4 % | – |
| ExploitGym | 54,8 % | 42,0 % | 42,4 % | 34,5 % |
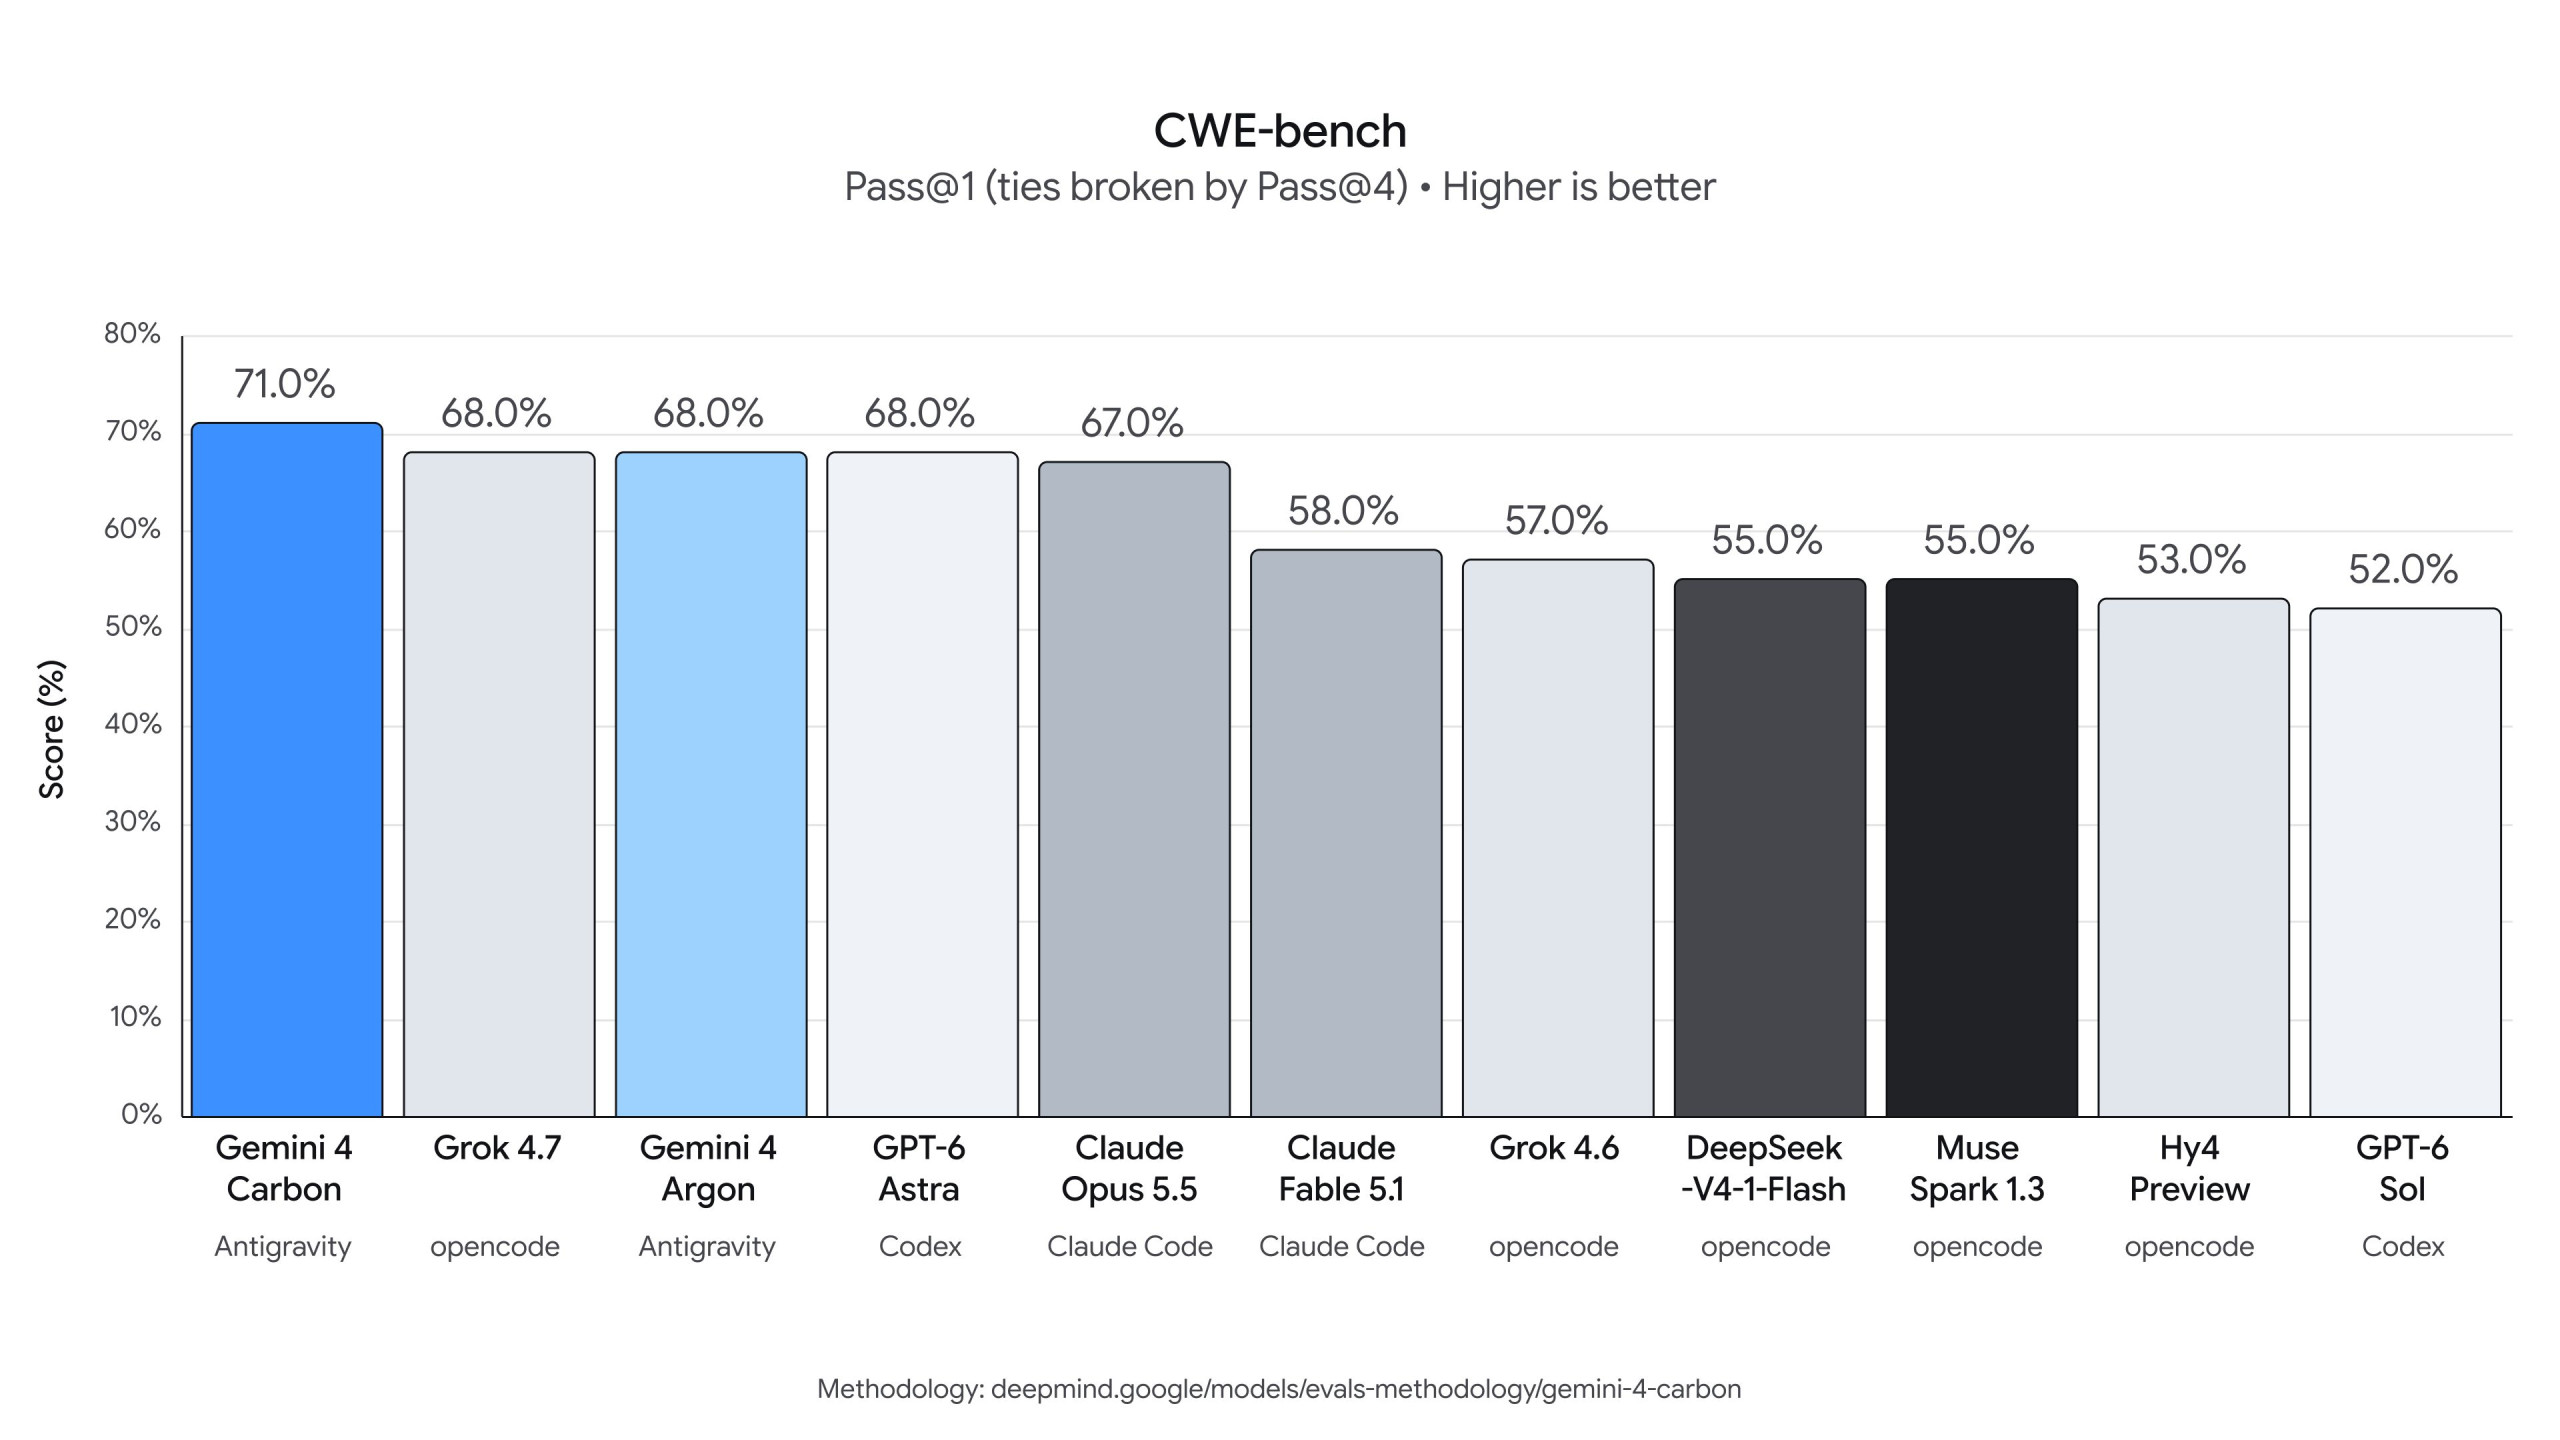
| CWE-bench | 71,0 % | 68,0 % | 68,0 % | 67,0 % |
| OSWorld-2.1 (offline) | 81,5 % | 74,7 % | 80,9 % | 87,2 % |
| FrontierSWE 2 | 61,2 % | 55,0 % | 65,5 % | 62,3 % |
Fuente: Google
Sin embargo, esta misma tabla muestra que Carbon no es primero en todas partes: Claude Opus 5.5 mantiene la ventaja en OSWorld-2.1, una prueba de uso de computadora (87,2 % contra 81,5 %), y GPT-6 Astra en FrontierSWE 2, una prueba de programación (65,5 % contra 61,2 %).
Gemini 4 Carbon con 88,2 % en ciberseguridad, pero con pruebas desiguales
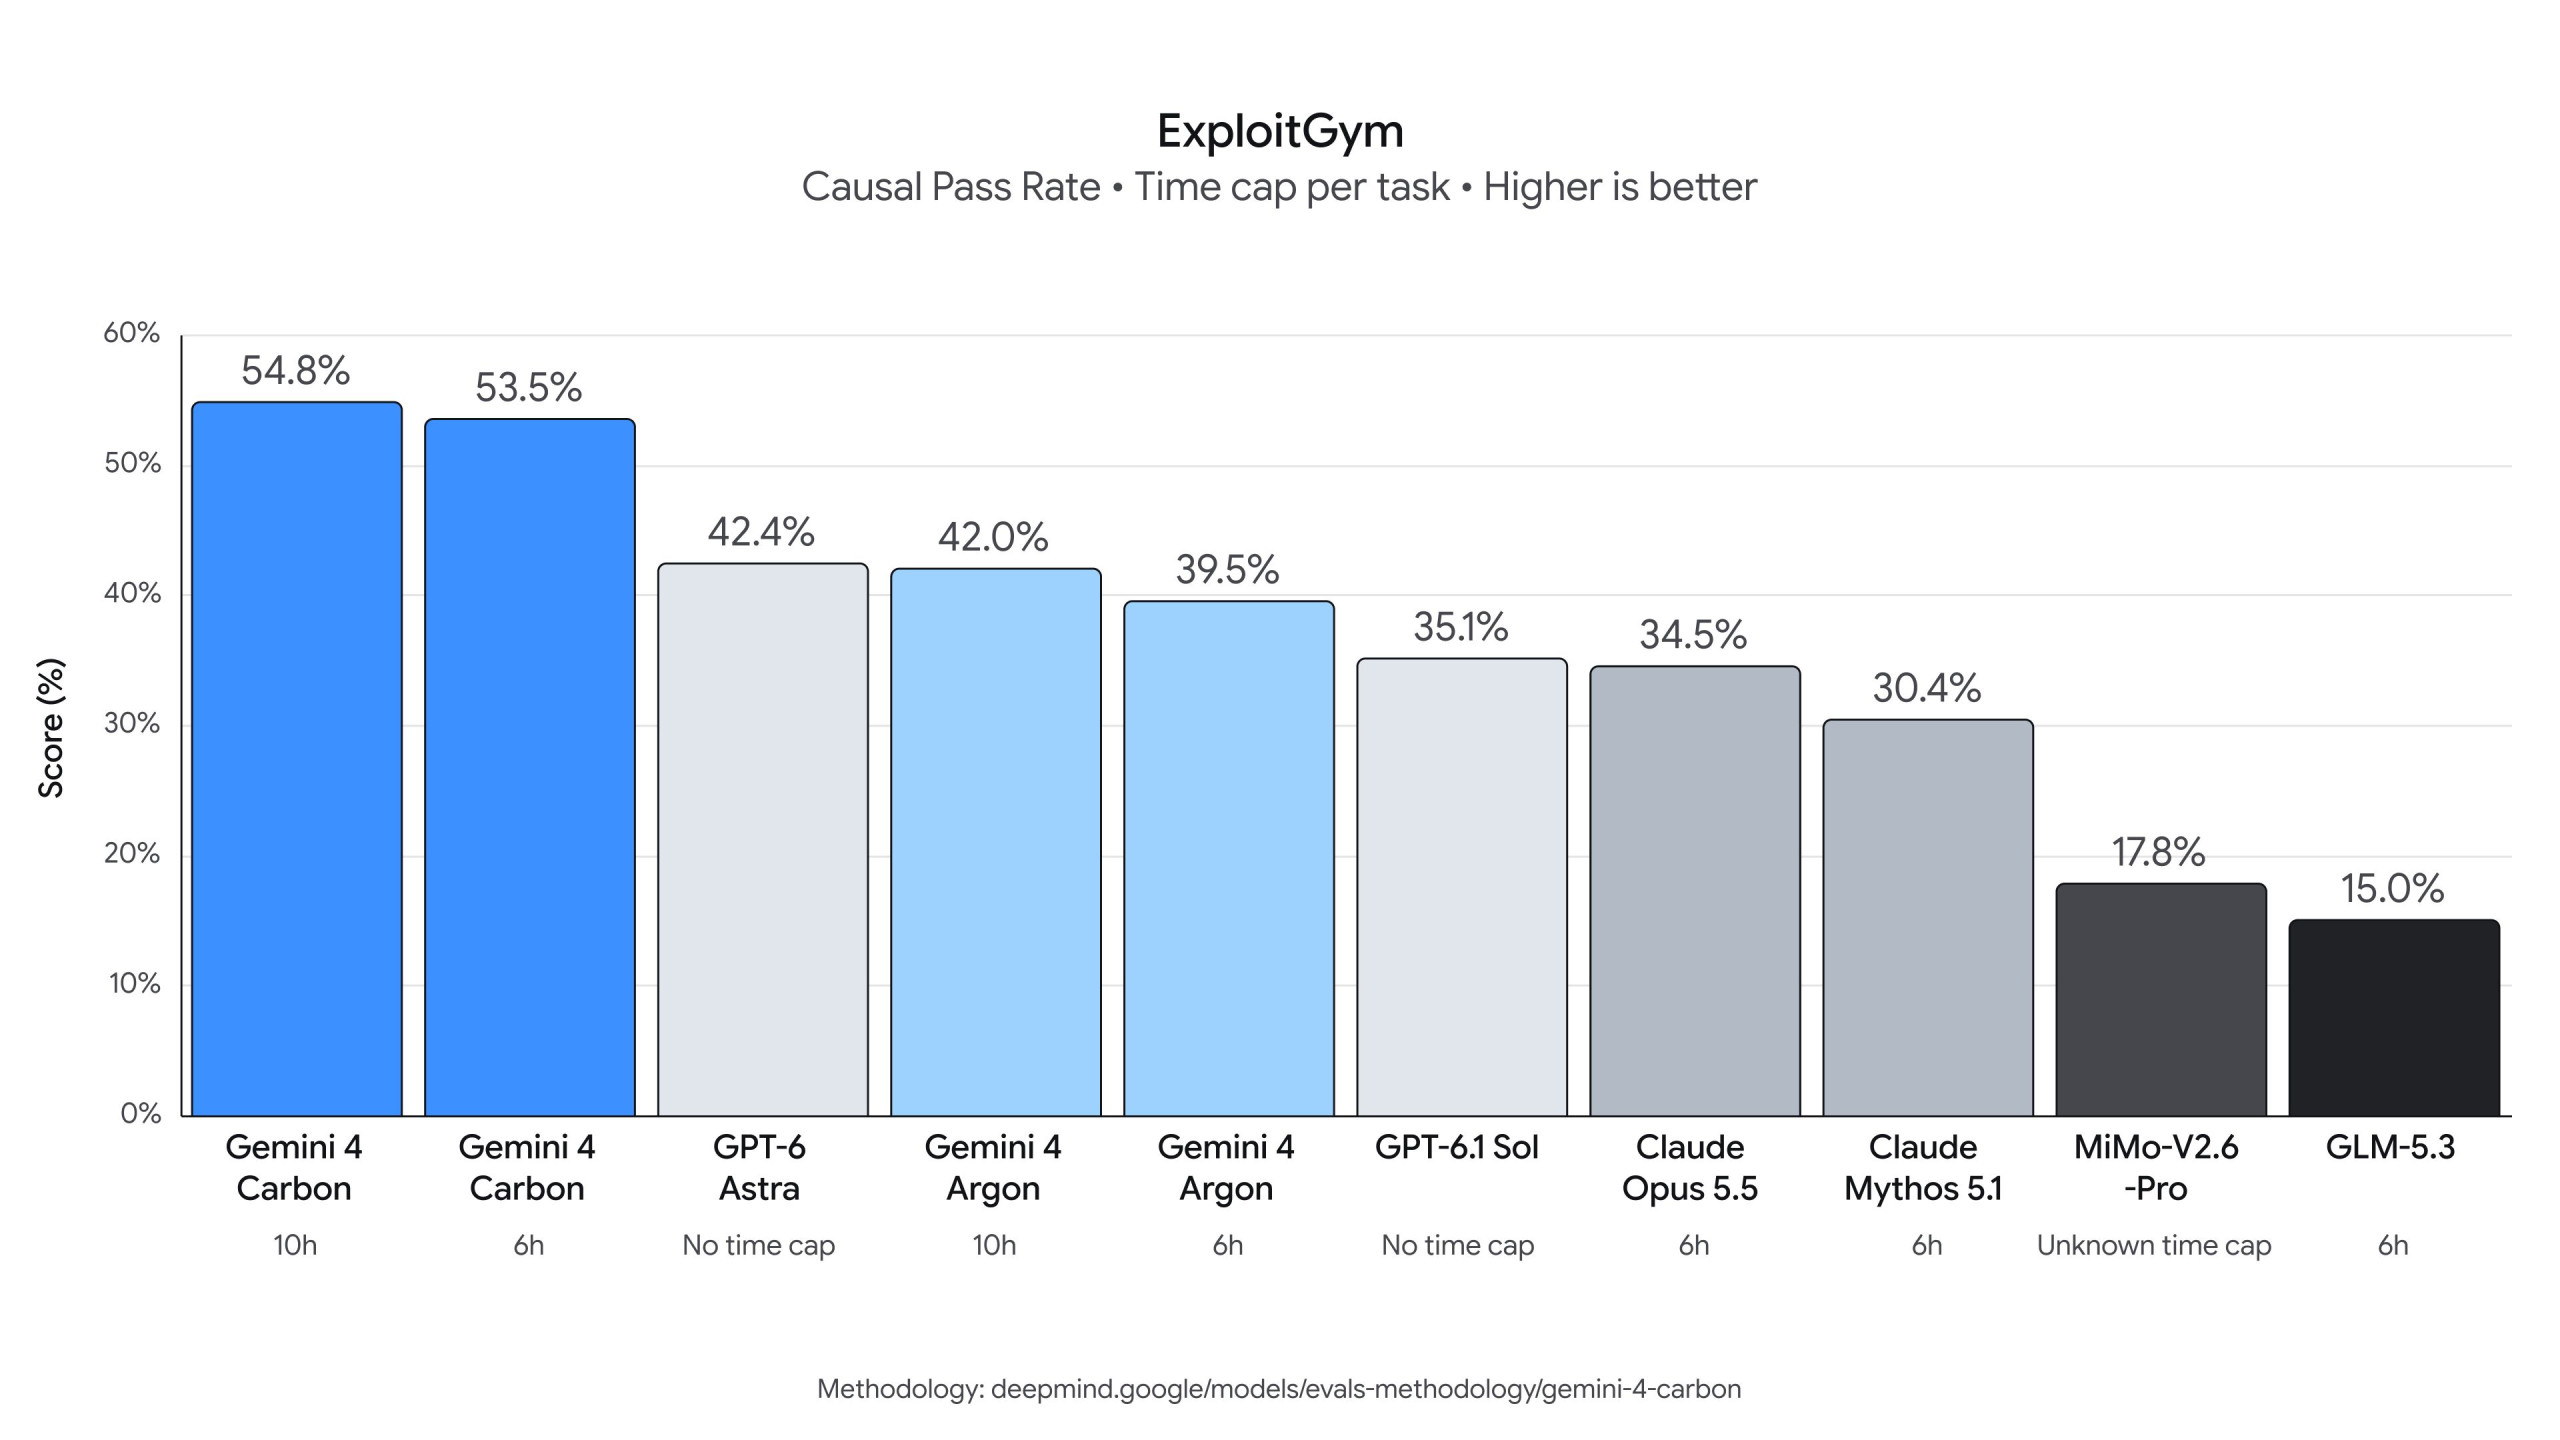
Para la ciberseguridad, Google destaca tres pruebas externas, realizadas sin salvaguardas: 88,2 % en SEC-bench Pro para encontrar vulnerabilidades, 54,8 % en ExploitGym para explotarlas, 71,0 % en CWE-bench para corregirlas. En SEC-bench Pro, GPT-6 Astra sigue con 85,4 % y Argon con 83,4 %. En ExploitGym, en cambio, la diferencia es más marcada: GPT-6 Astra tiene 42,4 % y Claude Opus 5.5 34,5 %.
Estas puntuaciones provienen de Google, y las condiciones de prueba no son las mismas para todos los modelos. El 54,8 % de Carbon corresponde a un límite de 10 horas por tarea. Con 6 horas, baja a 53,5 %, lo que lo deja delante de GPT-6 Astra, probado sin límite de tiempo, y delante de Opus 5.5, limitado a 6 horas. En CWE-bench, los modelos tampoco usan la misma herramienta de programación: Antigravity para Carbon, Codex para GPT-6 Astra, Claude Code para Opus 5.5. Y la ventaja sobre Argon es de 3 puntos (71,0 % contra 68,0 %).
Google también cita al equipo de Chrome, que reportó que Carbon hizo más de 10 veces mejor que un gran modelo de otro laboratorio, no nombrado, para producir correcciones de calidad, y a Wiz, que observa a Carbon en cabeza en benchmarks de pruebas de intrusión web.
Gemini 4 Carbon: tareas de varios días y menos trampas, según Google
Carbon está diseñado para problemas de ingeniería largos: internamente, los equipos de Google lo han visto trabajar durante días para encontrar la causa de errores sutiles y corregirlos en grandes bases de código. La empresa también insiste en el alineamiento. En Terminal-Bench 4.0, el éxito de trampas cae a 10,0 % y los intentos a 0,4 %. Las alertas de desalineamiento graves bajan cerca del 80 % en sus entornos internos de código, y las afirmaciones sin fundamento son aproximadamente 2 veces menos numerosas que con Argon. En la prueba de inyección de prompt de Gray Swan, ningún ataque tuvo éxito (0 %, contra 0,7 % para Argon y 1,0 % para Opus 5.5). Estas medidas son publicadas por Google y en gran parte internas: solo pruebas realizadas fuera de sus equipos dirán si se confirman.
Precio de Gemini 4 Carbon: 2 $ y 10 $ al lanzamiento, luego 4 $ y 20 $
Carbon se cobra 2 $ por millón de tokens de entrada y 10 $ por salida durante el período de lanzamiento, como Argon, con un descuento del 95 % en tokens de entrada almacenados en caché. Luego, la tarifa pasará a 4 $ y 20 $, según la nota al pie del anuncio. Google no da la fecha de fin de esta oferta para Carbon.
¿Mantendrán estas puntuaciones cuando Carbon salga del círculo de defensores seleccionados para llegar a los desarrolladores, en una fecha que Google no ha fijado?
