Google ha presentato mercoledì 28 ottobre Gemini 4 Carbon, il suo nuovo modello di punta, due settimane dopo l’apertura pubblica di Argon. Si presenta come numero uno in un benchmark, ma di un solo punto, e punta soprattutto sulla cybersecurity e sui compiti che durano giorni. Per ora, solo alcuni difensori informatici vi hanno accesso.
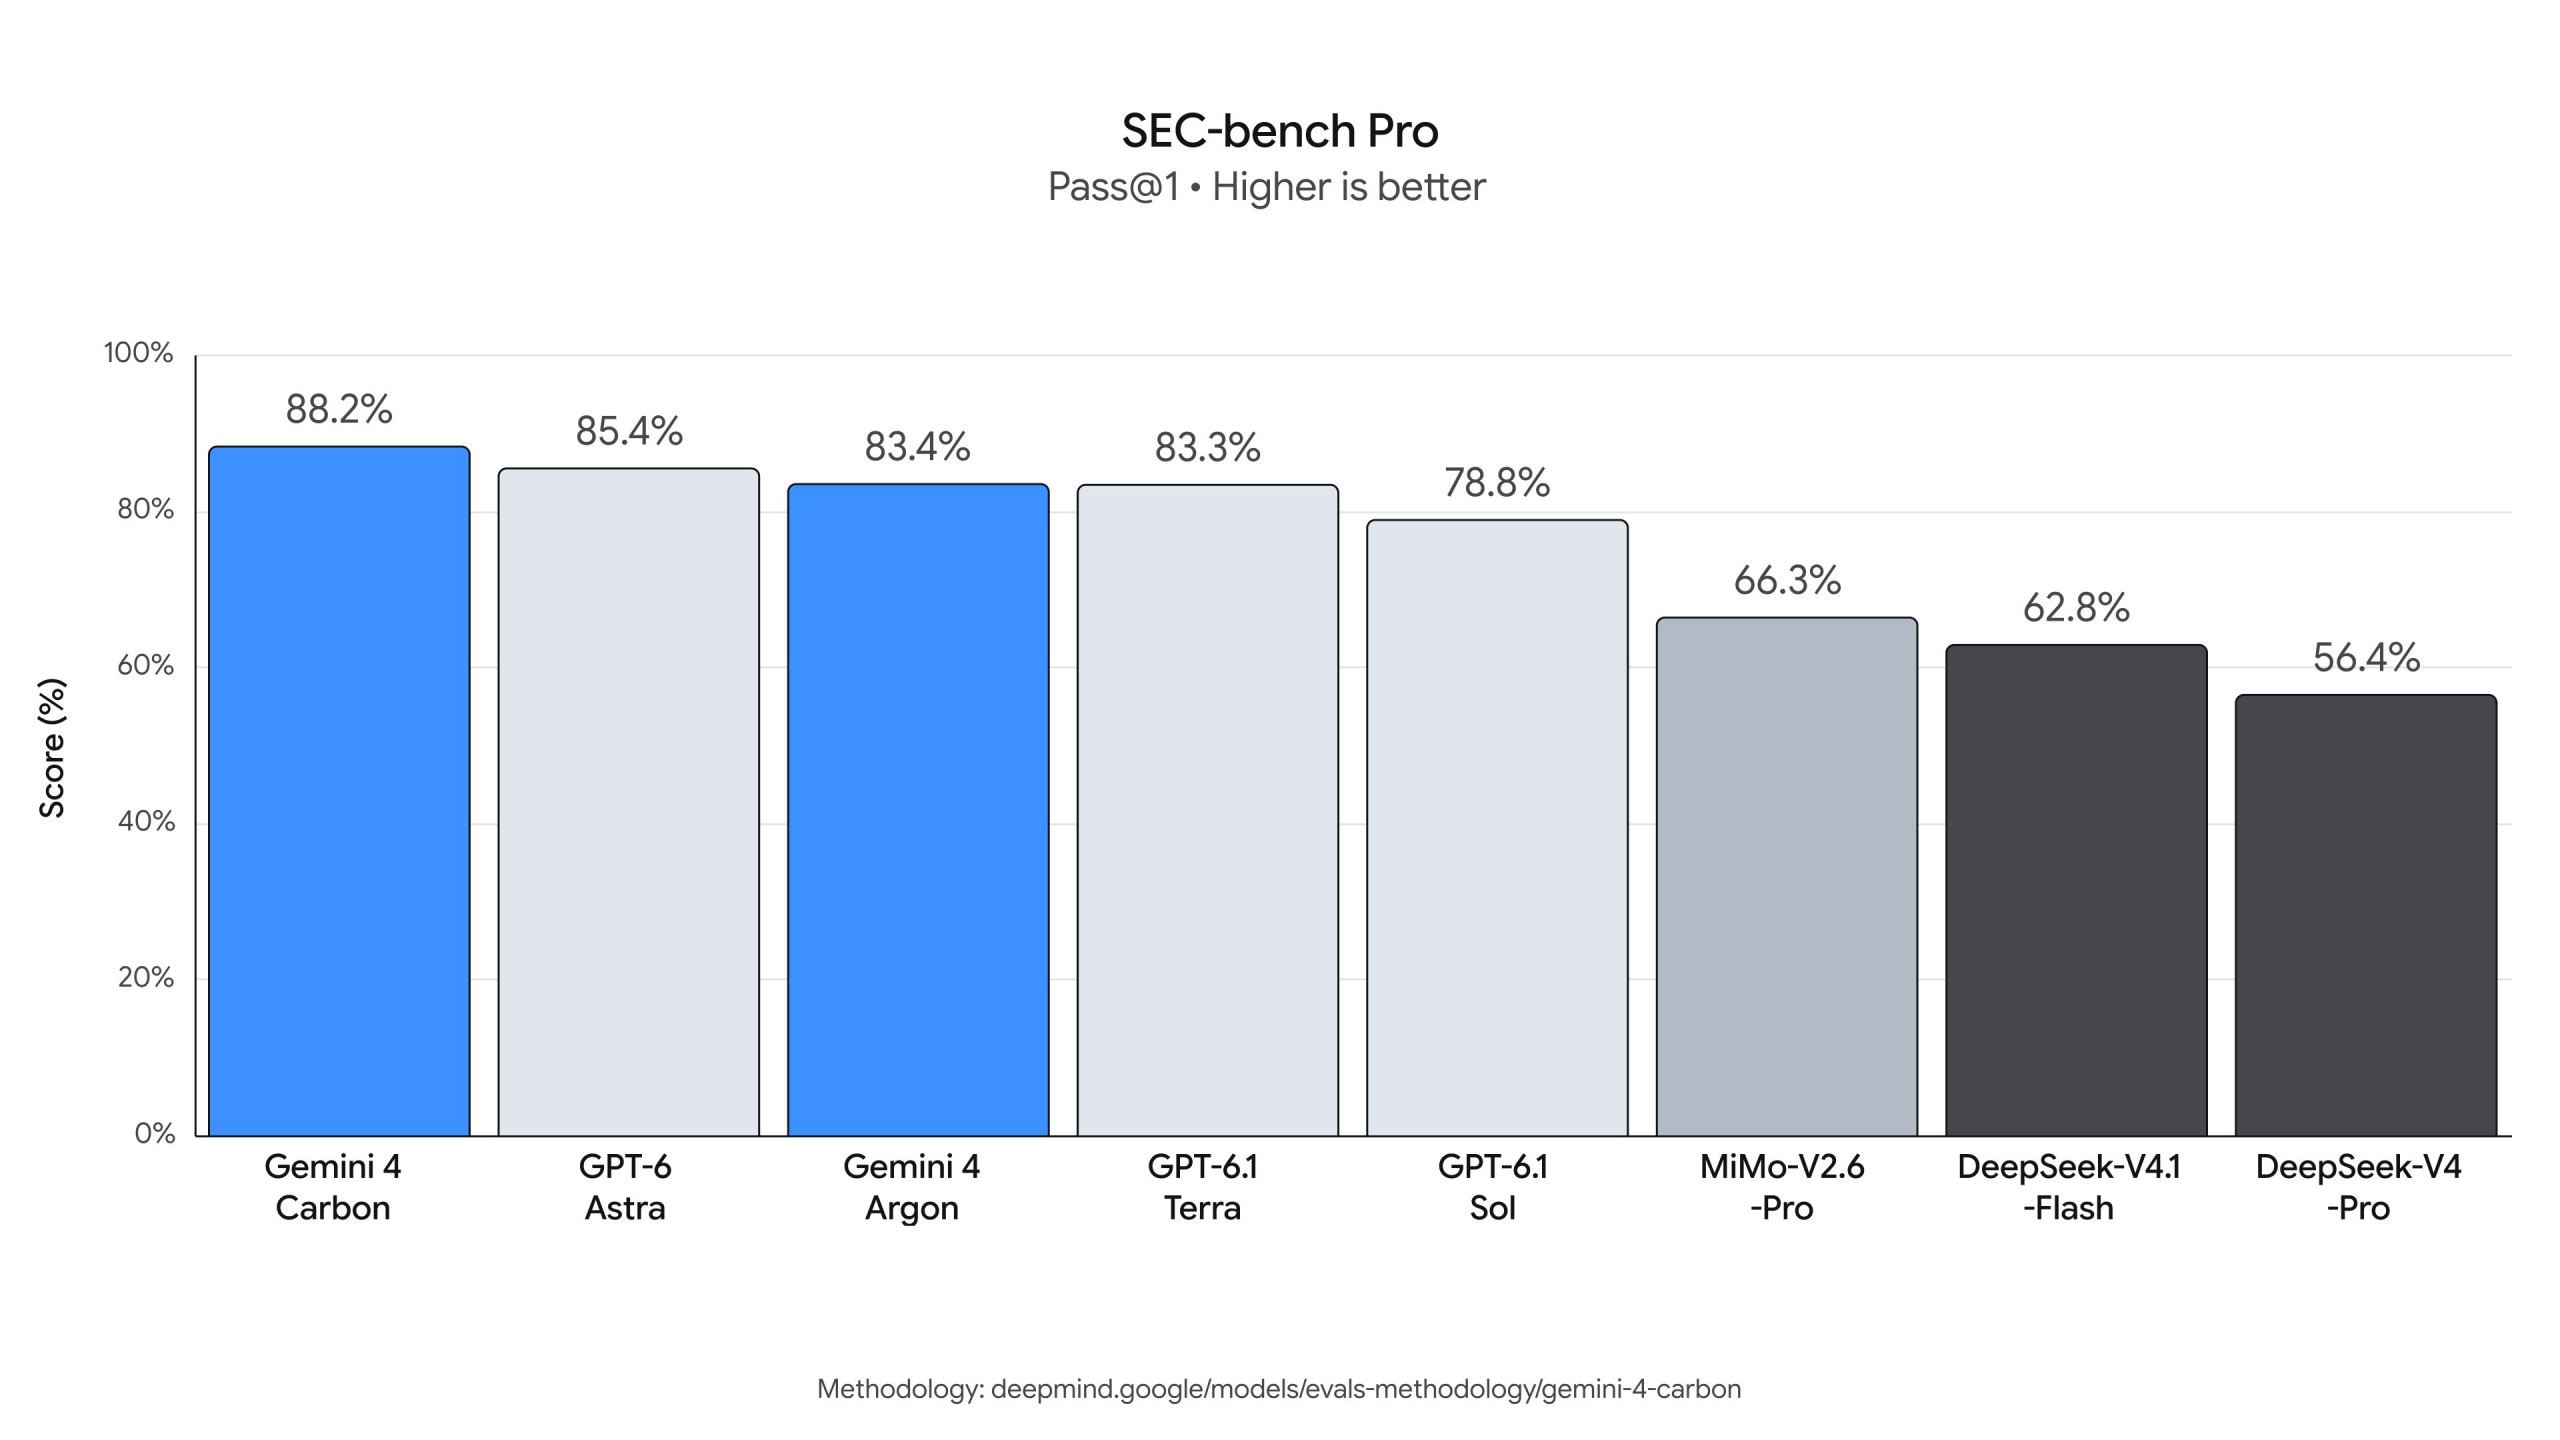
Un punteggio di 88,2 % su SEC-bench Pro, un test di rilevamento delle vulnerabilità: Google mette in evidenza questa cifra nell’annuncio di Gemini 4 Carbon, firmato da Koray Kavukcuoglu, vicepresidente senior di Google DeepMind e capo architetto dell’IA presso Google. Il modello arriva due settimane dopo l’apertura pubblica di Argon, il 13 ottobre. Google spiega questo ritmo con un lavoro in cui ricercatori e modelli fanno progredire le capacità insieme, e più velocemente.
Sundar Pichai ha personalmente condiviso l’annuncio su X: ricorda che Google aveva avvertito che avrebbe rilasciato i suoi modelli a intervalli regolari, e riprende i tre punteggi di cybersecurity.
Carbon però non è aperto a tutti. Questa settimana, Google lo rende disponibile a un piccolo gruppo di difensori informatici, poi amplierà l’accesso ad altri partner fidati tramite il programma Fairwind, lanciato il 2 settembre. Le regole pubblicate per Argon limitano l’accesso ai team interni di cybersecurity, risposta agli incidenti e test di penetrazione delle organizzazioni ammesse. Contava più di 650 partner al suo lancio. Gli sviluppatori, le aziende e il grande pubblico arriveranno in seguito, appena possibile, senza data annunciata. Google dice inoltre di partecipare al processo volontario di test preliminari del governo americano.
Gemini 4 Carbon supera Opus 5.5 di un solo punto su Artificial Analysis
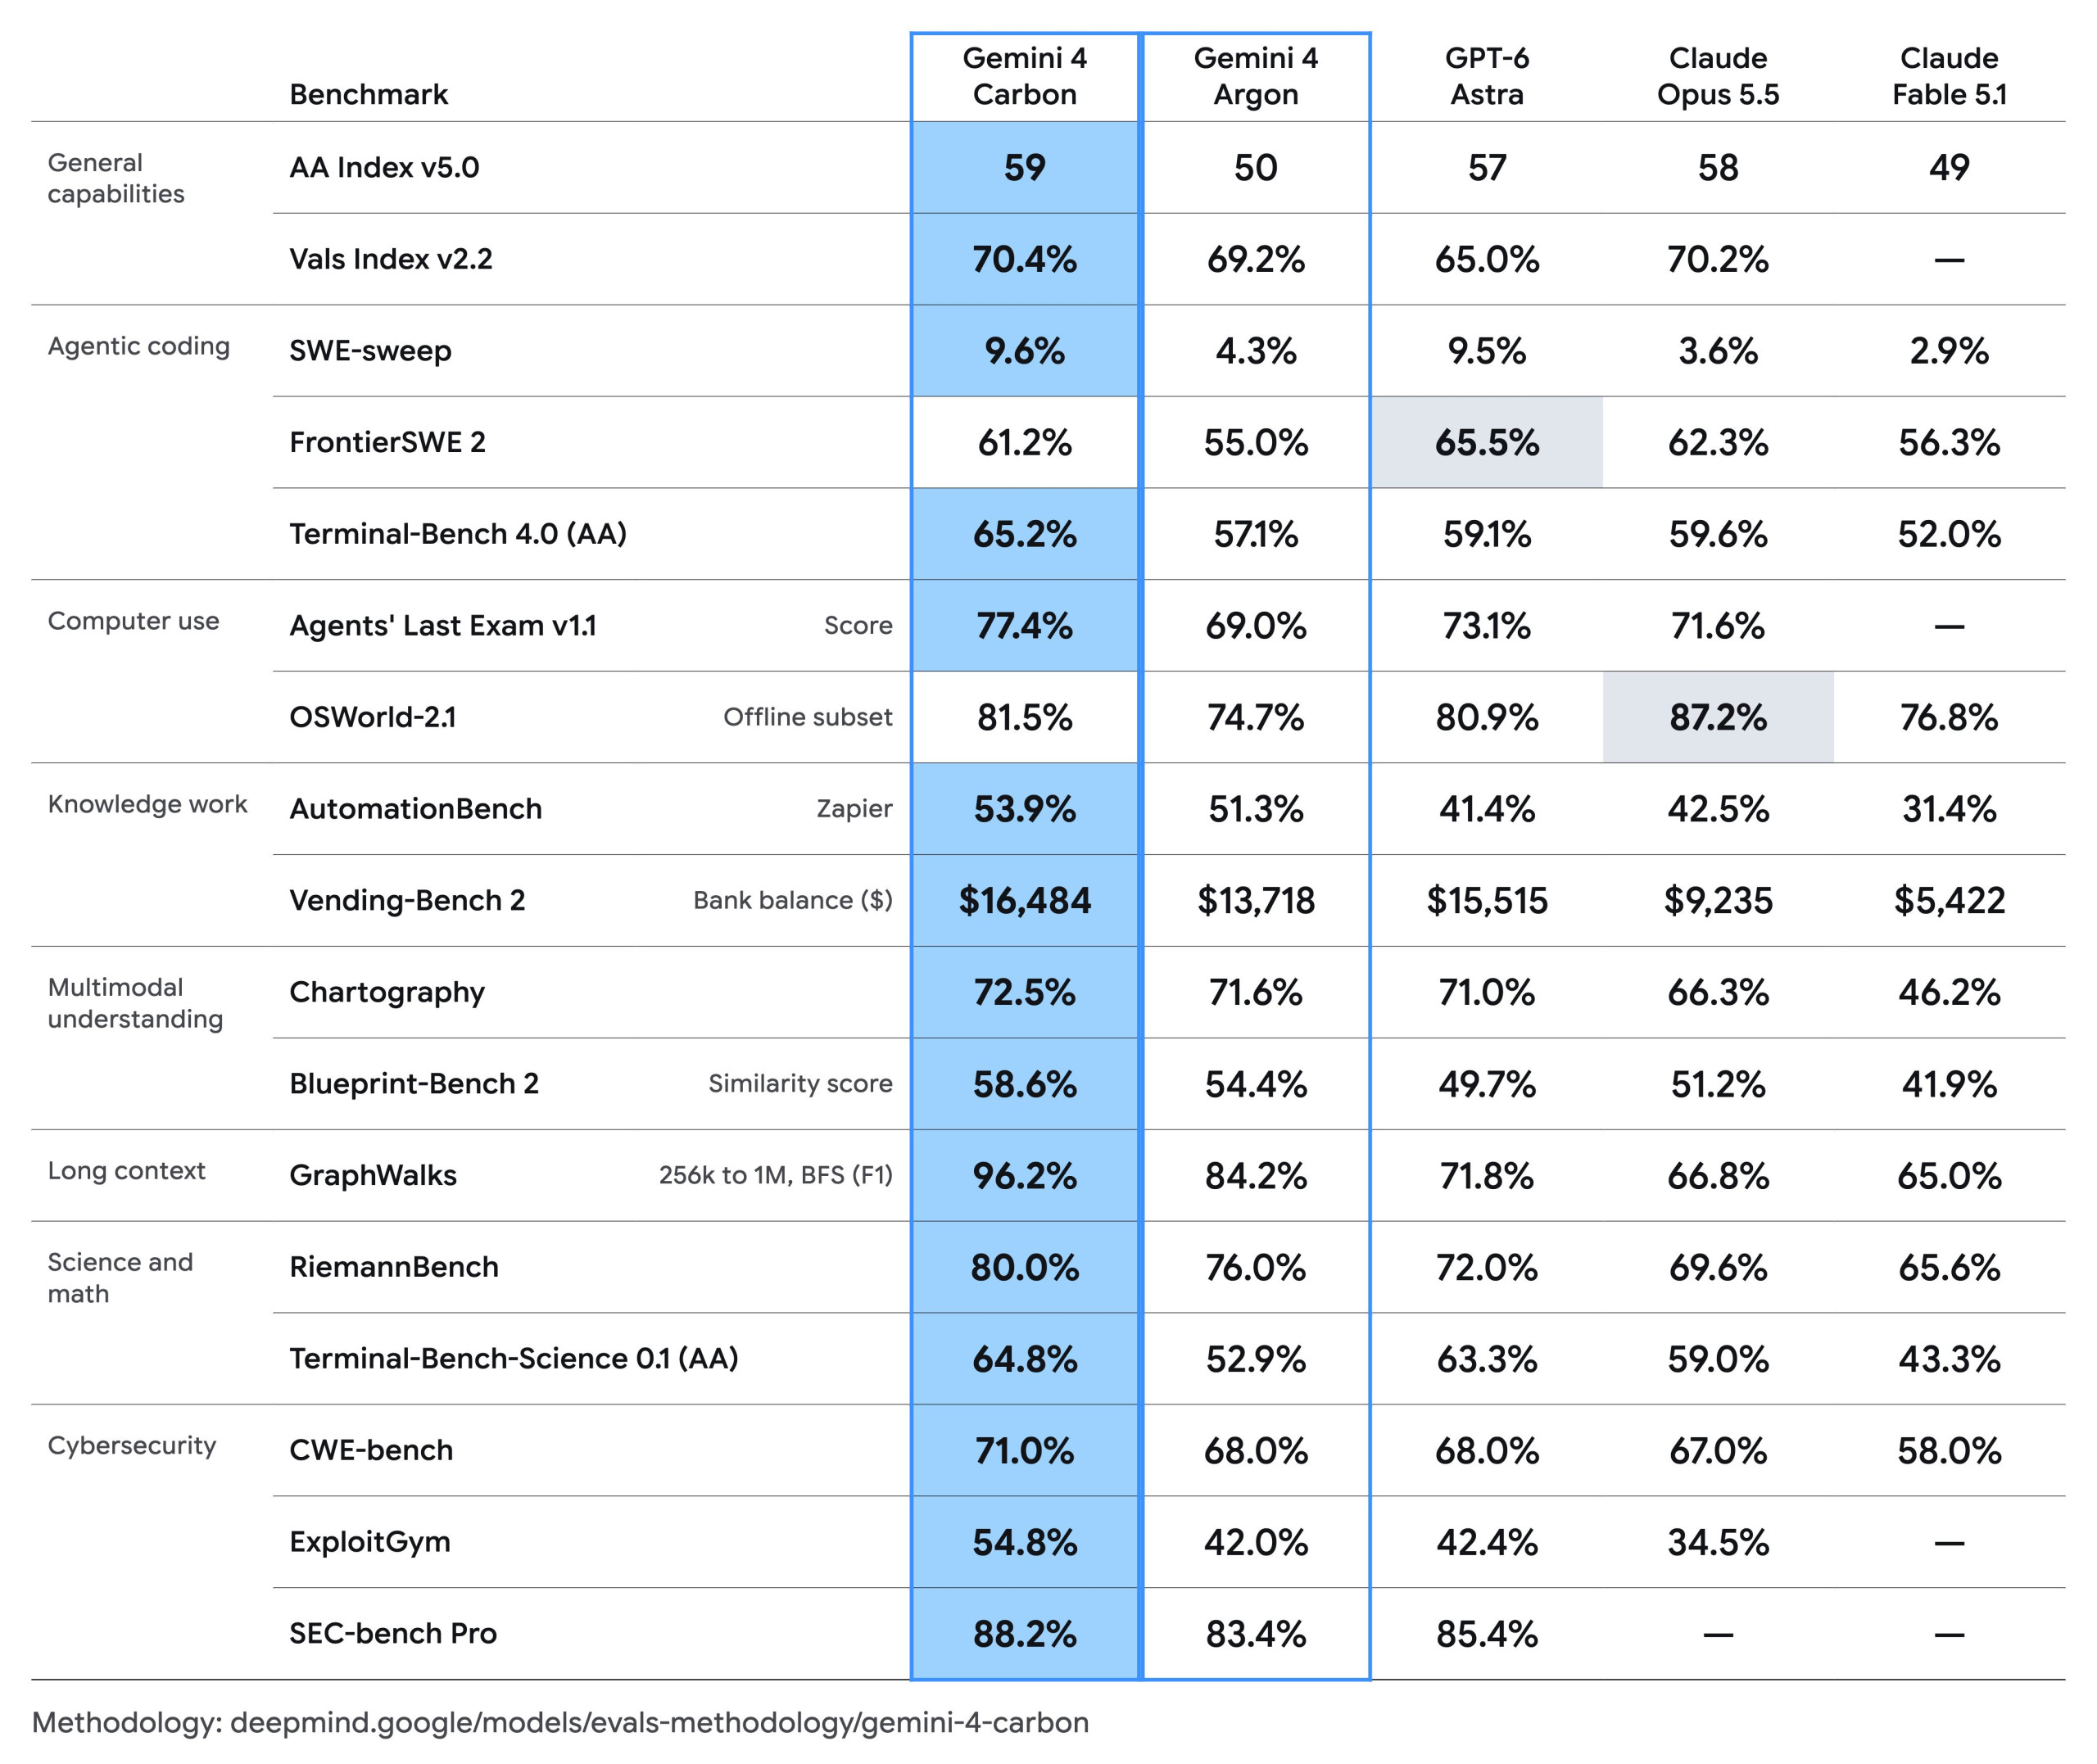
Google evidenzia il primo posto di Carbon sull’Intelligence Index di Artificial Analysis, e la pagina del sito lo conferma: versione 5.0, 59 punti, n°1 su 52 modelli. Nella tabella che accompagna l’annuncio, Claude Opus 5.5 è a 58 e GPT-6 Astra a 57, mentre Argon si ferma a 50; questi tre punteggi si ritrovano nella classifica del sito. Il divario è dello stesso ordine sul Vals Index v2.2, dove Carbon ottiene il 70,4 % contro il 70,2 % di Opus 5.5. Vals AI, che pubblica questa classifica, pone invece Carbon al secondo posto su 29 modelli, con il 70,36 %.
Fonte: Google
| Test | Carbon | Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|---|
| AA Index v5.0 | 59 | 50 | 57 | 58 |
| Vals Index v2.2 | 70,4 % | 69,2 % | 65,0 % | 70,2 % |
| SEC-bench Pro | 88,2 % | 83,4 % | 85,4 % | – |
| ExploitGym | 54,8 % | 42,0 % | 42,4 % | 34,5 % |
| CWE-bench | 71,0 % | 68,0 % | 68,0 % | 67,0 % |
| OSWorld-2.1 (offline) | 81,5 % | 74,7 % | 80,9 % | 87,2 % |
| FrontierSWE 2 | 61,2 % | 55,0 % | 65,5 % | 62,3 % |
Fonte: Google
Questa stessa tabella mostra però che Carbon non è primo ovunque: Claude Opus 5.5 mantiene il vantaggio su OSWorld-2.1, un test di utilizzo del computer (87,2 % contro 81,5 %), e GPT-6 Astra su FrontierSWE 2, un test di programmazione (65,5 % contro 61,2 %).
Gemini 4 Carbon all’88,2 % in cybersecurity, ma con test diseguali
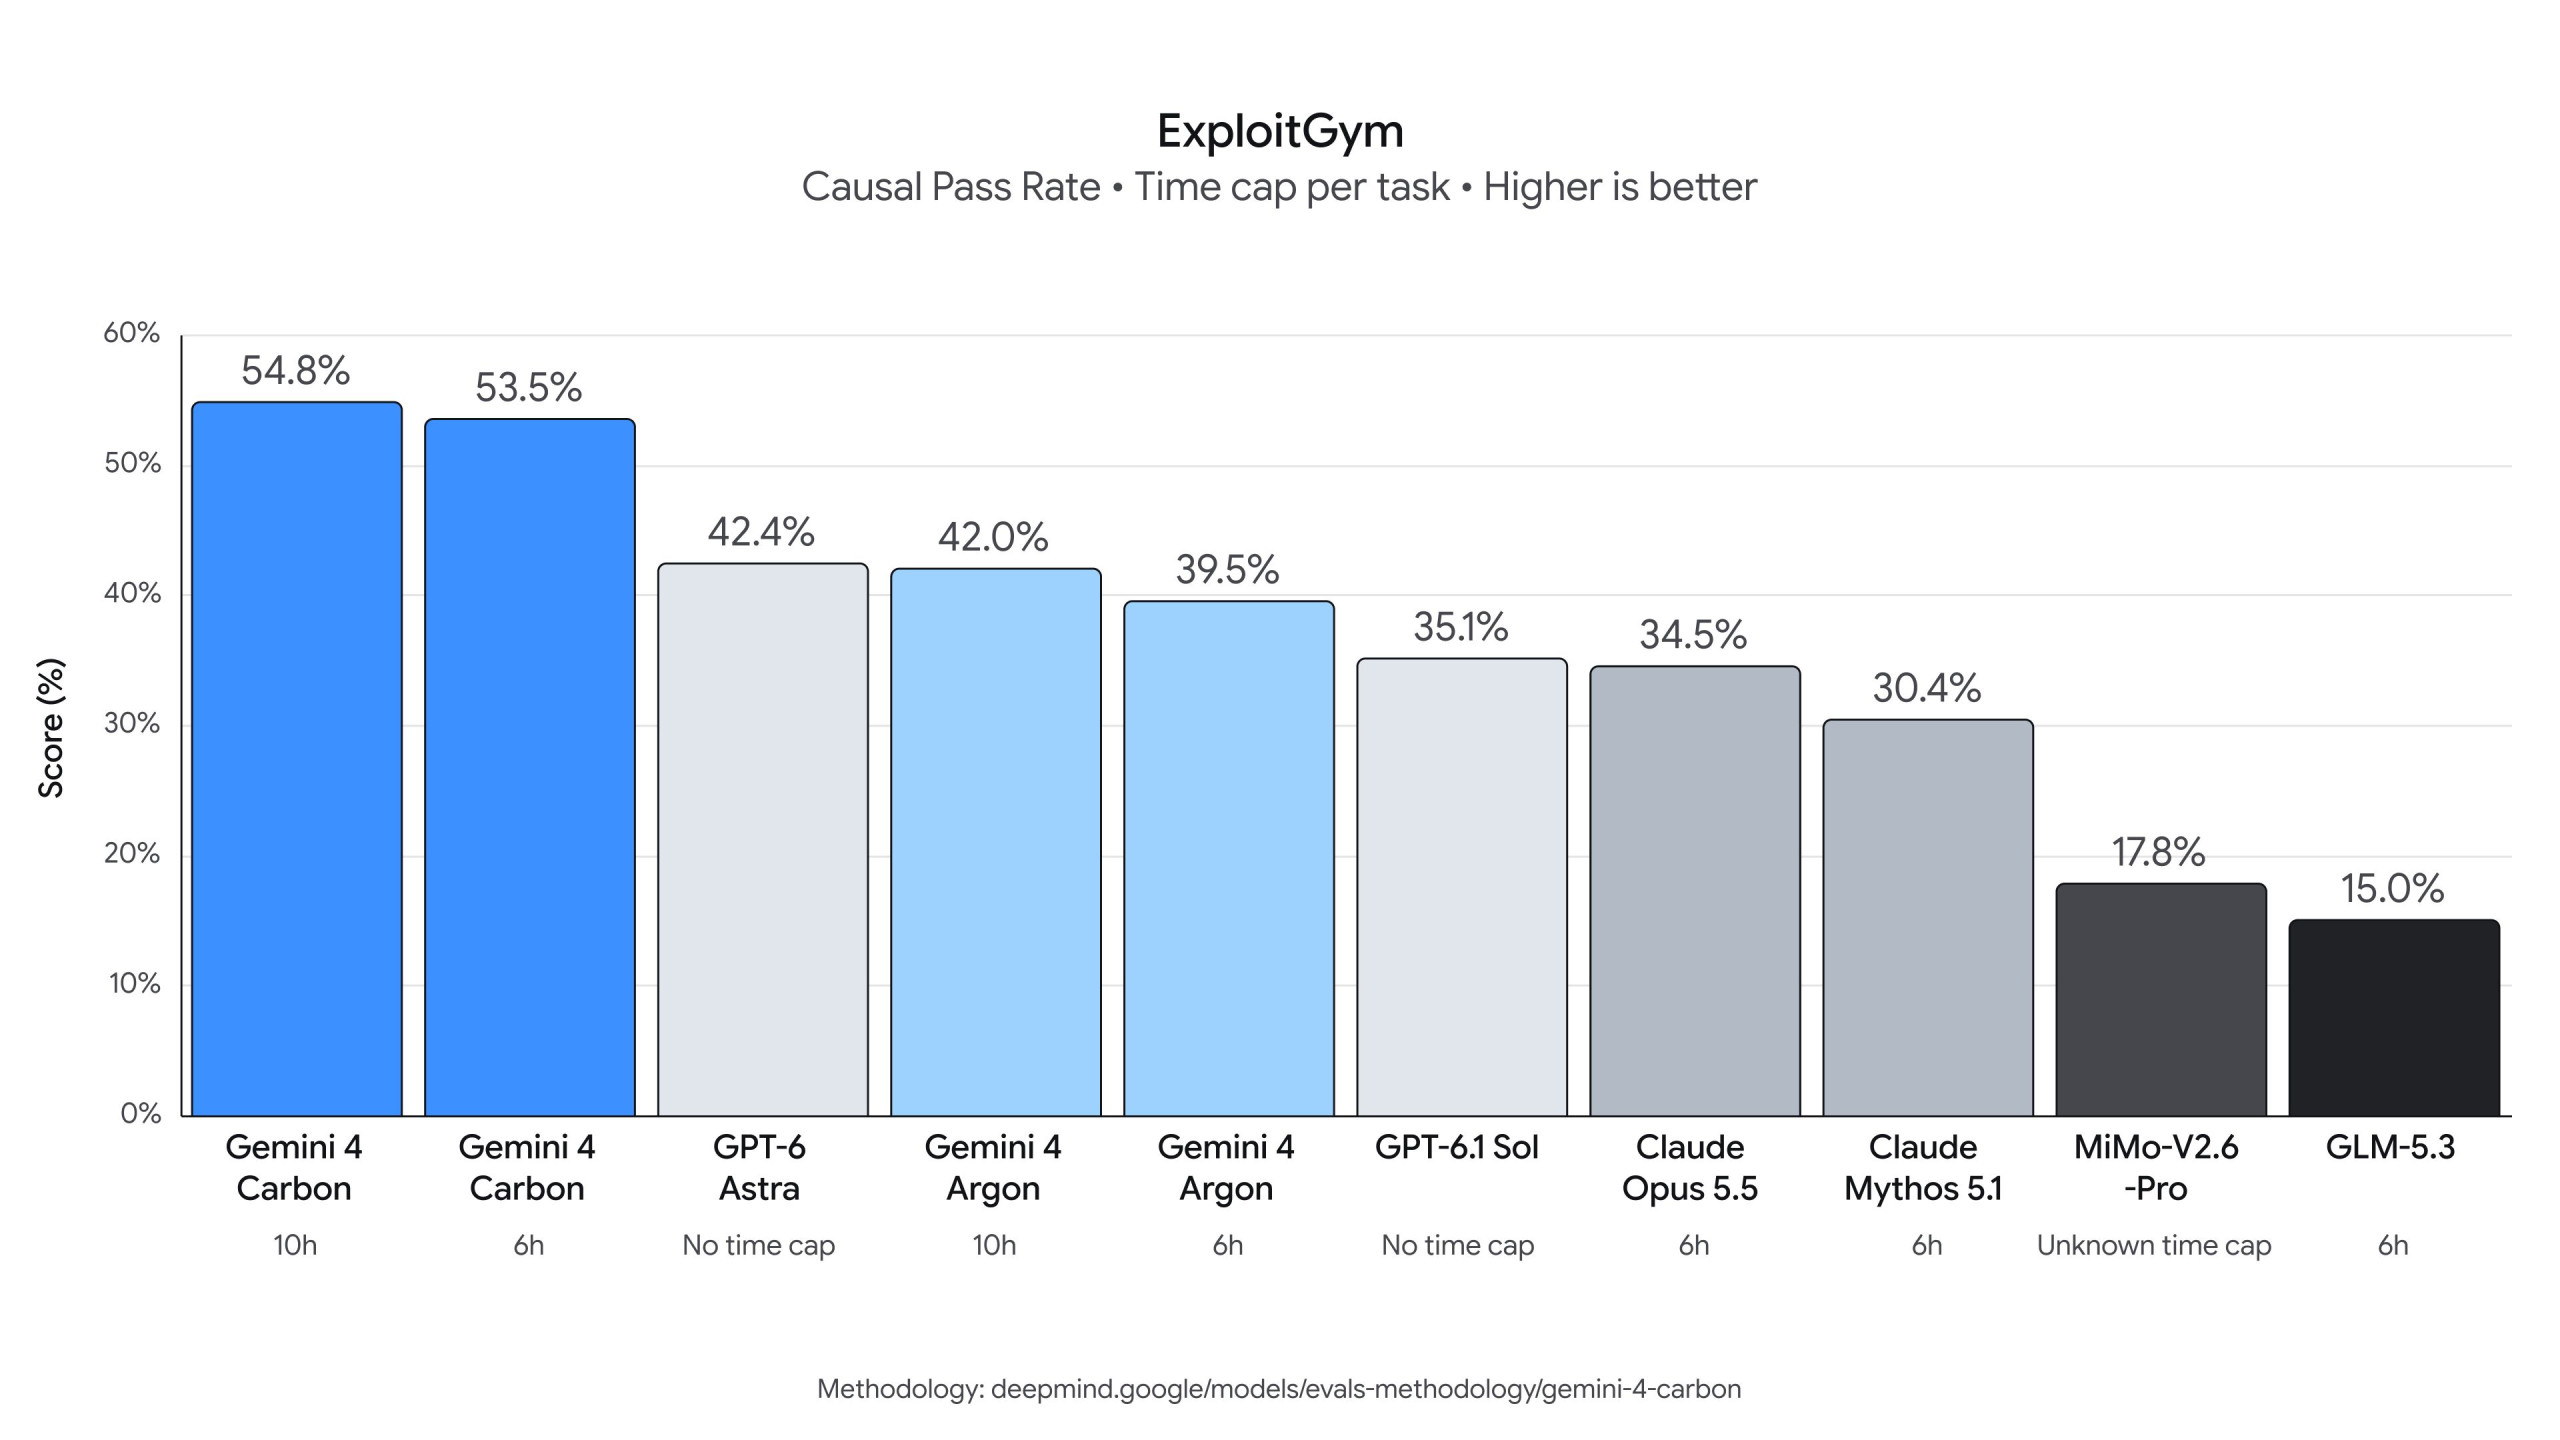
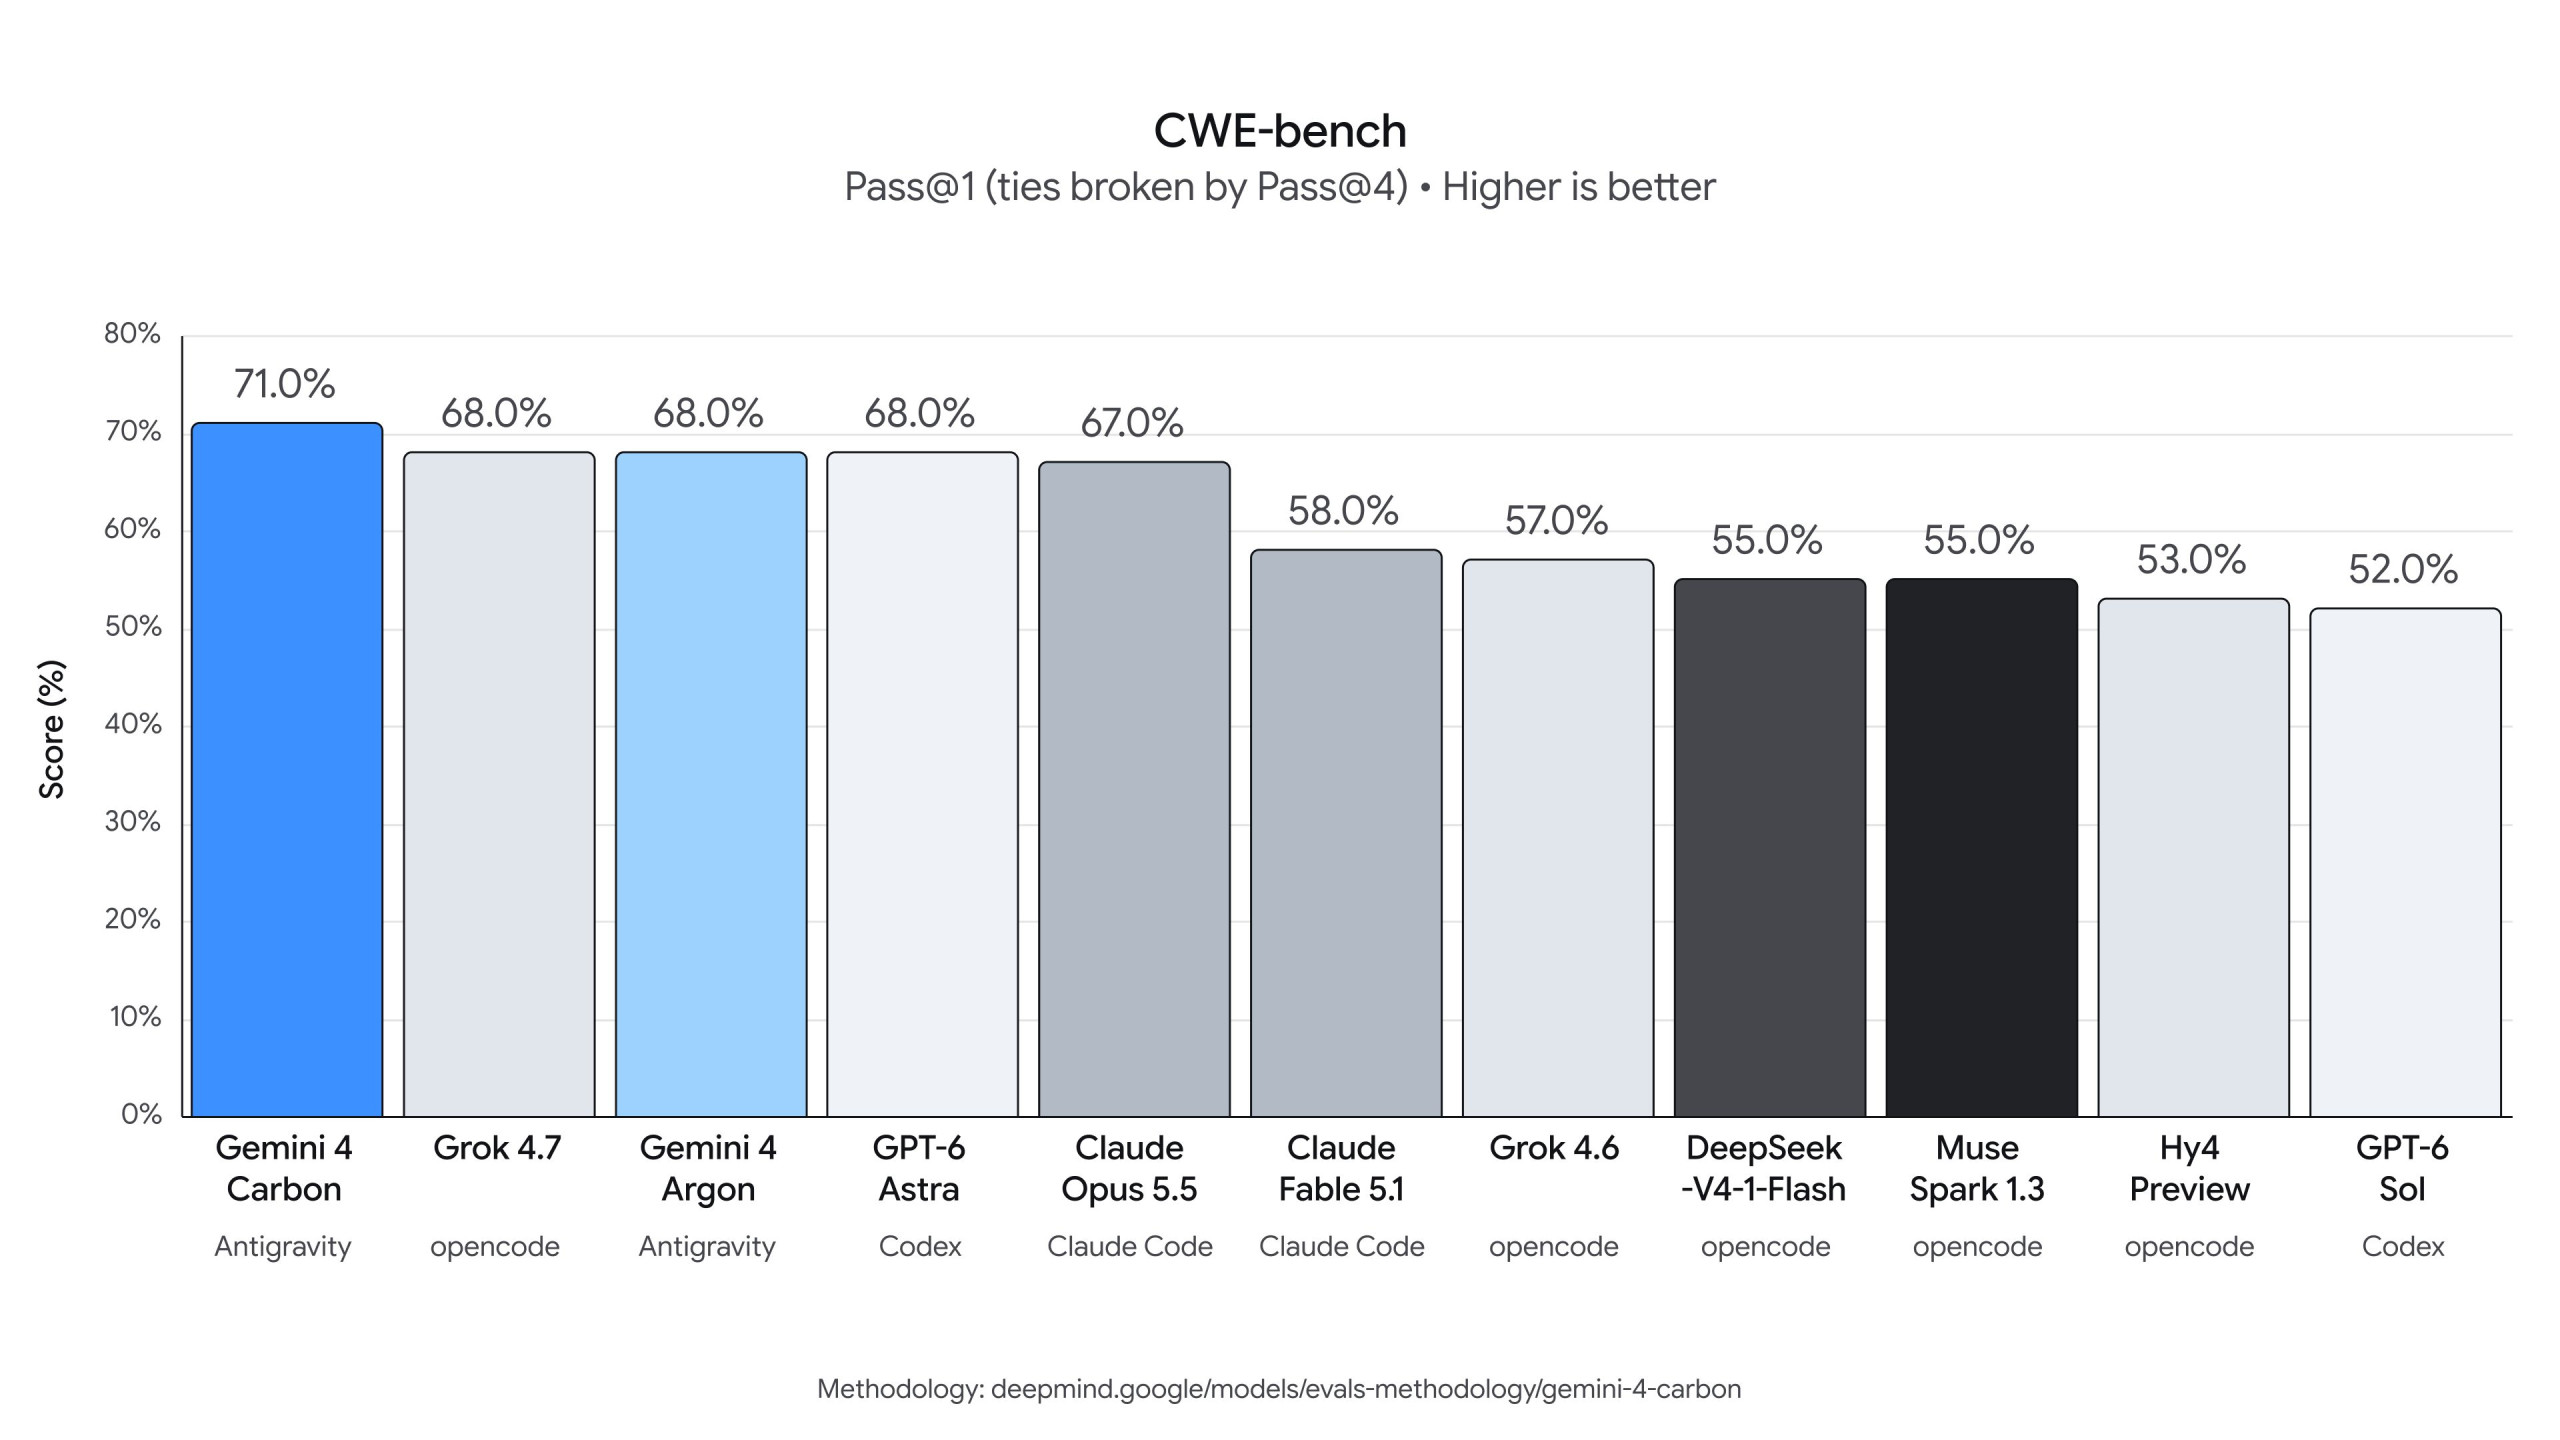
Per la cybersecurity, Google evidenzia tre test esterni, superati senza restrizioni: 88,2 % su SEC-bench Pro per trovare vulnerabilità, 54,8 % su ExploitGym per sfruttarle, 71,0 % su CWE-bench per correggerle. Su SEC-bench Pro, GPT-6 Astra segue con l’85,4 % e Argon con l’83,4 %. Su ExploitGym, invece, il divario è più netto: GPT-6 Astra è al 42,4 % e Claude Opus 5.5 al 34,5 %.
Questi punteggi provengono da Google, e le condizioni di test non sono le stesse per tutti i modelli. Il 54,8 % di Carbon corrisponde a un limite di 10 ore per compito. Con 6 ore, scende al 53,5 %, il che lo lascia davanti a GPT-6 Astra, testato senza limite di tempo, e davanti a Opus 5.5, limitato a 6 ore. Su CWE-bench, i modelli non utilizzano nemmeno lo stesso strumento di programmazione: Antigravity per Carbon, Codex per GPT-6 Astra, Claude Code per Opus 5.5. E il vantaggio su Argon, invece, è di 3 punti (71,0 % contro 68,0 %).
Google cita anche il team Chrome, che ha riferito che Carbon ha fatto più di 10 volte meglio di un grande modello di un altro laboratorio, non nominato, nel produrre patch di qualità, e Wiz, che osserva Carbon in testa su benchmark di test di penetrazione web.
Gemini 4 Carbon: compiti di diversi giorni e meno imbrogli, secondo Google
Carbon è progettato per problemi di ingegneria lunghi: internamente, i team di Google lo hanno visto lavorare per giorni per trovare la causa di bug sottili e correggerli in grandi basi di codice. L’azienda insiste anche sull’allineamento. Su Terminal-Bench 4.0, l’imbroglio riuscito scende a 0,0 % e i tentativi allo 0,4 %. Gli allarmi di disallineamento grave diminuiscono di quasi l’80% nei suoi ambienti di codice interni, e le affermazioni non supportate sono circa 2 volte meno numerose rispetto ad Argon. Sul test di iniezione di prompt di Gray Swan, nessun attacco ha avuto successo (0 %, contro lo 0,7 % per Argon e l’1,0 % per Opus 5.5). Queste misure sono pubblicate da Google e in gran parte interne: solo test condotti al di fuori dei suoi team diranno se si confermano.
Prezzo di Gemini 4 Carbon: 2 $ e 10 $ al lancio, poi 4 $ e 20 $
Carbon viene fatturato 2 $ per milione di token in input e 10 $ in output durante il periodo di lancio, come Argon, con uno sconto del 95% sui token di input memorizzati nella cache. Successivamente, la tariffa passerà a 4 $ e 20 $, secondo la nota a piè di pagina dell’annuncio. Google non fornisce la data di fine di questa offerta per Carbon.
Questi punteggi resisteranno quando Carbon lascerà la cerchia dei difensori selezionati per arrivare agli sviluppatori, in una data che Google non ha fissato?
