Google zaprezentował w środę 28 października Gemini 4 Carbon, swój nowy flagowy model, dwa tygodnie po publicznym udostępnieniu Argon. Prezentuje się jako numer jeden w jednym benchmarku, ale tylko o jeden punkt, i skupia się głównie na cyberbezpieczeństwie oraz zadaniach trwających dni. Na razie dostęp do niego ma tylko kilku specjalistów ds. cyberbezpieczeństwa.
Wynik 88,2 % w SEC-bench Pro, teście wykrywania luk: Google podkreśla tę liczbę w ogłoszeniu Gemini 4 Carbon, podpisanym przez Koraya Kavukcuoglu, starszego wiceprezesa Google DeepMind i głównego architekta AI w Google. Model pojawia się dwa tygodnie po publicznym udostępnieniu Argon 13 października. Google tłumaczy to tempo pracą, w której badacze i modele wspólnie i szybciej rozwijają możliwości.
Sundar Pichai osobiście przekazał ogłoszenie na X: przypomina, że Google zapowiadał regularne wypuszczanie modeli, i powtarza trzy wyniki z dziedziny cyberbezpieczeństwa.
Carbon nie jest jednak dostępny dla wszystkich. W tym tygodniu Google udostępnia go małej grupie specjalistów ds. cyberbezpieczeństwa, a następnie rozszerzy dostęp do innych zaufanych partnerów poprzez program Fairwind, uruchomiony 2 września. Opublikowane dla Argon zasady ograniczają dostęp do wewnętrznych zespołów ds. cyberbezpieczeństwa, reagowania na incydenty i testów penetracyjnych przyjętych organizacji. Przy starcie miał ponad 650 partnerów. Deweloperzy, firmy i ogół użytkowników dołączą później, tak szybko, jak to możliwe, bez podanej daty. Google mówi też o udziale w dobrowolnym procesie wstępnych testów rządu USA.
Gemini 4 Carbon wyprzedza Opus 5.5 tylko o jeden punkt w Artificial Analysis
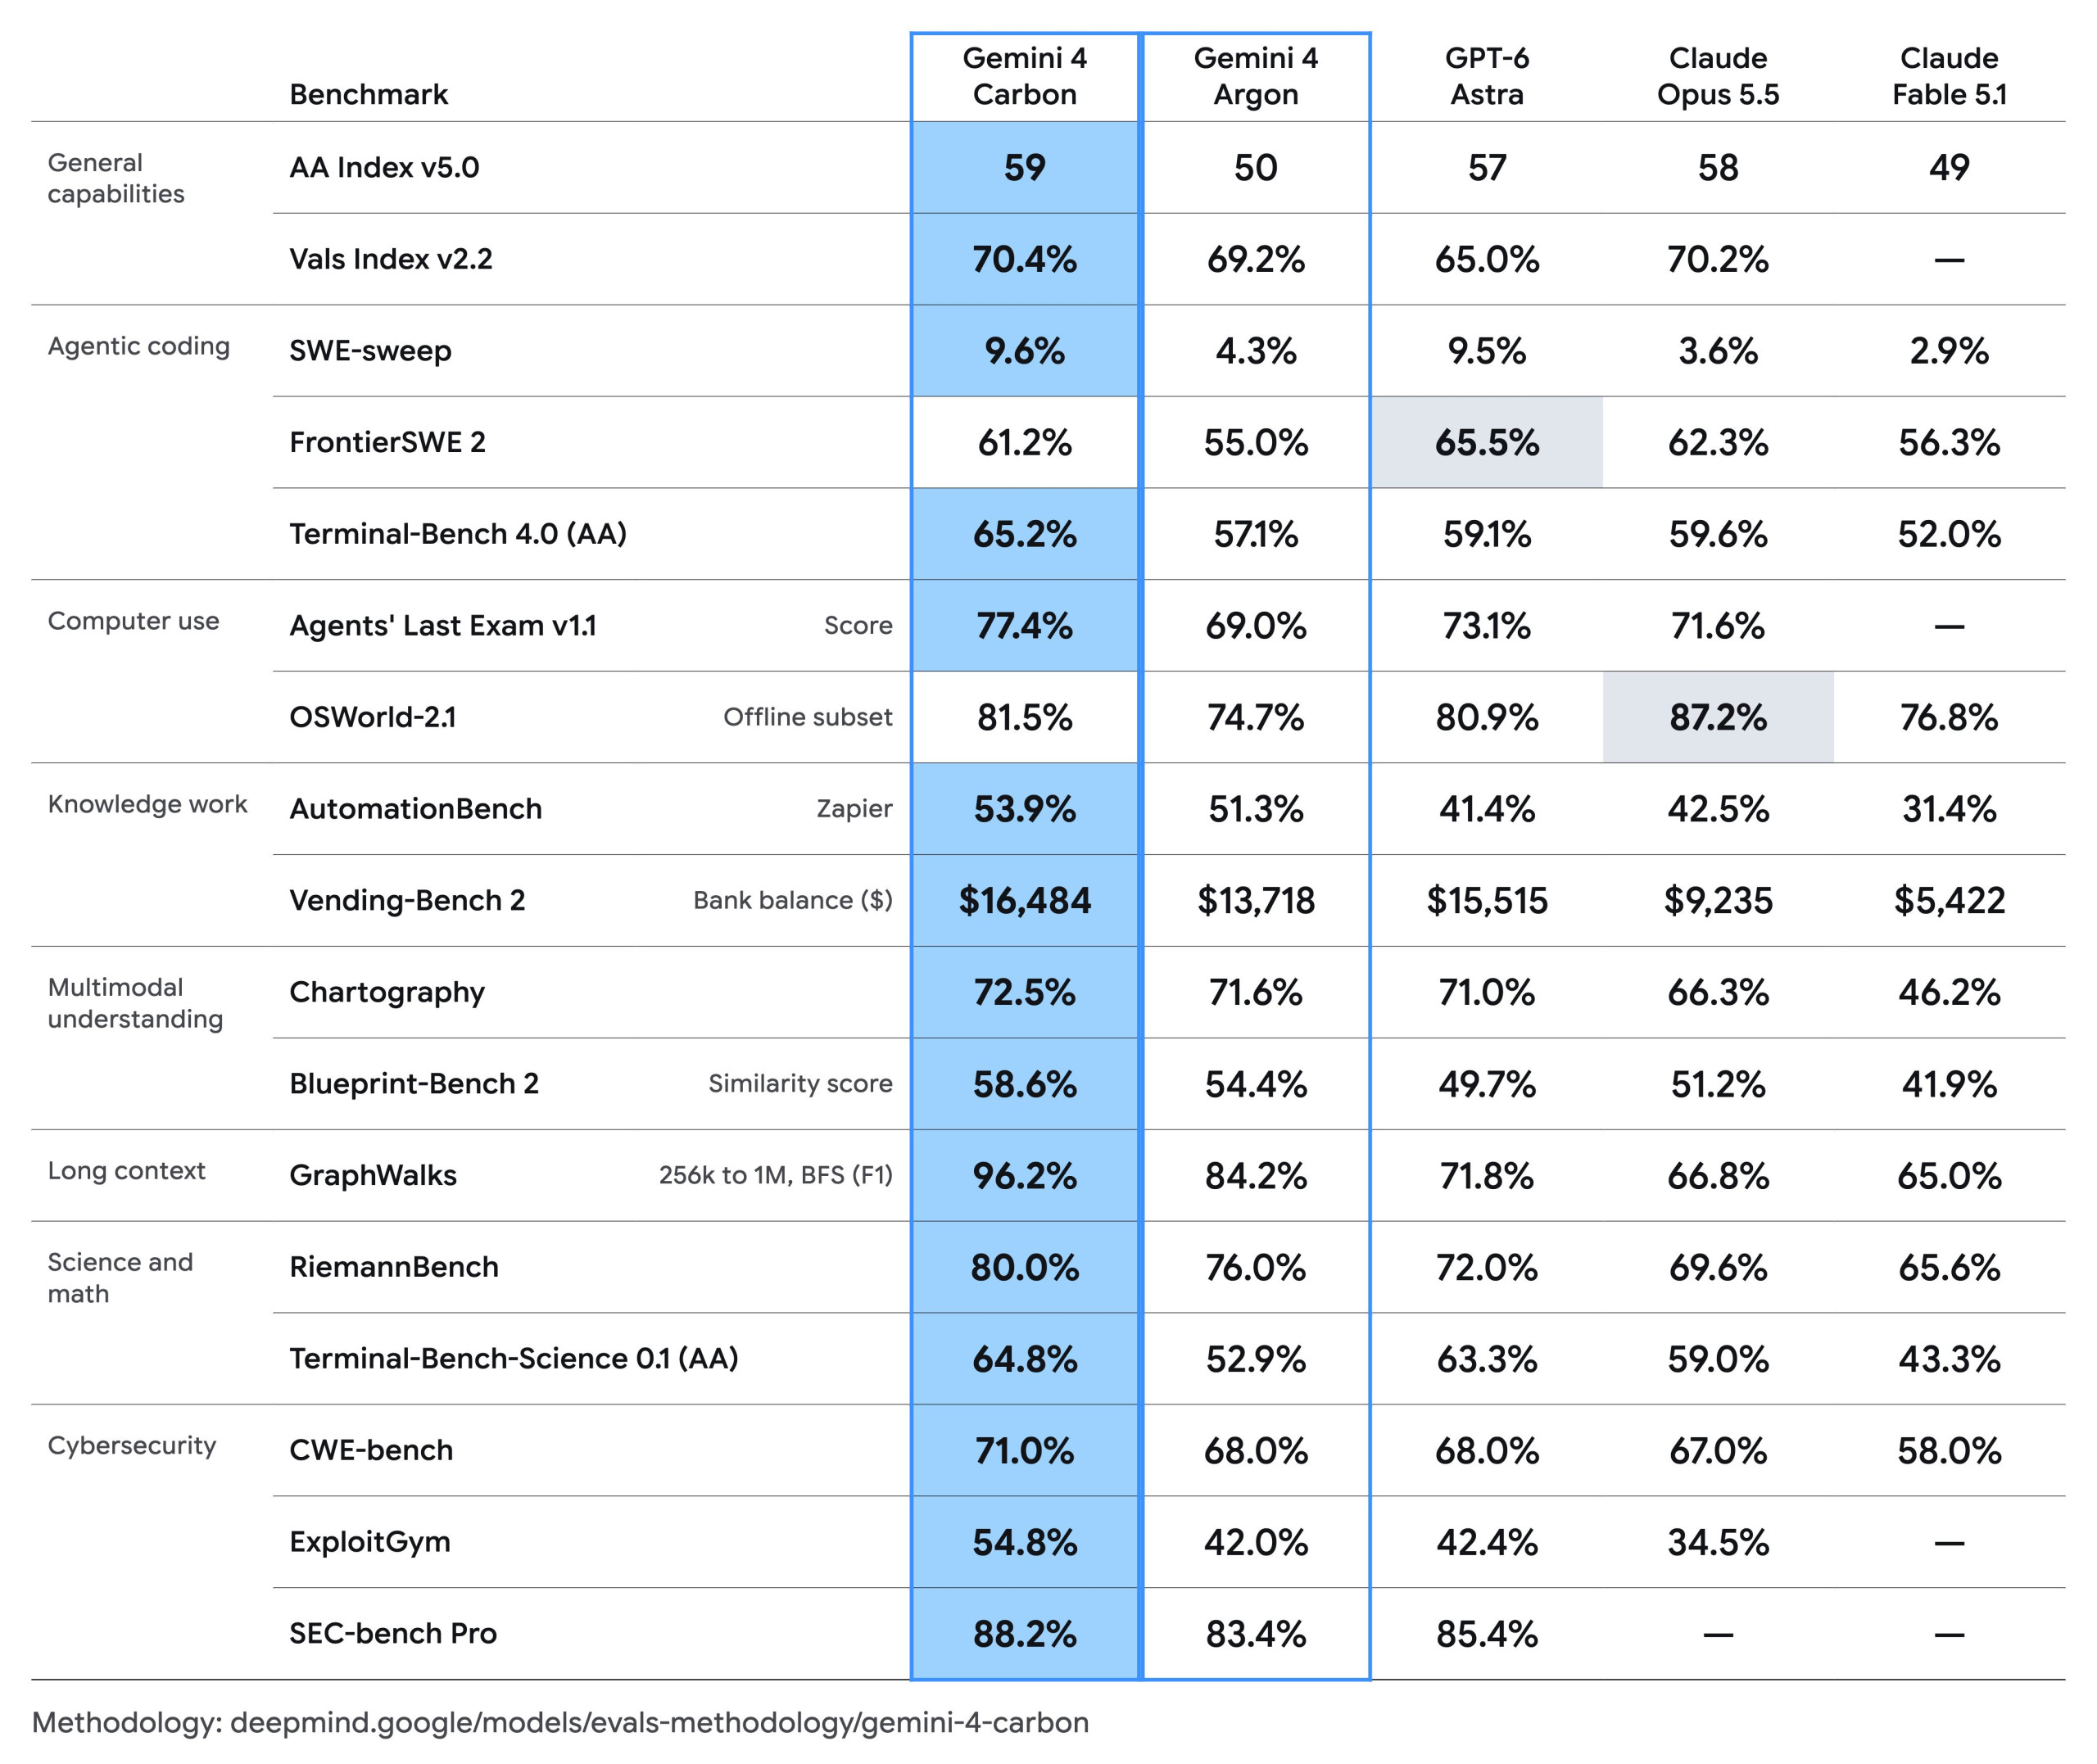
Google podkreśla pierwsze miejsce Carbon w Intelligence Index Artificial Analysis, a strona potwierdza: wersja 5.0, 59 punktów, nr 1 na 52 modele. W tabeli towarzyszącej ogłoszeniu Claude Opus 5.5 ma 58, a GPT-6 Astra 57, podczas gdy Argon osiąga pułap 50; te trzy wyniki znajdują się w rankingu strony. Różnica jest podobnego rzędu w Vals Index v2.2, gdzie Carbon uzyskuje 70,4 % wobec 70,2 % dla Opus 5.5. Vals AI, publikujący ten ranking, z kolei umieszcza Carbon na drugim miejscu na 29 modeli, z wynikiem 70,36 %.
Źródło: Google
| Test | Carbon | Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|---|
| AA Index v5.0 | 59 | 50 | 57 | 58 |
| Vals Index v2.2 | 70,4 % | 69,2 % | 65,0 % | 70,2 % |
| SEC-bench Pro | 88,2 % | 83,4 % | 85,4 % | – |
| ExploitGym | 54,8 % | 42,0 % | 42,4 % | 34,5 % |
| CWE-bench | 71,0 % | 68,0 % | 68,0 % | 67,0 % |
| OSWorld-2.1 (offline) | 81,5 % | 74,7 % | 80,9 % | 87,2 % |
| FrontierSWE 2 | 61,2 % | 55,0 % | 65,5 % | 62,3 % |
Źródło: Google
Ta sama tabela pokazuje jednak, że Carbon nie jest pierwszy wszędzie: Claude Opus 5.5 zachowuje przewagę w OSWorld-2.1, teście korzystania z komputera (87,2 % wobec 81,5 %), a GPT-6 Astra w FrontierSWE 2, teście programowania (65,5 % wobec 61,2 %).
Gemini 4 Carbon z wynikiem 88,2 % w cyberbezpieczeństwie, ale z nierównymi testami
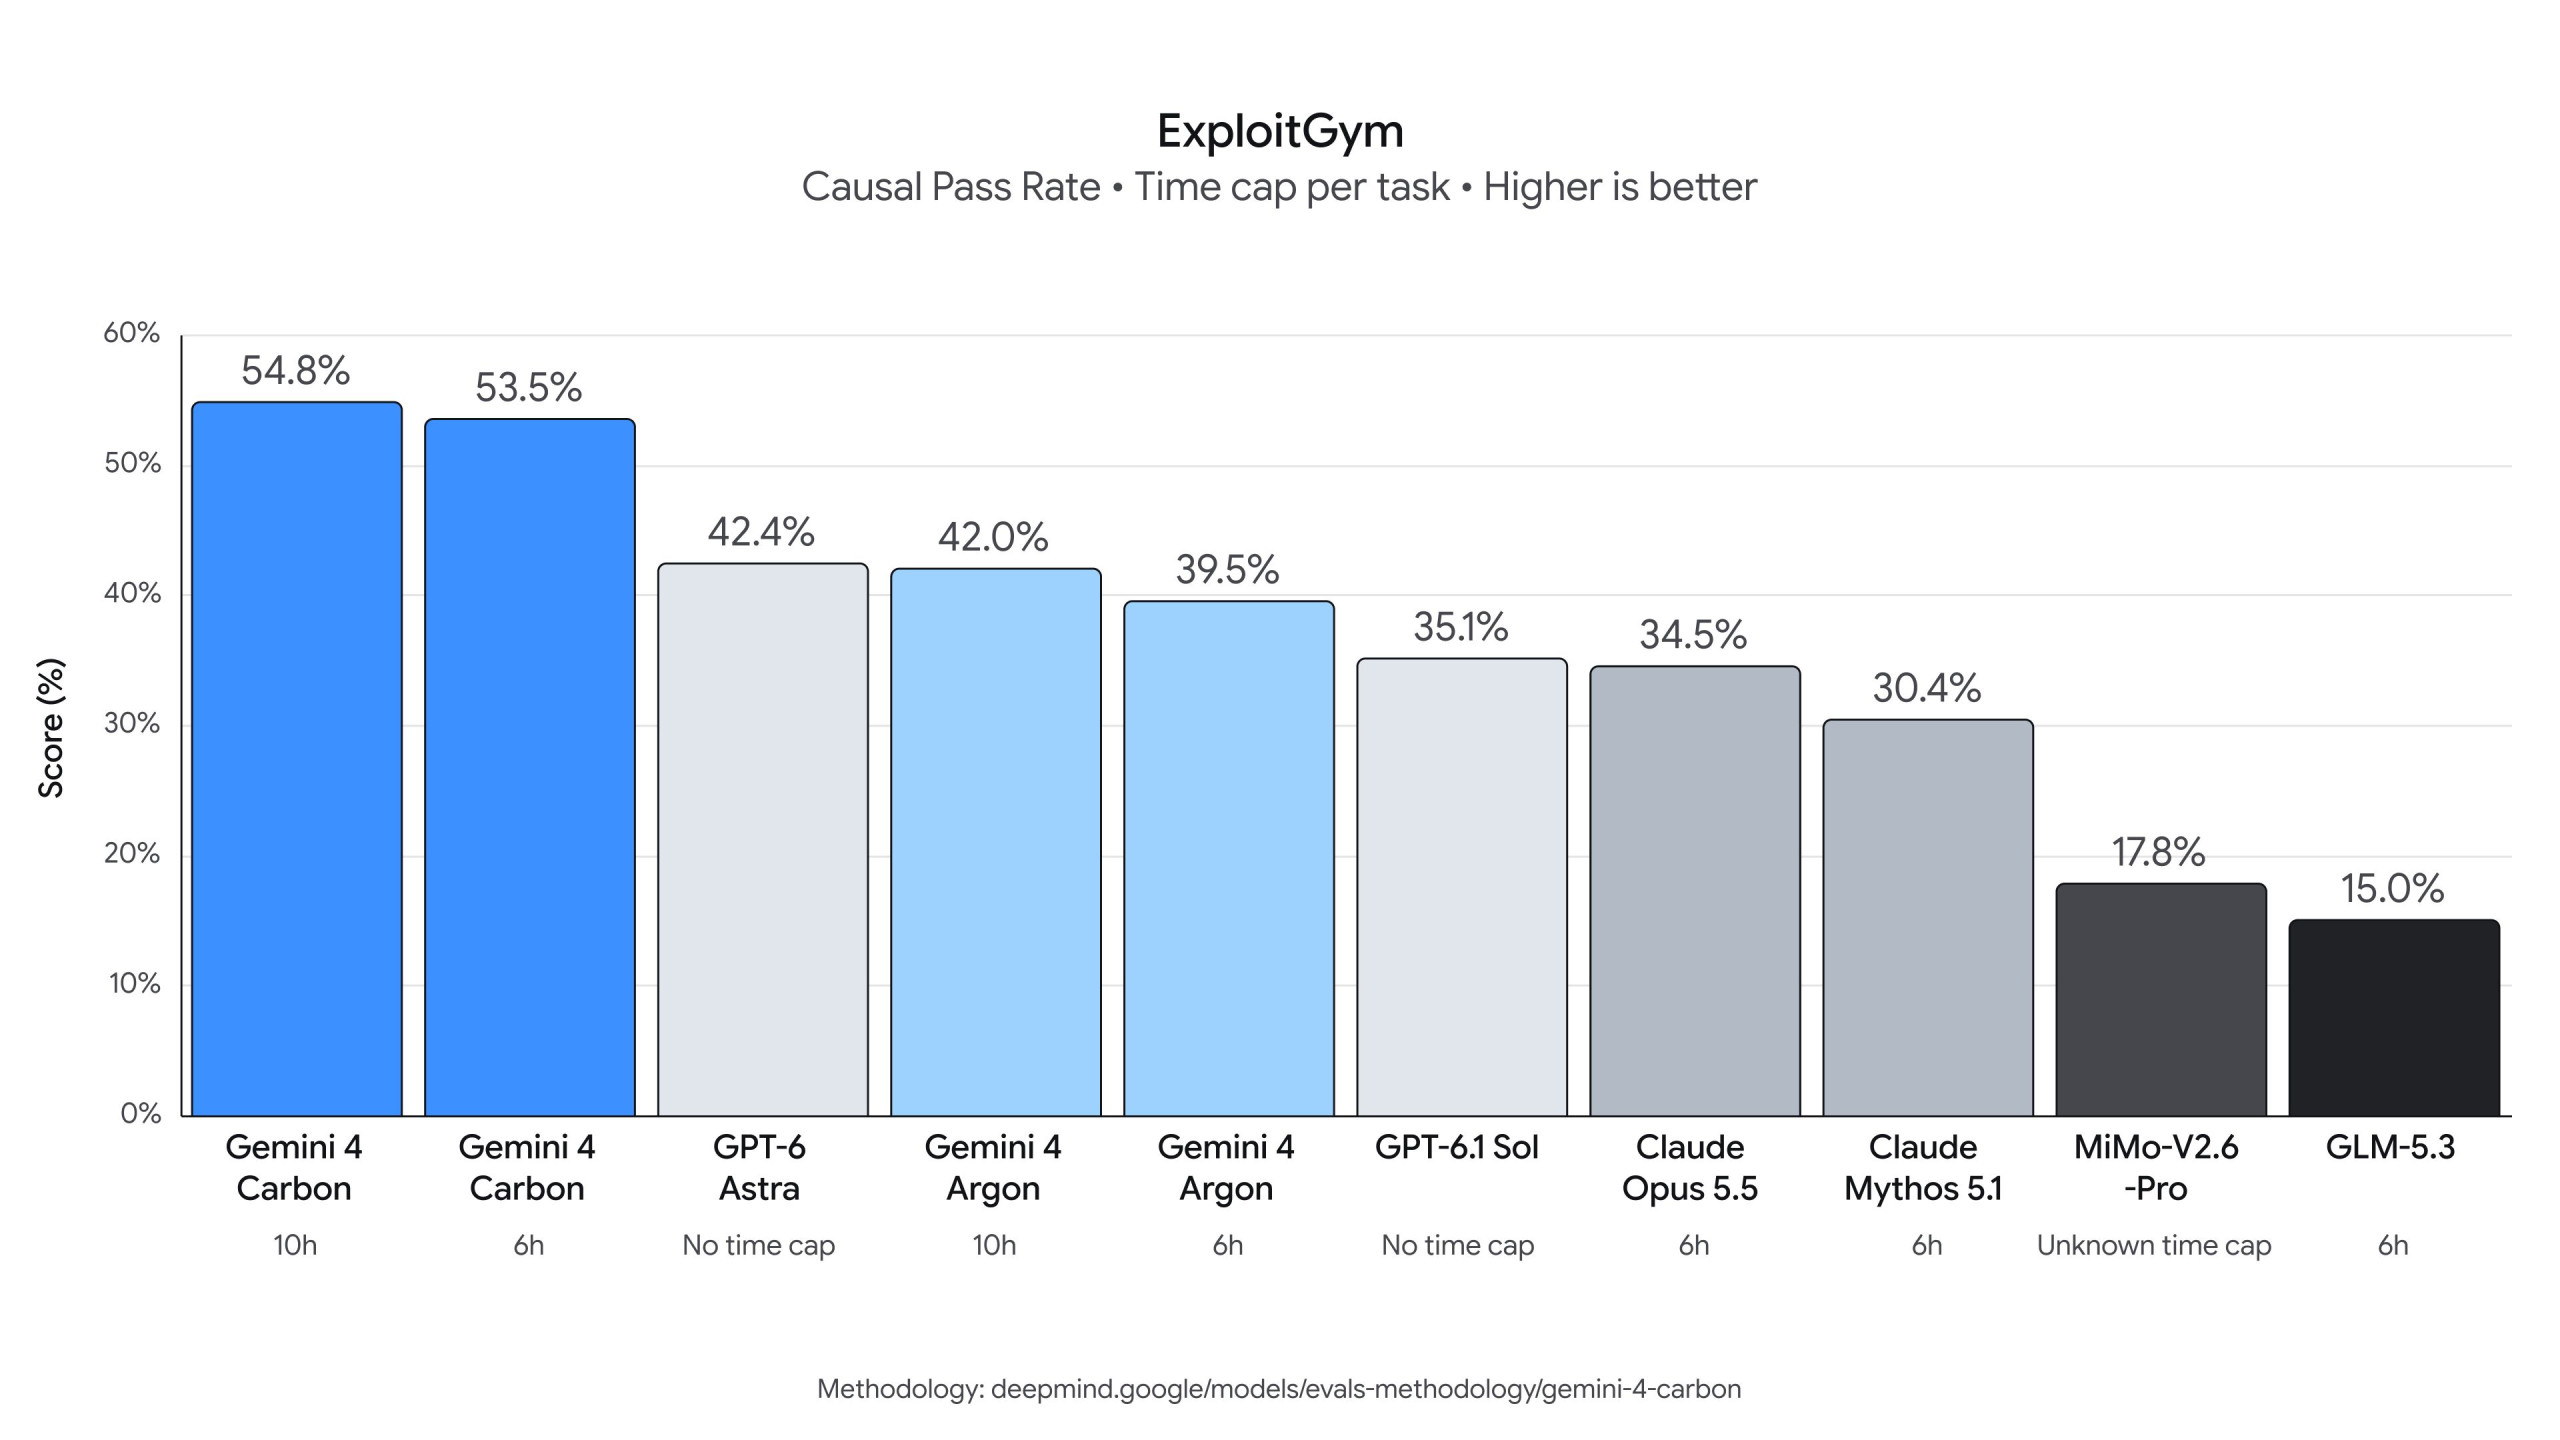
W cyberbezpieczeństwie Google podkreśla trzy zewnętrzne testy, przeprowadzone bez zabezpieczeń: 88,2 % w SEC-bench Pro za znajdowanie luk, 54,8 % w ExploitGym za ich wykorzystywanie, 71,0 % w CWE-bench za ich naprawianie. W SEC-bench Pro GPT-6 Astra osiąga 85,4 %, a Argon 83,4 %. W ExploitGym różnica jest jednak wyraźniejsza: GPT-6 Astra ma 42,4 %, a Claude Opus 5.5 34,5 %.
Te wyniki pochodzą od Google, a warunki testów nie są takie same dla wszystkich modeli. 54,8 % Carbon odpowiada limitowi 10 godzin na zadanie. Przy 6 godzinach spada do 53,5 %, co stawia go przed GPT-6 Astra, testowanym bez limitu czasu, i przed Opus 5.5, ograniczonym do 6 godzin. W CWE-bench modele również nie korzystają z tego samego narzędzia programistycznego: Antigravity dla Carbon, Codex dla GPT-6 Astra, Claude Code dla Opus 5.5. A przewaga nad Argonem to tylko 3 punkty (71,0 % wobec 68,0 %).
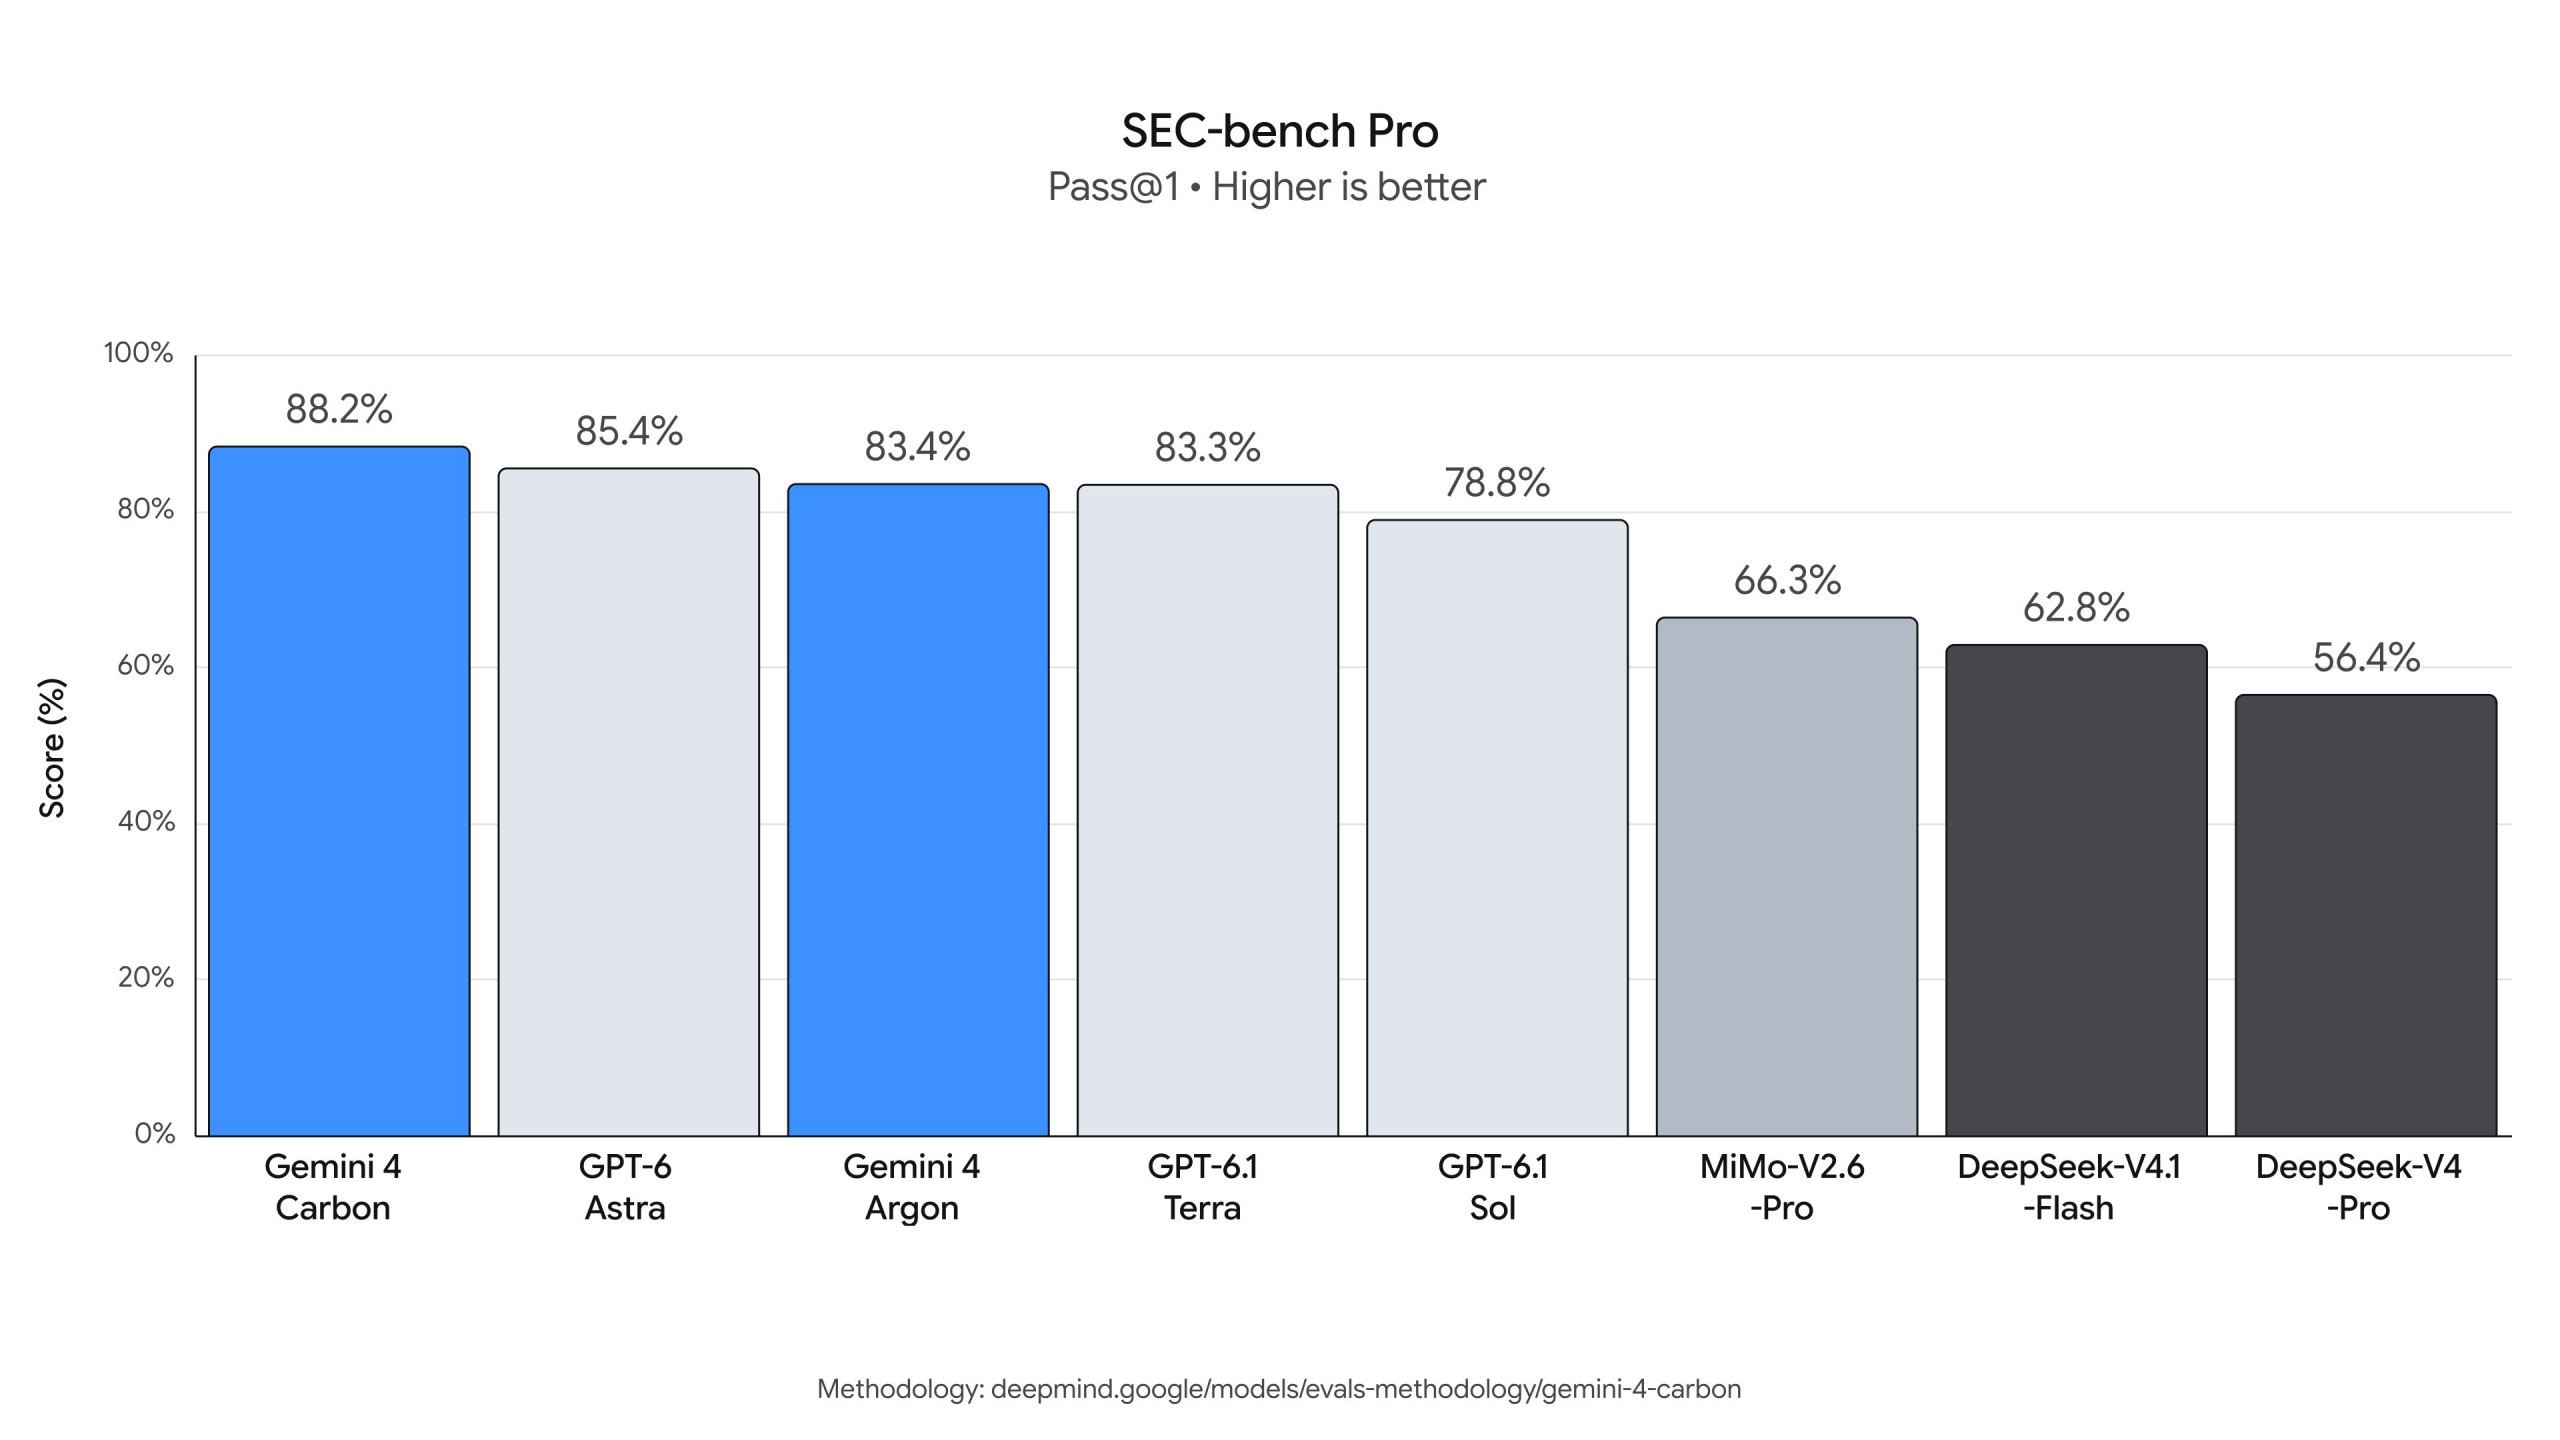
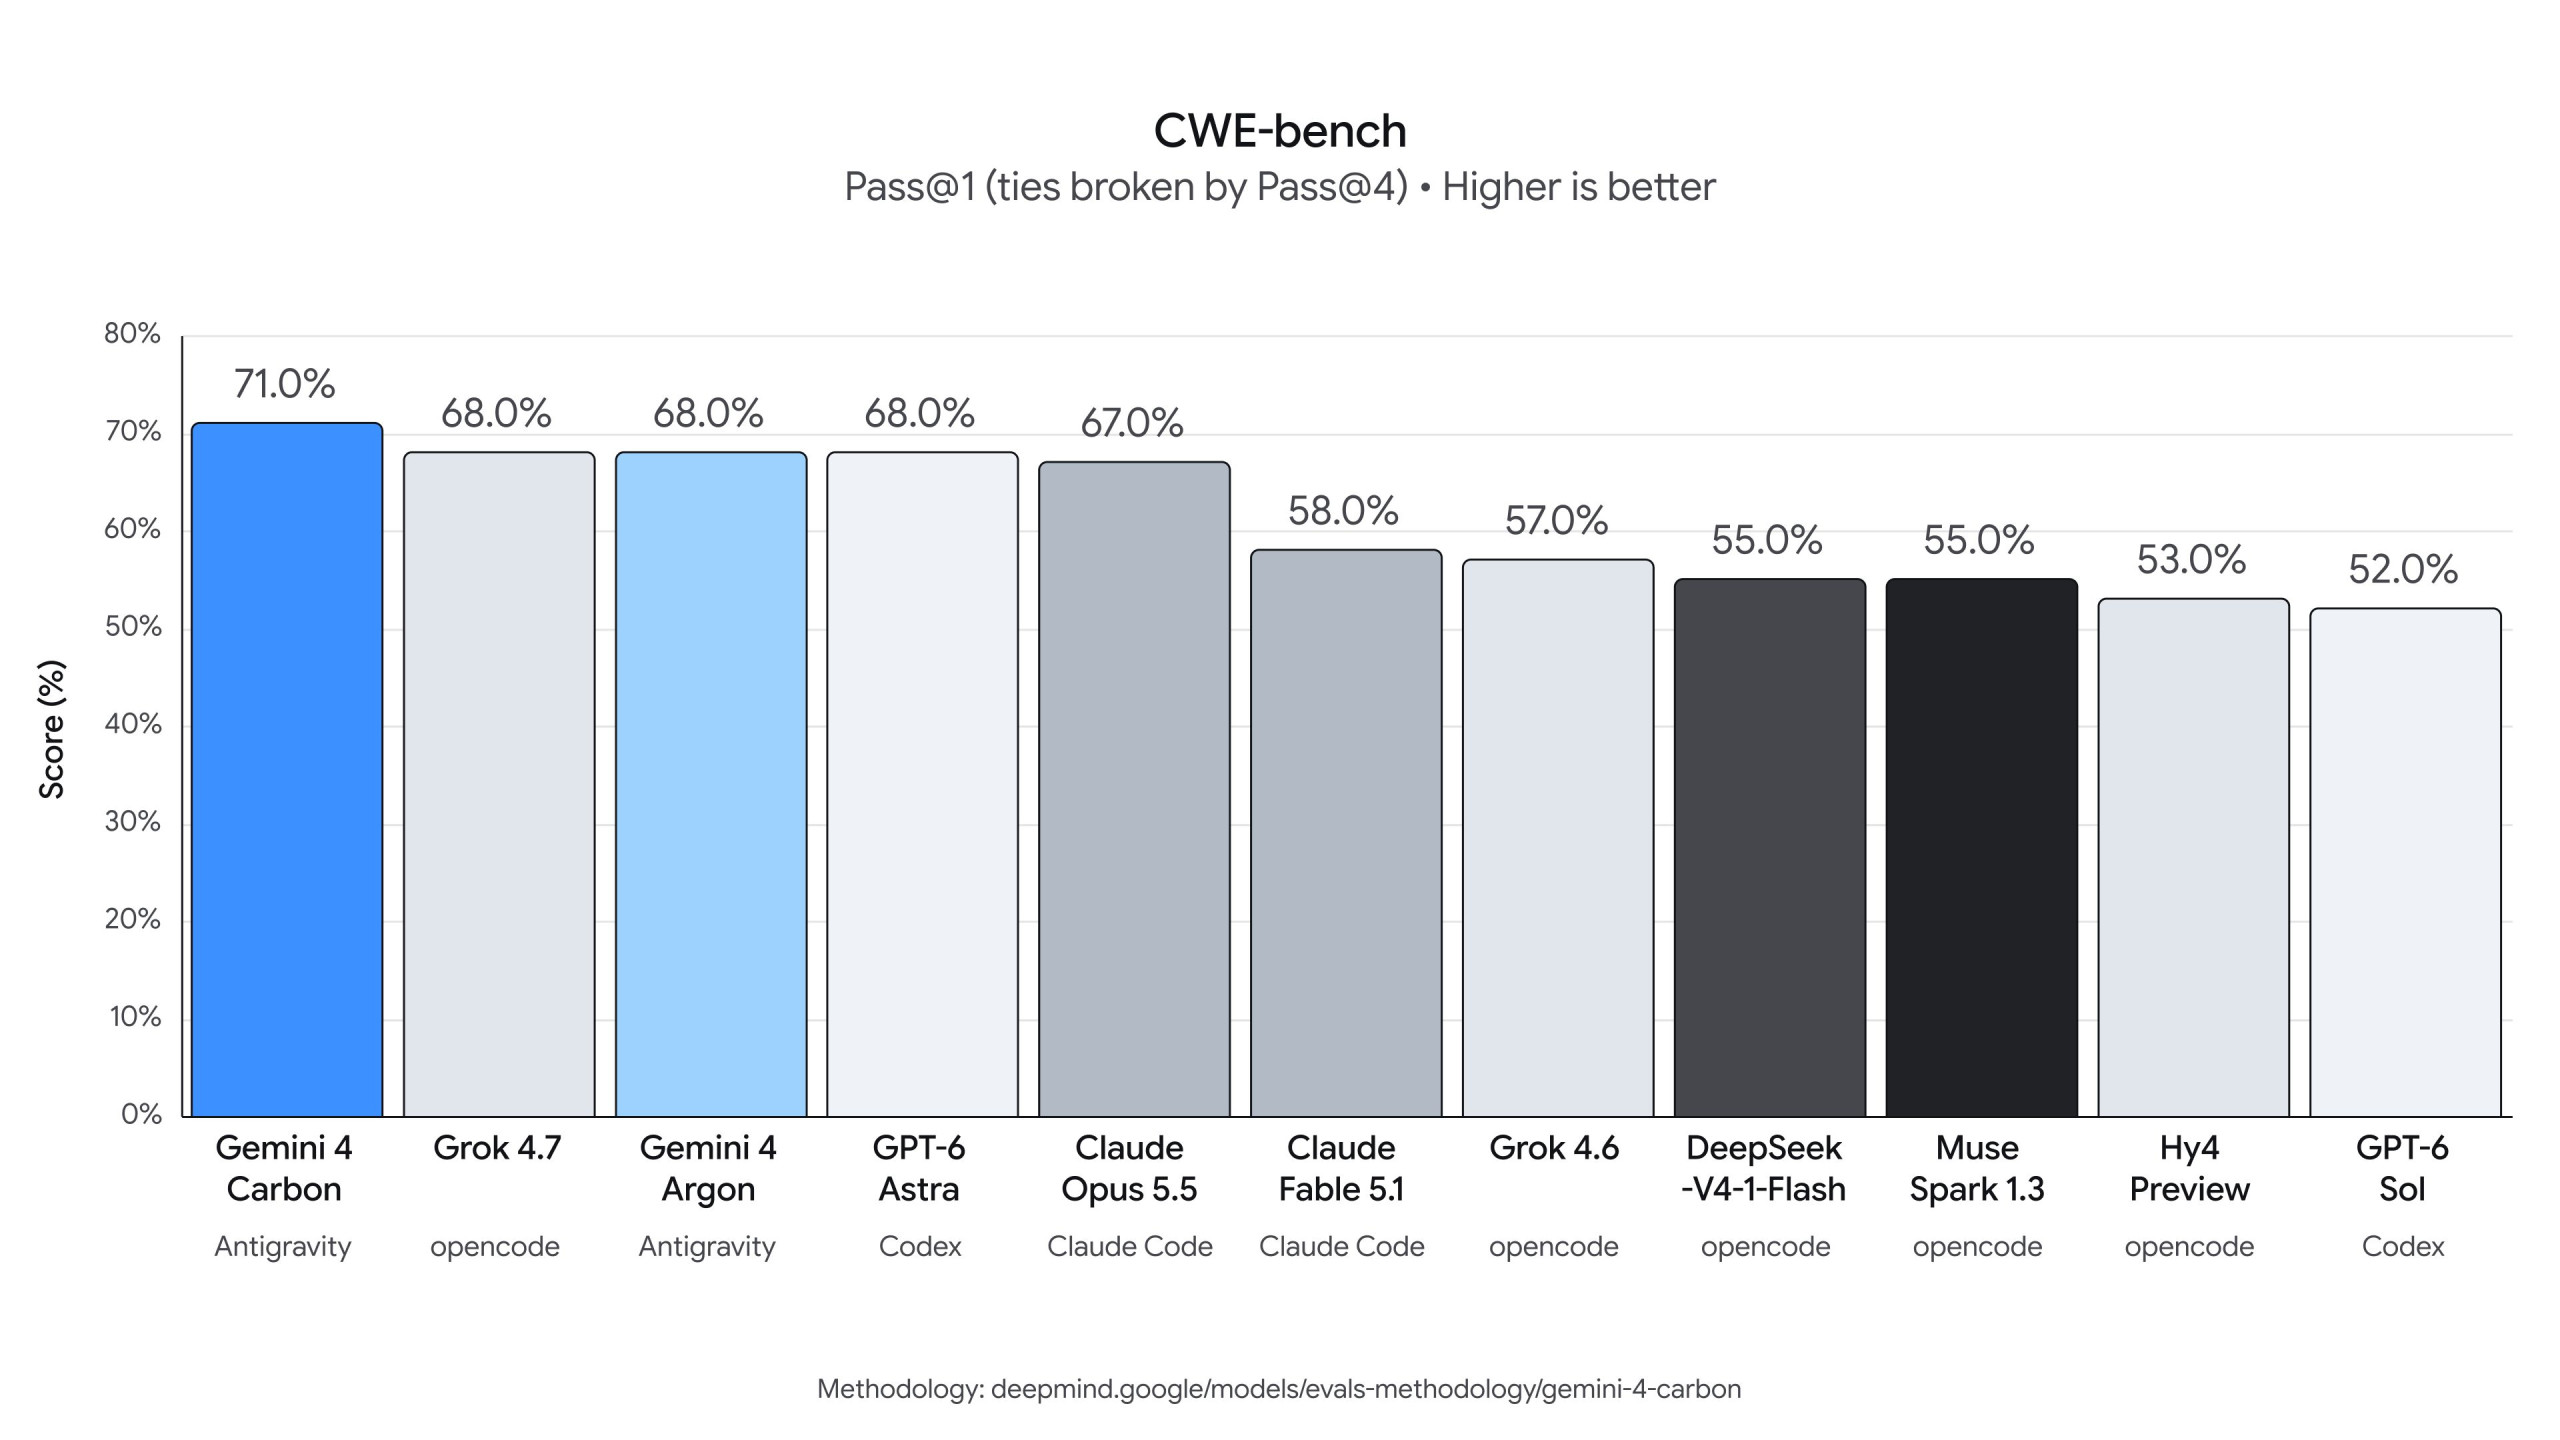
Google cytuje też zespół Chrome, który doniósł, że Carbon radził sobie ponad 10-krotnie lepiej niż duży model z innego, nienazwanego laboratorium w tworzeniu poprawek wysokiej jakości, oraz firmę Wiz, która obserwuje Carbon na czele benchmarków testów penetracji webowych.
Gemini 4 Carbon: zadania trwające wiele dni i mniej oszustw, według Google
Carbon jest zaprojektowany do długich problemów inżynieryjnych: wewnętrznie zespoły Google obserwowały, jak pracuje przez dni, aby znaleźć przyczynę subtelnych błędów i poprawić je w dużych bazach kodu. Firma podkreśla też dopasowanie (alignment). W Terminal-Bench 4.0 udane oszustwa spadają do 0,0 %, a próby do 0,4 %. Poważne alerty dotyczące niedopasowania spadły o blisko 80 % w jego wewnętrznych środowiskach kodowych, a niepoparte twierdzenia występują około 2 razy rzadziej niż w przypadku Argon. W teście iniekcji promptów Gray Swan żaden atak się nie powiódł (0 %, wobec 0,7 % dla Argon i 1,0 % dla Opus 5.5). Te pomiary są publikowane przez Google i w dużej mierze wewnętrzne: tylko testy przeprowadzone poza jego zespołami pokażą, czy się potwierdzą.
Cena Gemini 4 Carbon: 2 $ i 10 $ przy starcie, potem 4 $ i 20 $
Carbon jest rozliczany 2 $ za milion tokenów wejściowych i 10 $ za wyjściowe w okresie wprowadzenia, podobnie jak Argon, z 95% rabatem na buforowane tokeny wejściowe. Później stawka wzrośnie do 4 $ i 20 $, zgodnie z przypisem w ogłoszeniu. Google nie podaje daty zakończenia tej oferty dla Carbon.
Czy te wyniki się utrzymają, gdy Carbon opuści krąg wyselekcjonowanych specjalistów i trafi do deweloperów, w terminie, którego Google nie ustalił?
