Google stellte am Mittwoch, den 28. Oktober, Gemini 4 Carbon vor, sein neues Flaggschiffmodell, zwei Wochen nach der öffentlichen Freigabe von Argon. Es präsentiert sich als Nummer eins in einem Benchmark, aber nur mit einem Punkt Vorsprung, und zielt vor allem auf Cybersicherheit und Aufgaben ab, die Tage dauern. Derzeit haben nur einige Cybersicherheitsexperten Zugang.
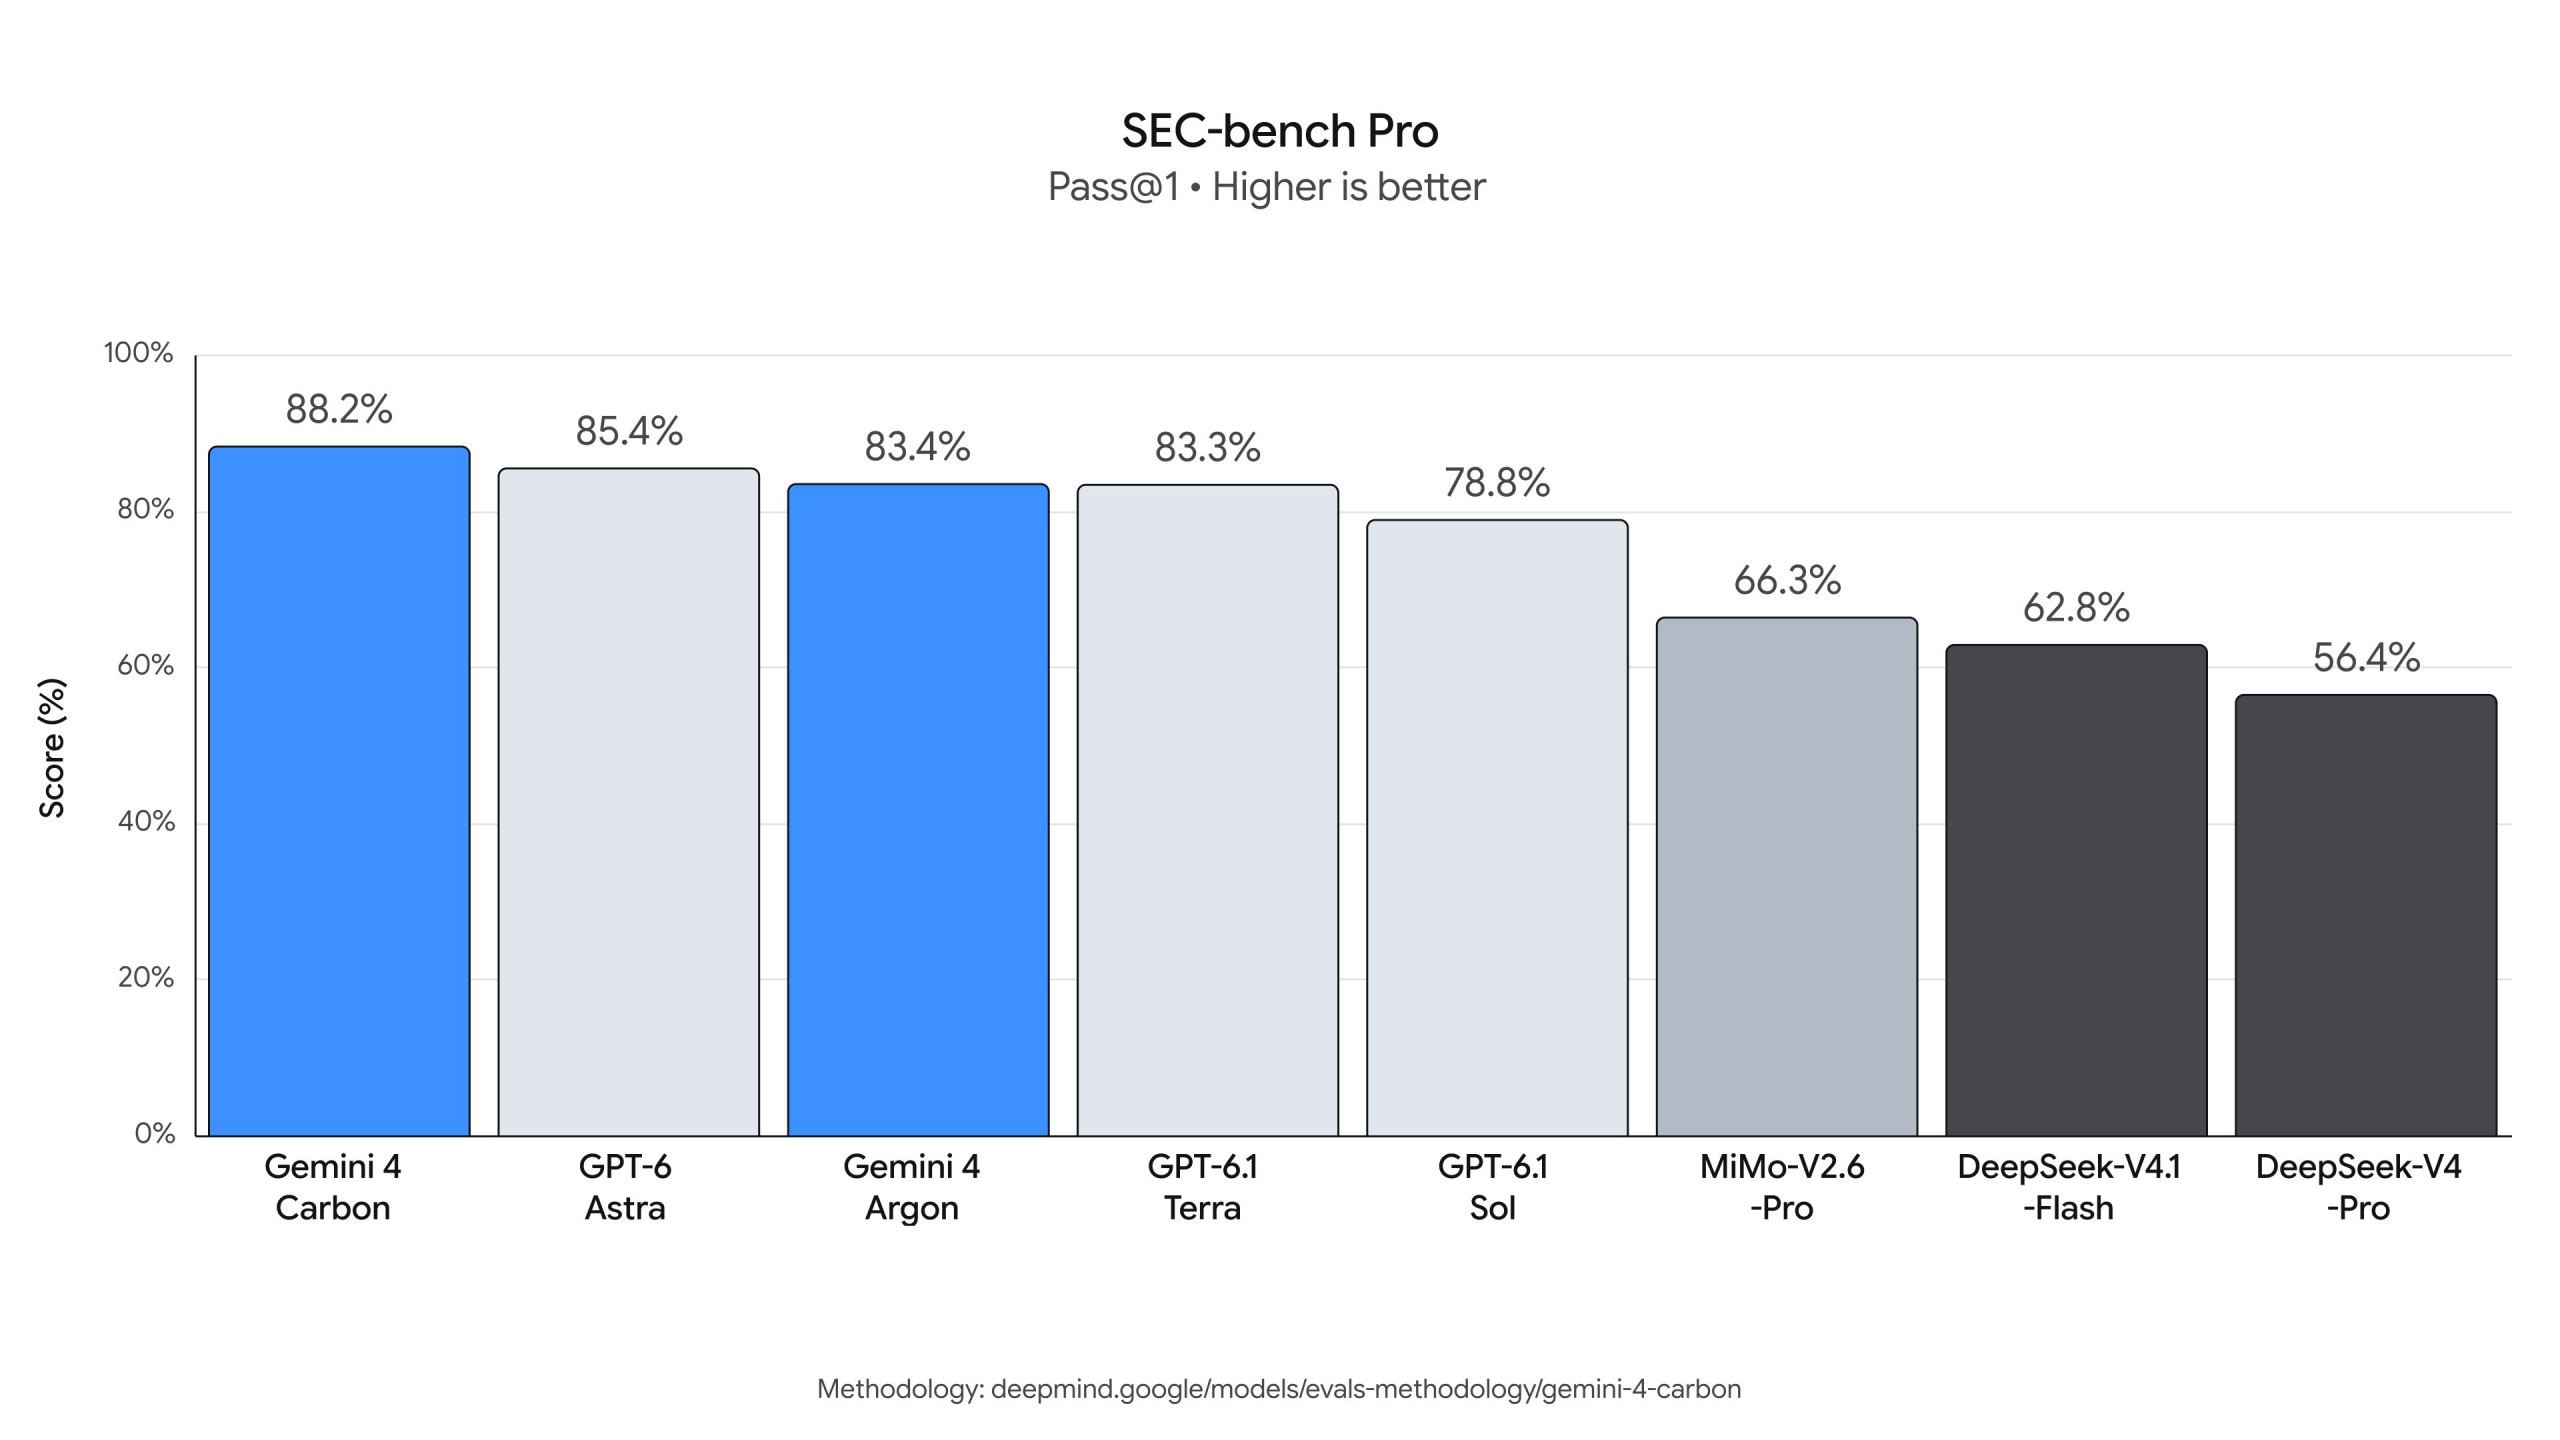
Eine Punktzahl von 88,2 % bei SEC-bench Pro, einem Test zur Erkennung von Sicherheitslücken: Google stellt diese Zahl in der Ankündigung von Gemini 4 Carbon in den Vordergrund, unterzeichnet von Koray Kavukcuoglu, Senior Vice President von Google DeepMind und Chief AI Architect bei Google. Das Modell kommt zwei Wochen nach der öffentlichen Freigabe von Argon am 13. Oktober. Google erklärt dieses Tempo mit einer Arbeitsweise, bei der Forscher und Modelle die Fähigkeiten gemeinsam und schneller vorantreiben.
Sundar Pichai selbst verbreitete die Ankündigung auf X: Er erinnert daran, dass Google angekündigt hatte, seine Modelle in regelmäßigen Abständen zu veröffentlichen, und wiederholt die drei Cybersicherheits-Ergebnisse.
Carbon ist jedoch nicht für alle zugänglich. Diese Woche stellt Google es einer kleinen Gruppe von Cybersicherheitsexperten zur Verfügung und wird den Zugang dann über das Programm Fairwind, das am 2. September gestartet wurde, auf weitere vertrauenswürdige Partner ausweiten. Die für Argon veröffentlichten Regeln beschränken den Zugang auf interne Cybersicherheits-, Incident-Response- und Penetration-Testing-Teams der zugelassenen Organisationen. Bei Start zählte es über 650 Partner. Entwickler, Unternehmen und die breite Öffentlichkeit folgen später, sobald wie möglich, ohne bekanntes Datum. Google gibt zudem an, am freiwilligen Vorab-Testverfahren der US-Regierung teilzunehmen.
Gemini 4 Carbon übertrifft Opus 5.5 auf Artificial Analysis nur um einen Punkt
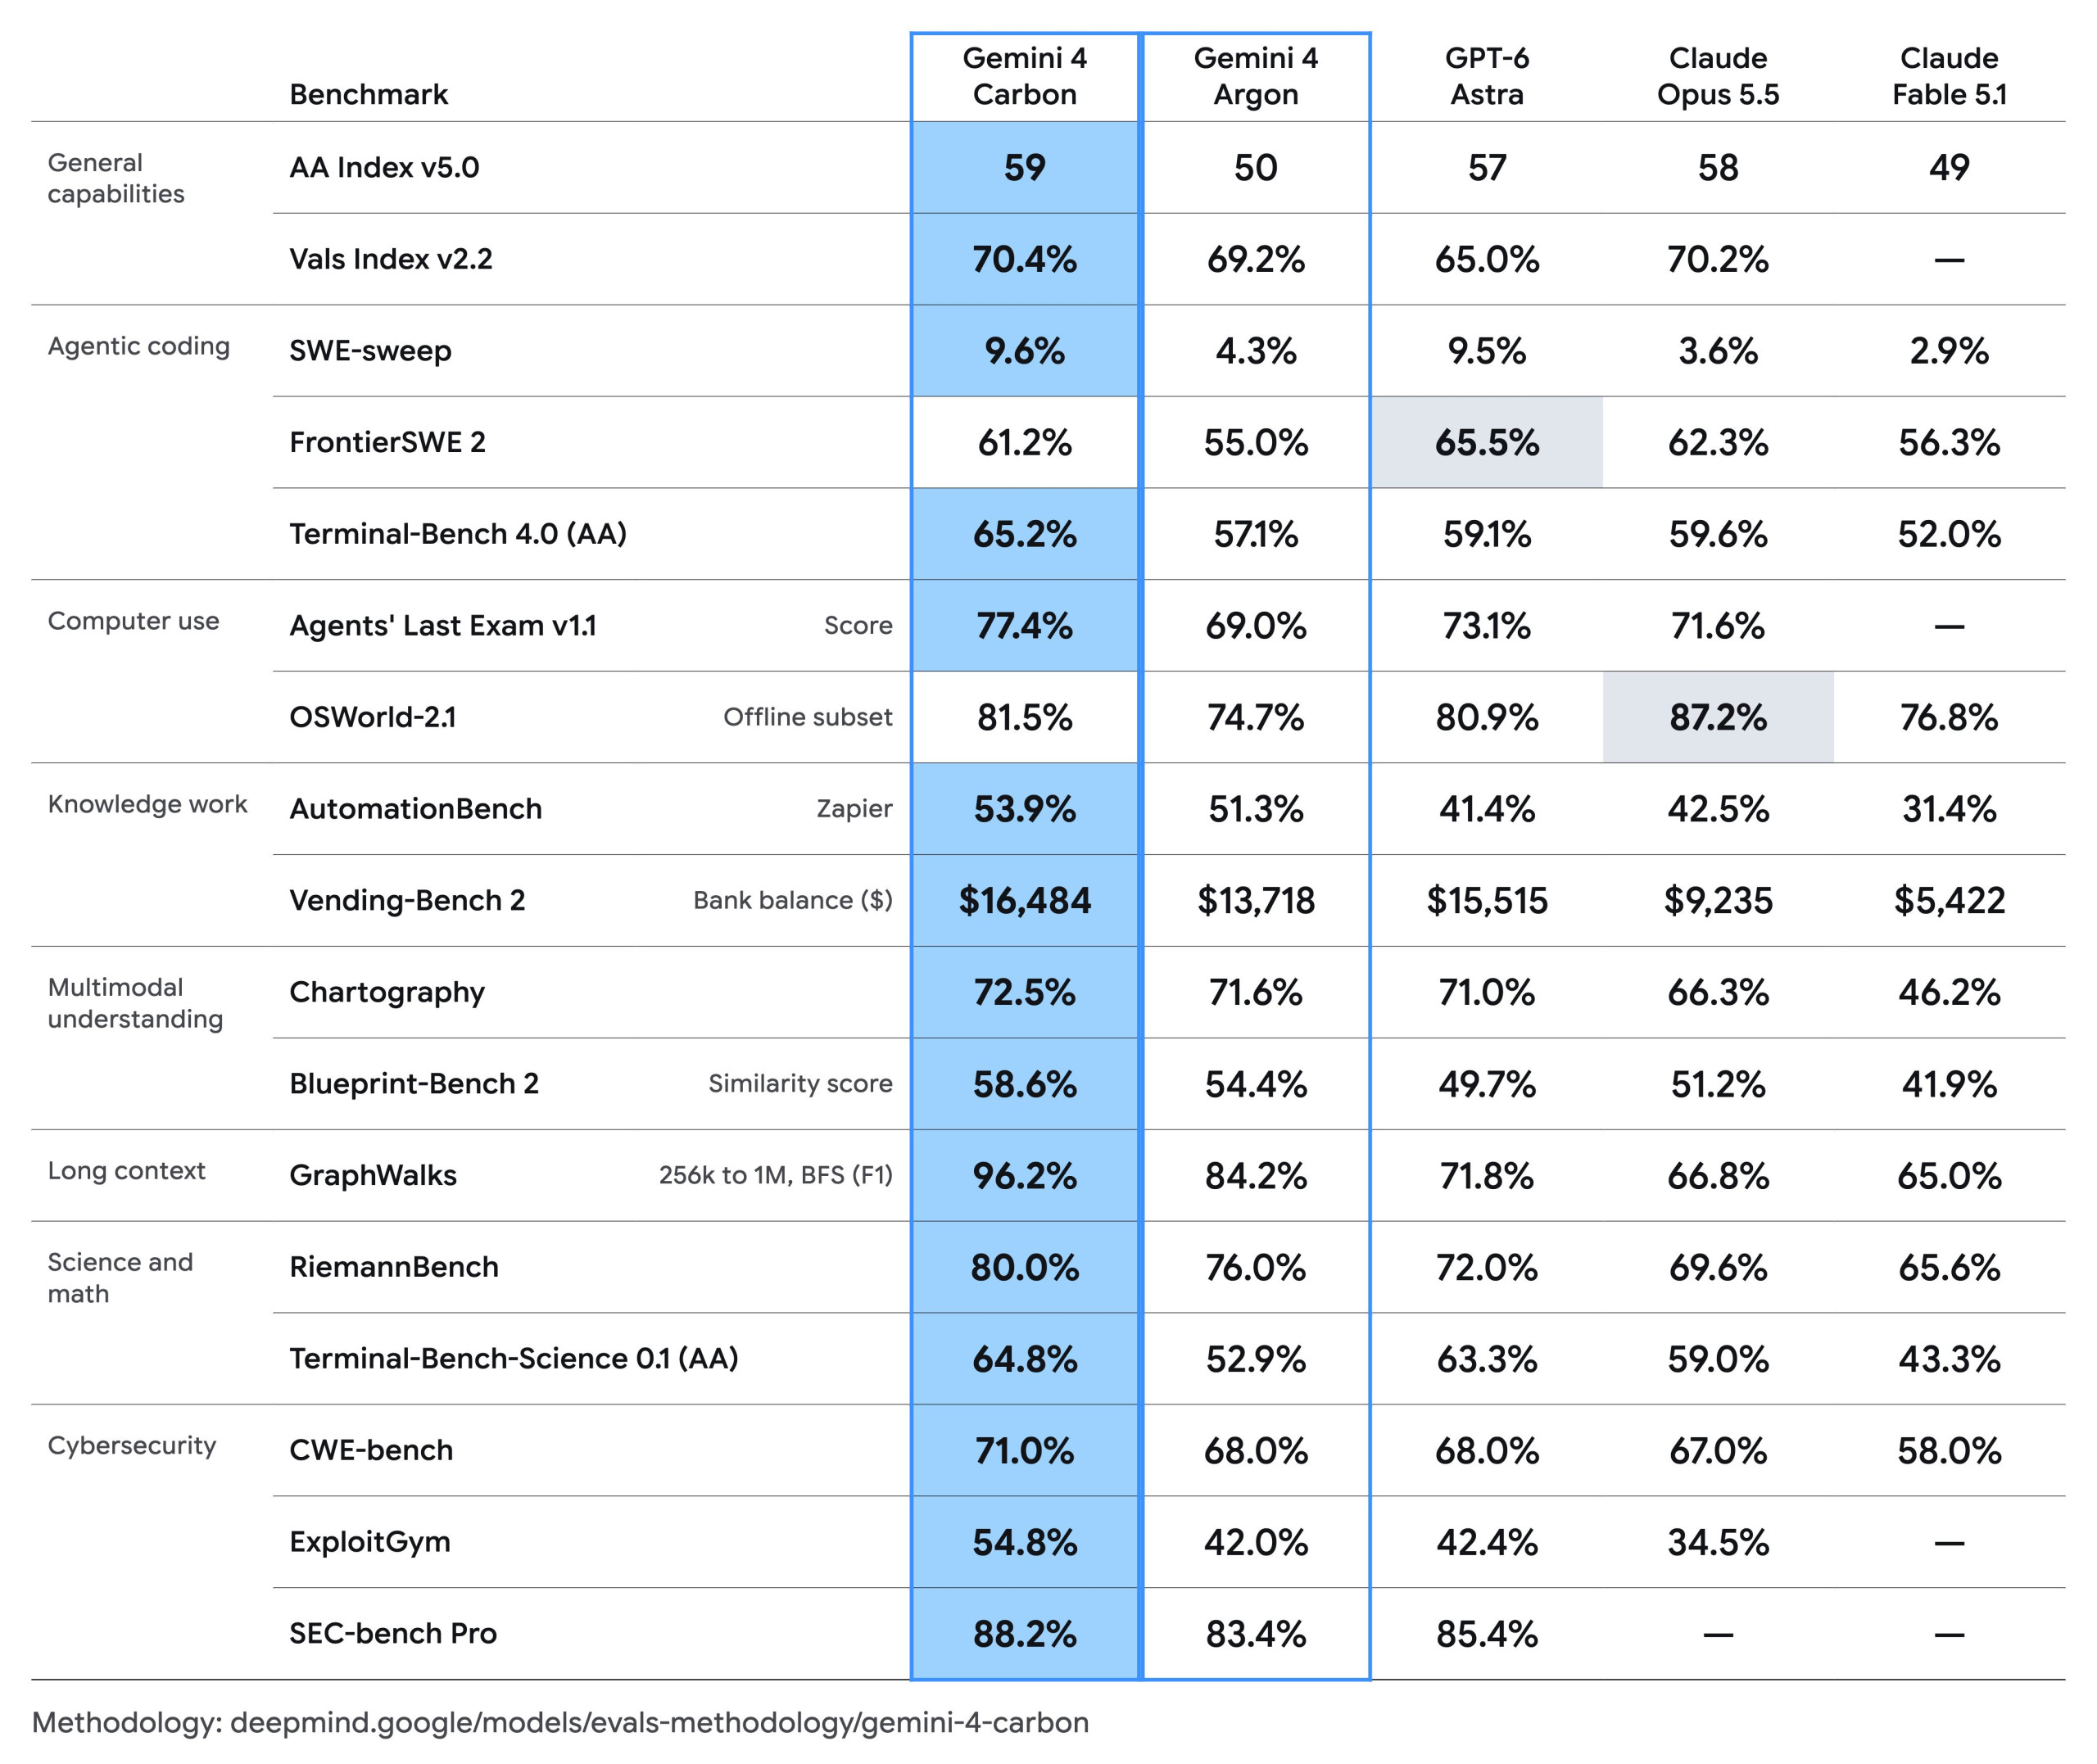
Google hebt den ersten Platz von Carbon auf dem Intelligence Index von Artificial Analysis hervor, und die Seite der Website bestätigt dies: Version 5.0, 59 Punkte, Platz 1 von 52 Modellen. In der Tabelle zur Ankündigung steht Claude Opus 5.5 bei 58 und GPT-6 Astra bei 57, während Argon bei 50 stagniert; diese drei Ergebnisse finden sich im Ranking der Website wieder. Der Abstand ist ähnlich beim Vals Index v2.2, wo Carbon 70,4 % gegenüber 70,2 % für Opus 5.5 erzielt. Vals AI, das dieses Ranking veröffentlicht, führt Carbon seinerseits auf Platz 2 von 29 Modellen mit 70,36 %.
Quelle: Google
| Test | Carbon | Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|---|
| AA Index v5.0 | 59 | 50 | 57 | 58 |
| Vals Index v2.2 | 70,4 % | 69,2 % | 65,0 % | 70,2 % |
| SEC-bench Pro | 88,2 % | 83,4 % | 85,4 % | – |
| ExploitGym | 54,8 % | 42,0 % | 42,4 % | 34,5 % |
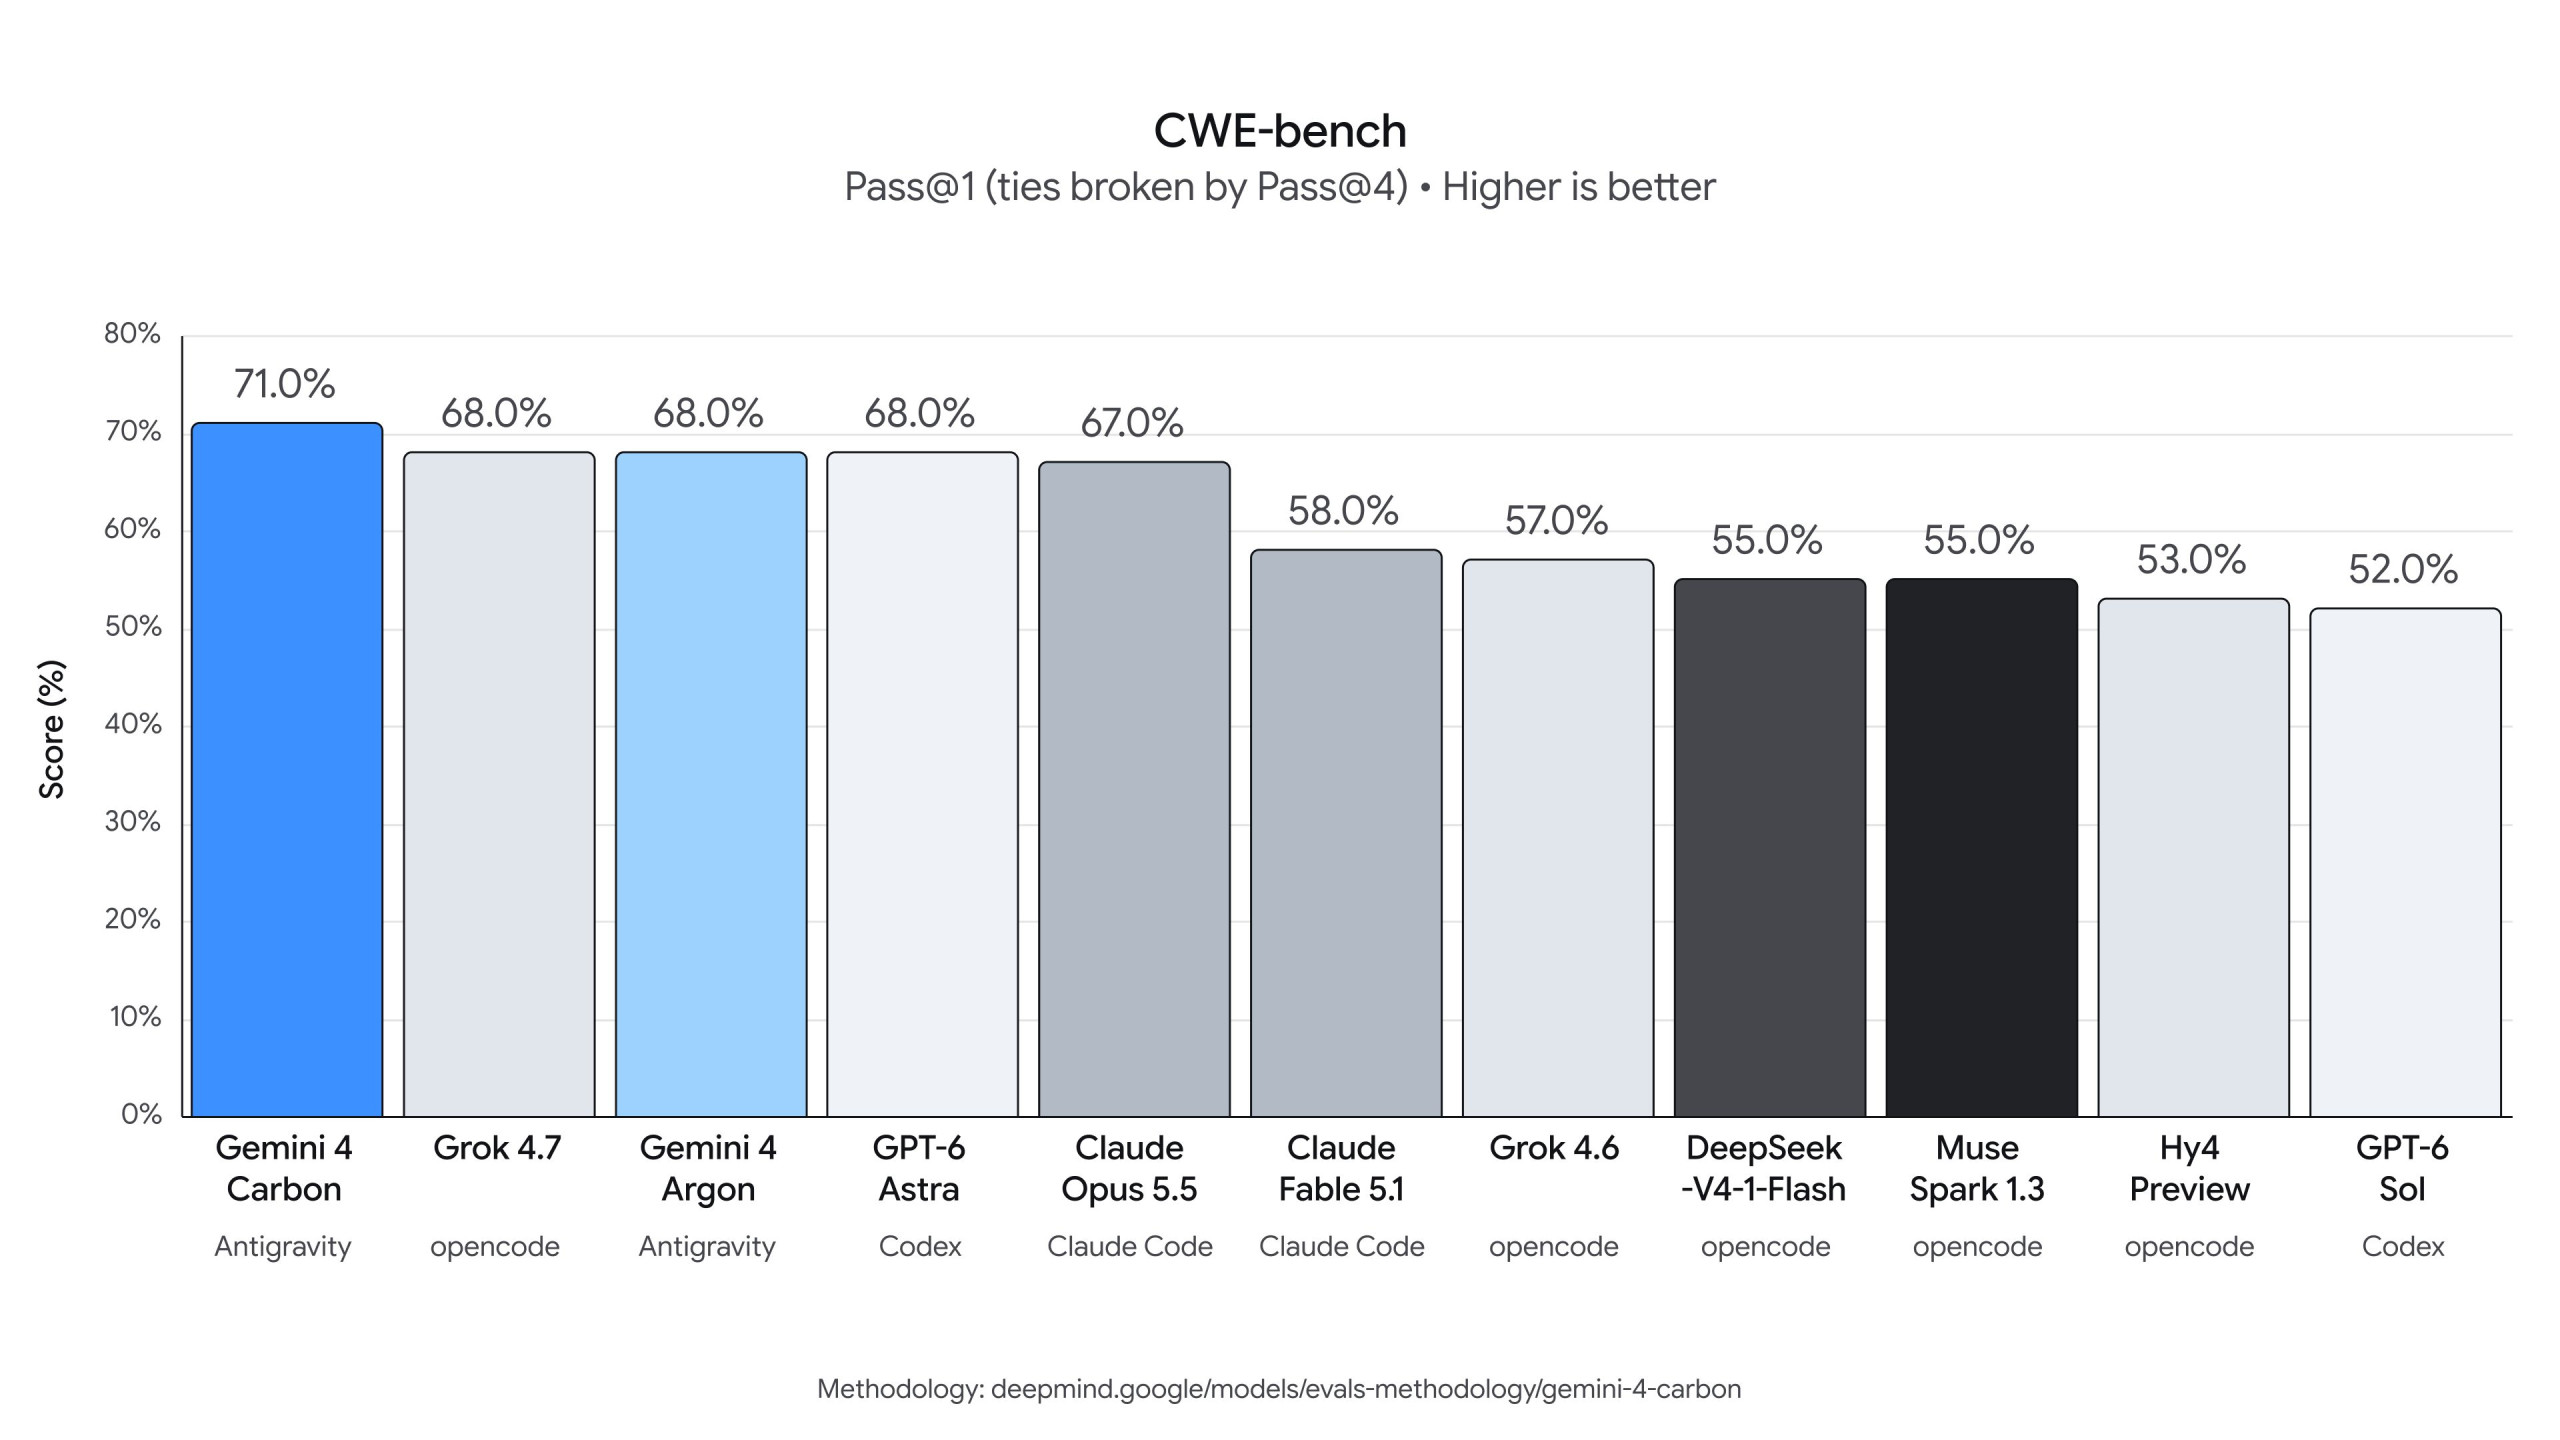
| CWE-bench | 71,0 % | 68,0 % | 68,0 % | 67,0 % |
| OSWorld-2.1 (offline) | 81,5 % | 74,7 % | 80,9 % | 87,2 % |
| FrontierSWE 2 | 61,2 % | 55,0 % | 65,5 % | 62,3 % |
Quelle: Google
Dieselbe Tabelle zeigt jedoch, dass Carbon nicht überall Erster ist: Claude Opus 5.5 behält den Vorteil bei OSWorld-2.1, einem Test zur Computernutzung (87,2 % gegenüber 81,5 %), und GPT-6 Astra bei FrontierSWE 2, einem Programmiertest (65,5 % gegenüber 61,2 %).
Gemini 4 Carbon bei 88,2 % in Cybersicherheit, aber mit ungleichen Tests
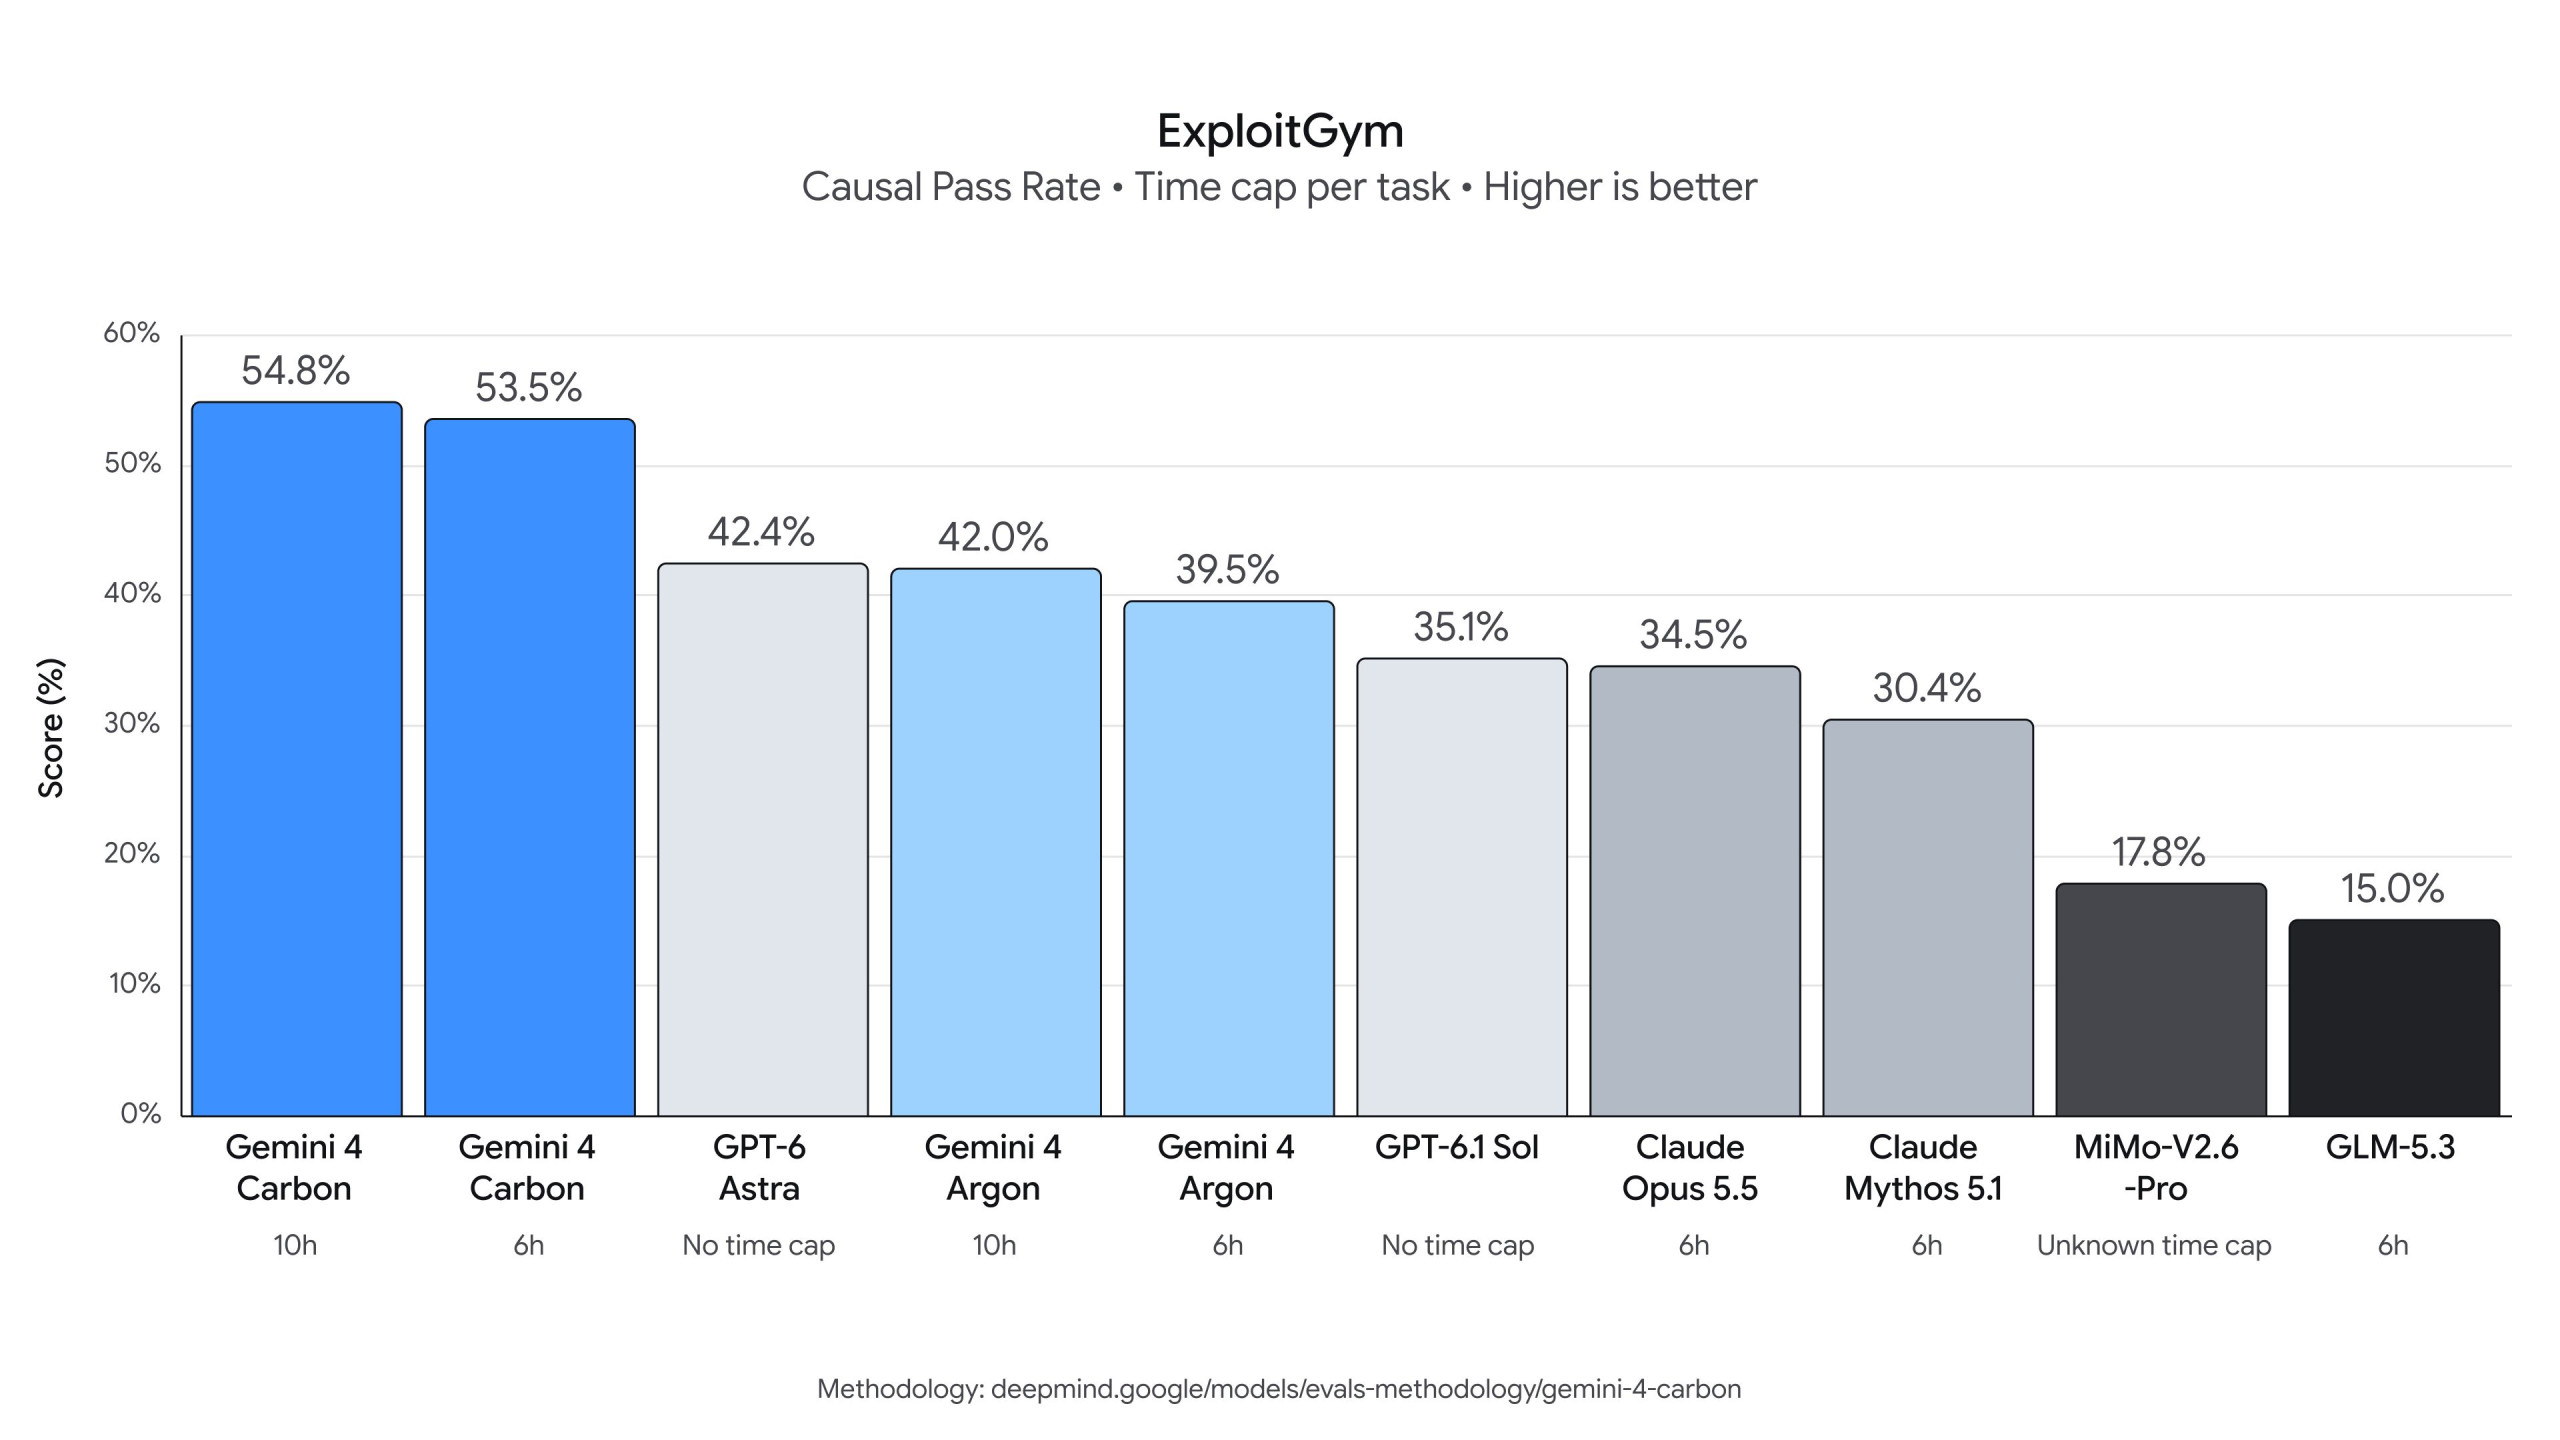
Für Cybersicherheit hebt Google drei externe Tests hervor, die ohne Schutzvorkehrungen durchgeführt wurden: 88,2 % bei SEC-bench Pro zum Auffinden von Schwachstellen, 54,8 % bei ExploitGym zum Ausnutzen und 71,0 % bei CWE-bench zum Beheben. Bei SEC-bench Pro folgt GPT-6 Astra mit 85,4 % und Argon mit 83,4 %. Bei ExploitGym hingegen ist der Abstand deutlicher: GPT-6 Astra liegt bei 42,4 % und Claude Opus 5.5 bei 34,5 %.
Diese Ergebnisse stammen von Google, und die Testbedingungen sind nicht für alle Modelle gleich. Die 54,8 % von Carbon entsprechen einem Zeitlimit von 10 Stunden pro Aufgabe. Mit 6 Stunden sinkt es auf 53,5 %, bleibt aber vor GPT-6 Astra, das ohne Zeitlimit getestet wurde, und vor Opus 5.5, das auf 6 Stunden begrenzt war. Bei CWE-bench verwenden die Modelle auch nicht dasselbe Programmierwerkzeug: Antigravity für Carbon, Codex für GPT-6 Astra, Claude Code für Opus 5.5. Und der Vorsprung gegenüber Argon beträgt nur 3 Punkte (71,0 % gegenüber 68,0 %).
Google zitiert auch das Chrome-Team, das berichtete, dass Carbon bei der Erstellung qualitativ hochwertiger Patches mehr als 10-mal besser abgeschnitten habe als ein großes Modell eines anderen, nicht genannten Labors, und Wiz, das Carbon bei Benchmarks für Web-Penetrationstests an der Spitze sieht.
Gemini 4 Carbon: Aufgaben über mehrere Tage und weniger Schummelei, laut Google
Carbon ist für langwierige Engineering-Probleme konzipiert: Intern haben Google-Teams beobachtet, wie es tagelang arbeitete, um die Ursache subtiler Bugs zu finden und sie in großen Codebasen zu beheben. Das Unternehmen betont auch die Ausrichtung. Bei Terminal-Bench 4.0 sinkt erfolgreiches Schummeln auf 0,0 % und die Versuche auf 0,4 %. Schwere Fehlausrichtungs-Warnungen gehen in seinen internen Code-Umgebungen um fast 80 % zurück, und unbegründete Behauptungen sind etwa 2-mal seltener als bei Argon. Beim Prompt-Injection-Test von Gray Swan war kein Angriff erfolgreich (0 %, gegenüber 0,7 % für Argon und 1,0 % für Opus 5.5). Diese Messungen werden von Google veröffentlicht und sind größtenteils intern: Nur Tests außerhalb seiner Teams werden zeigen, ob sie sich bestätigen.
Preis von Gemini 4 Carbon: 2 $ und 10 $ zum Start, dann 4 $ und 20 $
Carbon kostet während der Startphase 2 $ pro Million Input-Tokens und 10 $ für Output, wie Argon, mit einem Rabatt von 95 % auf zwischengespeicherte Input-Tokens. Anschließend steigt der Preis laut Fußnote der Ankündigung auf 4 $ und 20 $. Google gibt kein Enddatum dieses Angebots für Carbon an.
Werden diese Ergebnisse Bestand haben, wenn Carbon den Kreis der ausgewählten Sicherheitsexperten verlässt und zu den Entwicklern kommt, zu einem von Google nicht festgelegten Datum?
