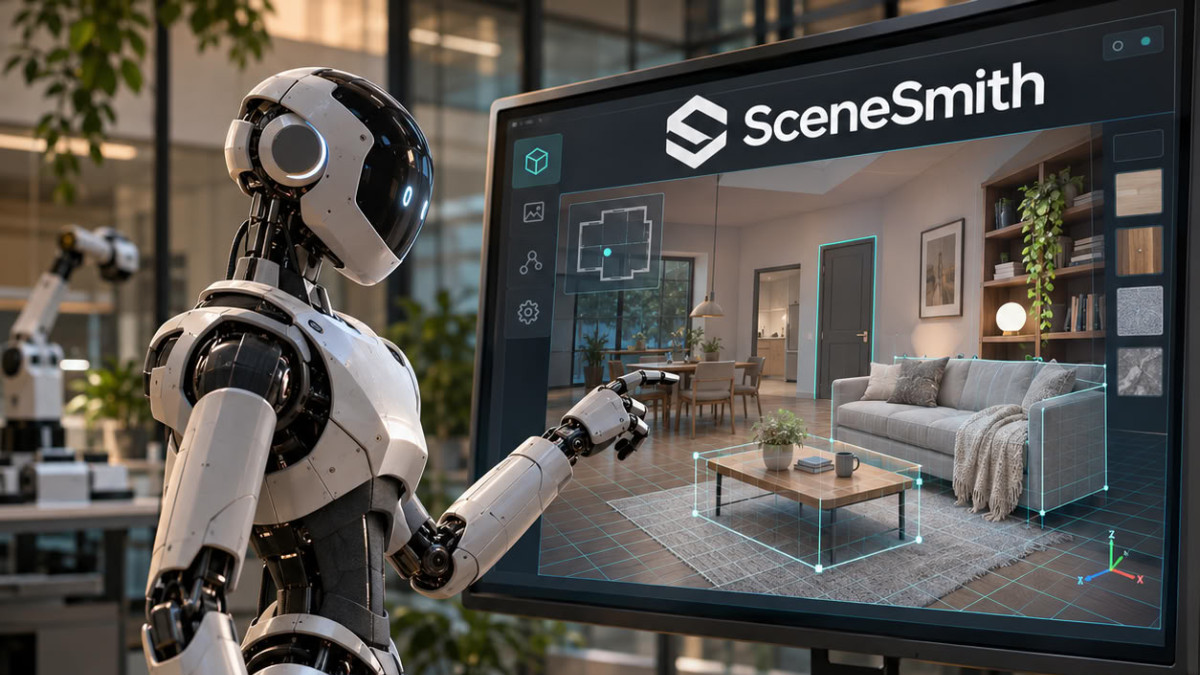

قدم باحثون من معهد ماساتشوستس للتكنولوجيا CSAIL ومعهد تويوتا للأبحاث نظام SceneSmith، وهو نظام يعتمد على ثلاثة وكلاء ذكاء اصطناعي لبناء مشاهد ثلاثية الأبعاد للداخلية مخصصة لتدريب الروبوتات. تتيح هذه البيئات الافتراضية للآلات التدرب وتجربة طرق مختلفة لإنجاز مهمة ما قبل نشرها. تم تقديم العمل كـ تسليط ضوء في مؤتمر 2026 International Conference on Machine Learning.
يظل العائق الرئيسي أمام الروبوتات العامة هو البيانات. مثل البشر، تتعلم الروبوتات في الغالب من خلال التجربة، لكن تعليم الآلة جسدياً، لعدد كبير من الإجراءات والأماكن، يتطلب الكثير من العمل والوقت. يذكر روس تيدريك، أستاذ في معهد ماساتشوستس للتكنولوجيا وباحث رئيسي في CSAIL، أن المحاكاة تشكل مساراً طبيعياً. لقد تقدمت محركات الفيزياء في المحاكاة بشكل كبير، لكن لا يزال من الصعب إنتاج محتوى غني ومتنوع بما يكفي ليعكس تعقيد العالم الحقيقي.
ثلاثة وكلاء لغرفة واحدة
يمكن لوكلاء الذكاء الاصطناعي، وهي برامج شبه مستقلة قادرة على إنجاز مهام محددة بوضوح، المساعدة بدقة في إنتاج هذه المشاهد. يعتمد SceneSmith على ثلاثة وكلاء يقومون بتجميع الأجسام والجدران والمظهر العام للمشهد ثلاثي الأبعاد. يعتمد كل منها على نموذج رؤية-لغة (VLM، وهو نظام قادر على معالجة النصوص والصور معاً)، في هذه الحالة GPT-5.2 من OpenAI، الذي تم تقديمه في المصدر كأحد أكثر النماذج تقدماً في المجال.
يتبع التشغيل سلسلة من ثلاث خطوات. يقوم وكيل «مصمم» بتوليد عناصر المشهد، ويقوم وكيل «ناقد» بالحكم على ما إذا كانت النتيجة تبدو واقعية، ويدير وكيل «منسق» التبادلات بين الاثنين ويقرر متى يكتمل التصميم. بمجرد اكتمال هذا التعاون، يمكن تحميل المشهد مباشرة في برنامج محاكاة فيزيائية. يعمل الوكلاء خطوة بخطوة: الأثاث، ثم الأجسام الموضوعة على الجدران ثم السقف، وأخيراً الأجسام التي يمكن للروبوت التعامل معها، مثل الخزانات التي يمكنه فتحها وإغلاقها.
يصف نيكولاس بفاف، طالب دكتوراه في الهندسة الكهربائية وعلوم الحاسوب في معهد ماساتشوستس للتكنولوجيا والمؤلف الرئيسي للورقة البحثية مع روس تيدريك، نتيجة أدهشته: «وجدنا أن النظام يمكنه بناء مشاهد ثلاثية الأبعاد بطريقة تشبه المصمم البشري». وفقاً له، قام الفريق بتوليد أكثر من 1300 مشهد، بترتيبات «مبدعة بشكل جنوني» ومتنوعة، لم يتلقها النظام صراحة في تعليماته.
وفقاً للباحثين، تحتوي هذه المشاهد على ما يصل إلى ستة أضعاف عدد الأجسام في الغرفة مقارنة بالطرق السابقة، مما يجعلها مفيدة لتعليم روبوت كيفية وضع كوب في الحوض، أو ترتيب الفاكهة على أطباق، أو نقل علبة من رف إلى طاولة.
واقعية تحت الاختبار
للتحقق من واقعية هذه العوالم الافتراضية، اختبر الباحثون سياسة مدربة مسبقاً، أي وحدة تحكم ذكاء اصطناعي تم تدريبها إلى حد كبير على بيانات حقيقية، ولم ترَ أبداً مشهداً من SceneSmith. عندما طُلب منه «أخذ التفاحة من الوعي ووضعها على لوح التقطيع»، أنجز الروبوت المحاكي المهمة. كما قادت الفرق روبوتات عن بعد في هذه المسافات لفتح الخزائن، وترتيب الزجاجات، والانتقال من غرفة إلى أخرى.
في اختبار آخر، تم توليد 100 مساحة فريدة وقام وكيل VLM بتقييم خطط عمل الروبوت، والتي حُكم عليها بالفشل في العديد من الحالات. اتفق البشر مع هذه الأحكام في أكثر من 99٪ من الحالات، وفقاً للباحثين، مما قد يتيح استبعاد الأساليب المعيبة في المحاكاة قبل نشرها. بالإضافة إلى ذلك، حكم أكثر من 200 مستخدم على أن المرئيات أكثر واقعية من تلك الخاصة بالأنظمة المنافسة في أكثر من 90٪ من الحالات.
لكن النظام له تكلفة زمنية. قد يستغرق إنتاج مشهد واحد عدة ساعات، لأن الوكلاء ينشئون ويفحصون كل جسم عن كثب. يمكن أن يحسن زيادة قوة الحوسبة الكفاءة، ويتطلع الفريق إلى توسيع النظام ليشمل الأجسام القابلة للتشوه، مثل الإسفنج، إذا أصبحت مكتبات ثلاثية الأبعاد واسعة النطاق متاحة.
