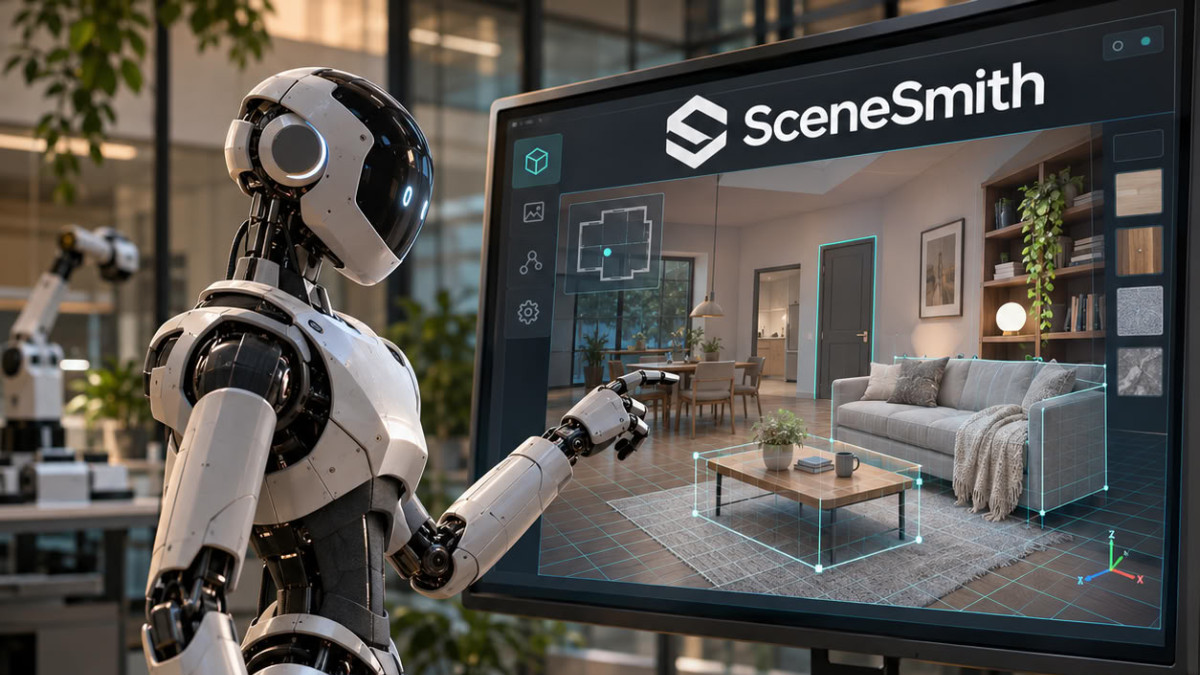

MIT CSAILとToyota Research Instituteの研究者らは、ロボット訓練用の屋内3Dシーン構築に3つのAIエージェントを活用するシステム「SceneSmith」を発表した。この仮想環境により、ロボットは実稼働前にタスク実行の様々な方法を試行・練習できる。研究成果は、2026 International Conference on Machine Learningでスポットライト発表された。
汎用ロボティクスの主な障壁は依然としてデータである。人間と同様、ロボットは主に経験から学習するが、多数の動作と場所について物理的に機械に教えるには多大な労力と時間を要する。MIT教授兼CSAIL主任研究員のRuss Tedrakeは、シミュレーションが自然な解決策であると指摘する。シミュレータの物理エンジンは大きく進歩したが、現実世界の複雑さを反映する十分に豊かで多様なコンテンツを生成することは依然として困難だ。
一つの部屋に三つのエージェント
明確に定義されたタスクを実行できる半自律プログラムであるAIエージェントは、まさにこうしたシーンの生成を支援できる。SceneSmithは、3Dシーンのオブジェクト、壁、全体的な外観を組み立てる3つのエージェントを利用する。各エージェントは、テキストと画像の両方を処理できるシステムである視覚言語モデル(VLM)に基づいており、具体的には、ソースで同分野で最も先進的なモデルの一つと紹介されているOpenAIのGPT-5.2を使用している。
動作は三段階の連鎖に従う。「デザイナー」エージェントがシーンの要素を生成し、「批評家」エージェントが結果が現実的かどうかを判断し、「オーケストレーター」エージェントが両者のやり取りを管理し、設計が完了したタイミングを決定する。この協業が完了すると、シーンは直接物理シミュレーションソフトウェアに読み込むことができる。エージェントは段階的に作業を進める:家具、壁に置かれたオブジェクト、次に天井、そして最後に、ロボットが開閉できるキャビネットなど、操作可能なオブジェクトを配置する。
MIT電気工学・計算機科学博士課程で、Russ Tedrakeと共に論文の筆頭著者であるNicholas Pfaffは、驚くべき結果を説明する:「我々は、システムが人間のデザイナーのように3Dシーンを構築できることを確認した。」彼によれば、チームは1300以上のシーンを生成し、システムが指示で明示的に受け取っていなかった「狂ったように創造的」で多様な配置を実現した。
研究者らによると、これらのシーンは従来手法に比べて部屋あたり最大6倍のオブジェクトを含んでおり、ロボットにカップを流しに置く、果物を皿に盛る、缶を棚からテーブルに移動させることを学習させるのに有用だ。
試されるリアリズム
これらの仮想世界のリアリズムを検証するため、研究者らは事前学習済みポリシー、つまり主に実データで訓練され、SceneSmithのシーンを一度も見たことのないAIコントローラーをテストした。「ボウルからリンゴを取り出し、まな板の上に置く」ように指示すると、シミュレートされたロボットはタスクを完了した。チームはまた、これらの空間でロボットを遠隔操作し、キャビネットを開けたり、ボトルを片付けたり、部屋から部屋へ移動したりした。
別のテストでは、100のユニークな空間が生成され、VLMエージェントがロボットの行動計画を評価したところ、多くのケースで欠陥があると判断された。研究者によれば、人間は99%以上のケースでこの判断に同意し、これは展開前に欠陥のあるアプローチをシミュレーションで排除できる可能性を示している。さらに、200人以上のユーザーが、90%以上のケースで競合システムよりも視覚的に現実的であると評価した。
ただし、このシステムには時間コストがかかる。エージェントが各オブジェクトを細部まで作成・検討するため、単一シーンの生成に数時間を要することがある。計算能力の向上が効率化につながる可能性があり、チームは、大規模な3Dライブラリが利用可能になれば、スポンジなどの変形可能なオブジェクトへのシステム拡張を検討している。
