OVHcloud enthüllt Olala mini 7A1B, das erste Sprachmodell seiner neuen Familie: 7 Milliarden Parameter, von denen nur 1 Milliarde aktiv ist, angekündigt für den Betrieb auf einer 8-GB-Grafikkarte oder sogar auf einem einfachen Prozessor. Die Gewichte sollen am Donnerstag, den 19. November, unter Apache-2.0-Lizenz veröffentlicht werden, doch bisher liegen keine Qualitätsbewertungen vor.
OVHcloud stellt Olala mini als ersten Vertreter einer intern entwickelten Sprachmodellfamilie in einer Pressemitteilung vom 17. November aus Roubaix vor. Die offizielle Vorstellung erfolgt am Donnerstag, den 19. November, auf dem OVHcloud AI Summit: An diesem Tag will der Konzern die Gewichte, das vortrainierte Basismodell, einen technischen Bericht und eine Dokumentation zur Einhaltung des AI Act auf Hugging Face veröffentlichen. Octave Klaba, CEO von OVHcloud, hat die Ankündigung auf X gepostet. Bis dahin sind nur die Zahlen des Unternehmens verfügbar.
Olala mini 7A1B: 7 Milliarden Parameter, aber nur 1 Milliarde aktiv
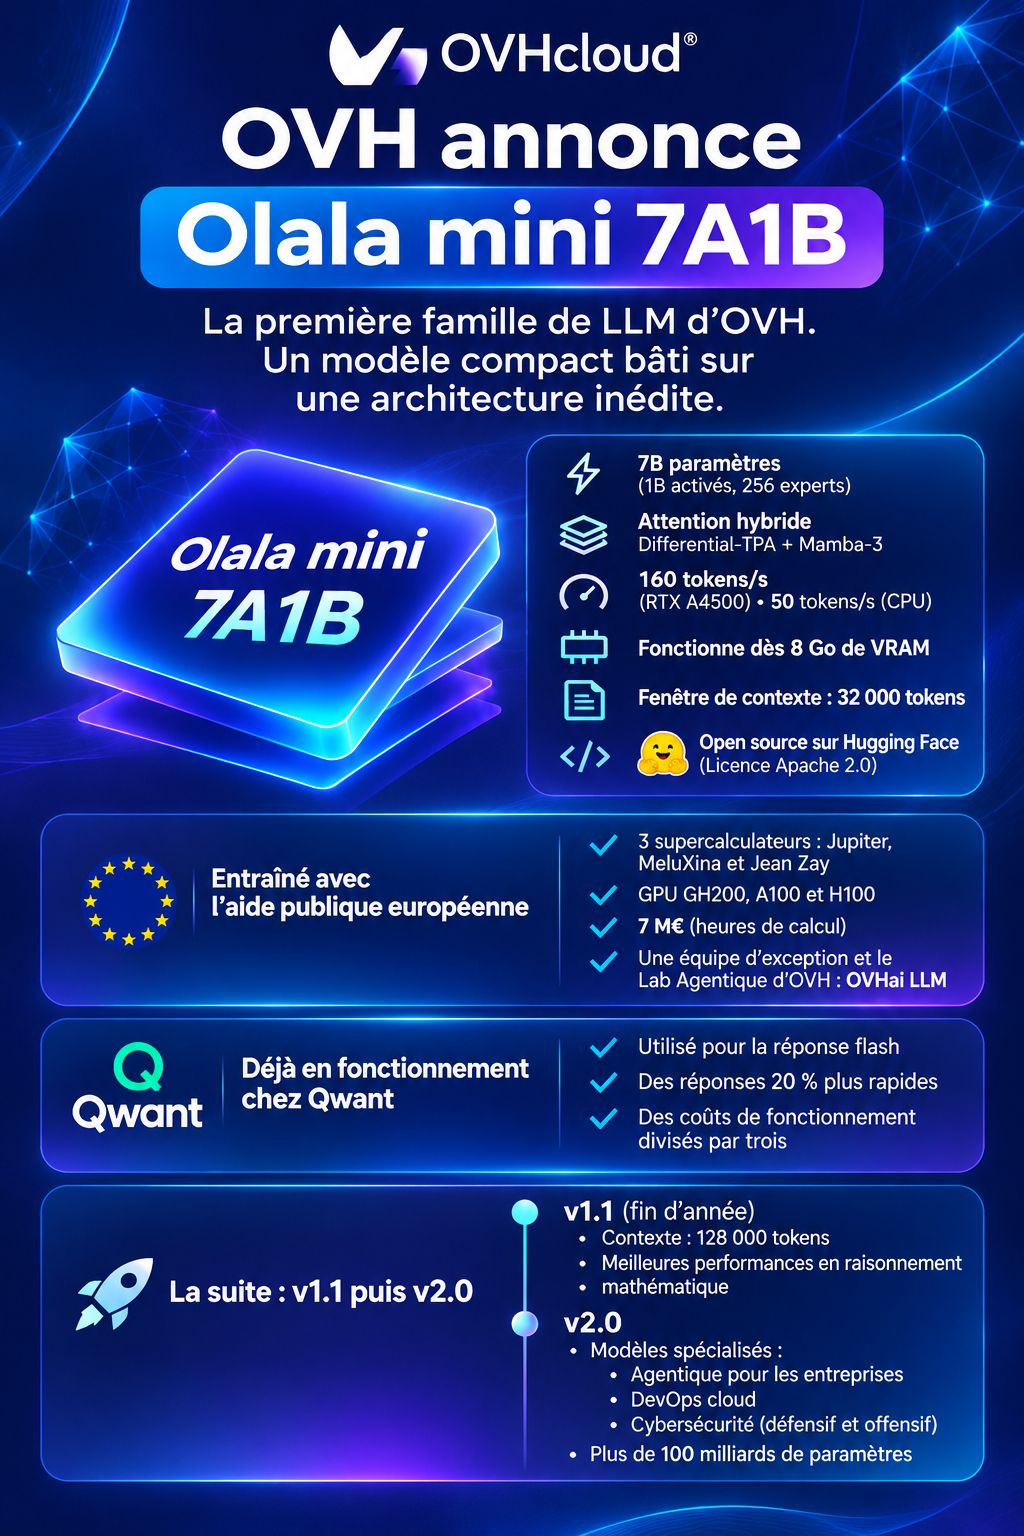
Der Name liest sich wie ein Datenblatt: 7 Milliarden Parameter insgesamt, davon 1 Milliarde aktiviert pro Anfrage, verteilt auf 256 Experten pro Schicht. Mit anderen Worten: Olala mini ist ein Mixture-of-Experts-Modell, bei dem nur ein Teil des Netzwerks an einem gegebenen Text arbeitet. OVHcloud sieht darin ein schnelleres und speichereffizienteres Modell.
Die Aufmerksamkeitsmechanismen sind hybrid, mit Differential-TPA und Mamba-3, und das Modell wird im BF16-Format bereitgestellt. Laut Next reduziert die erste Komponente den für die Inferenz benötigten Speicher und konzentriert die Aufmerksamkeit auf nützliche Informationen. Die Mamba-3-Schichten arbeiten mit einer konstant großen Zusammenfassung, während der klassische Aufmerksamkeitsmechanismus mit der Konversation mehr Speicher benötigt. OVHcloud spricht von einer « einzigartigen » Architektur, doch wie diese Bausteine zusammengesetzt sind, ist noch unklar.
Olala mini auf 8 GB oder auf einem einfachen Prozessor: Angekündigte Durchsätze, keine Bewertung
Was die Geschwindigkeit angeht, kündigt OVHcloud 160 Tokens pro Sekunde auf einer RTX A4500 und 50 Tokens pro Sekunde auf einem einfachen Prozessor an, mit einem Kontextfenster von 32.000 Tokens. Diese Zahlen stammen vom Konzern, nicht von einem unabhängigen Benchmark.
Die Pressemitteilung veröffentlicht jedoch keine Benchmark-Ergebnisse. Man weiß also, wie schnell Olala mini schreibt. Aber wie gut sind seine Antworten?
Ein weiterer zu klärender Punkt: der Speicher. Sieben Milliarden Parameter in BF16 (je zwei Bytes) wiegen etwa 14 GB, fast das Doppelte der angekündigten 8 GB, und die Pressemitteilung erklärt nicht, wie diese Lücke geschlossen wird. Die RTX A4500 ist zudem eine professionelle Karte mit 20 GB, was bedeutet, dass die 160 Tokens pro Sekunde nicht auf einer 8-GB-Karte gemessen wurden. Wenn Sie Olala mini auf Ihrem PC laufen lassen wollten, ist diese 8-GB-Angabe die erste, die Sie überprüfen sollten.
Bleibt das Fenster von 32.000 Tokens, das Next eher für schnelle Antworten als für komplexe Anfragen geeignet hält. OVHcloud verspricht 128.000 Tokens mit Version 1.1.
Qwant nutzt Olala mini bereits: Antworten 20 % schneller, laut OVHcloud
OVHcloud behauptet, Qwant habe Olala mini bereits für seine Flash-Antwort-Funktion übernommen: Antworten seien 20 % schneller und die Betriebskosten seien im Vergleich zum zuvor verwendeten Modell um zwei Drittel gesunken. Laut Next setzte Qwant bisher auf Modelle von Mistral.
Dieses Erfahrungsfeedback bleibt eine Aussage von OVHcloud, keine unabhängige Messung. Und der Kontext wiegt: Qwant gehört einem Unternehmen, das sich im gemeinsamen Besitz der Familie Klaba und der Caisse des dépôts befindet.
Olala mini: 7 Mio. € öffentliche Rechenleistung, dann über 100 Milliarden Parameter in v2.0
Olala mini wurde auf Jupiter, MeluXina und Jean Zay trainiert, drei europäischen öffentlichen Supercomputern mit GH200-, A100- und H100-GPUs. OVHcloud beziffert diese Unterstützung mit dem Äquivalent von 7 Millionen Euro an Rechenstunden, dankt den öffentlichen Stellen und sagt, dass daraus ein herausragendes Team hervorgegangen sei, das zum Agentic Lab von OVH wurde: OVHai LLM.
Die personellen Ressourcen bleiben bescheiden: Laut AFP arbeiten weniger als hundert Personen bei OVHcloud an KI, gegenüber über 1.000 bei Mistral. Octave Klaba sagt, er wolle « zeigen, dass es möglich ist, ein Modell mit geringen Mitteln zu trainieren ».
Eine weitere Nuance betrifft das Label « offen »: Die Gewichte, das Basismodell, der technische Bericht und die AI-Act-Dokumentation werden veröffentlicht, doch Next stellt fest, dass Code und Trainingsdaten nicht erwähnt werden.
OVHcloud kündigt die Fortsetzung in zwei Schritten an. Version 1.1, die bis Ende des Jahres erwartet wird, soll den Kontext auf 128.000 Tokens erweitern und das mathematische Schlussfolgern verbessern. Version 2.0, ohne Datum, wird über 100 Milliarden Parameter haben und in spezialisierte Modelle aufgeteilt sein: Agentic für Unternehmen (OVHai Workspace, dessen verschlüsselte Version Modelle erfordert, die lokal auf dem Arbeitsplatz laufen können), Cloud-DevOps und Cybersicherheit, sowohl defensiv als auch offensiv.
Es bleibt abzuwarten, ob die Antworten von Olala mini im Vergleich zu anderen kleinen offenen Modellen bestehen können. Der für Donnerstag erwartete technische Bericht wird der erste Ort sein, an dem man nach der Antwort suchen kann…
