OVHcloud onthult Olala mini 7A1B, het eerste taalmodel van zijn nieuwe familie: 7 miljard parameters waarvan slechts 1 miljard actief, naar verluidt draaiend op een grafische kaart van 8 GB, of zelfs op een eenvoudige processor. De gewichten worden donderdag 19 november online gezet onder de Apache 2.0-licentie, maar voorlopig worden er geen kwaliteitsscores bijgeleverd.
OVHcloud stelt Olala mini voor als de eerste vertegenwoordiger van een intern ontwikkelde familie van taalmiddelen, in een persbericht van 17 november, uit Roubaix. De officiële lancering vindt plaats op donderdag 19 november, tijdens de OVHcloud AI Summit: die dag moet de groep op Hugging Face de gewichten, het voorgetrainde basismodel, een technisch rapport en een documentatie over de naleving van de AI Act publiceren. Octave Klaba, CEO van OVHcloud, heeft de aankondiging op X gepubliceerd. Tot die tijd zijn de beschikbare cijfers die van het bedrijf zelf.
Olala mini 7A1B: 7 miljard parameters, maar slechts 1 miljard actief
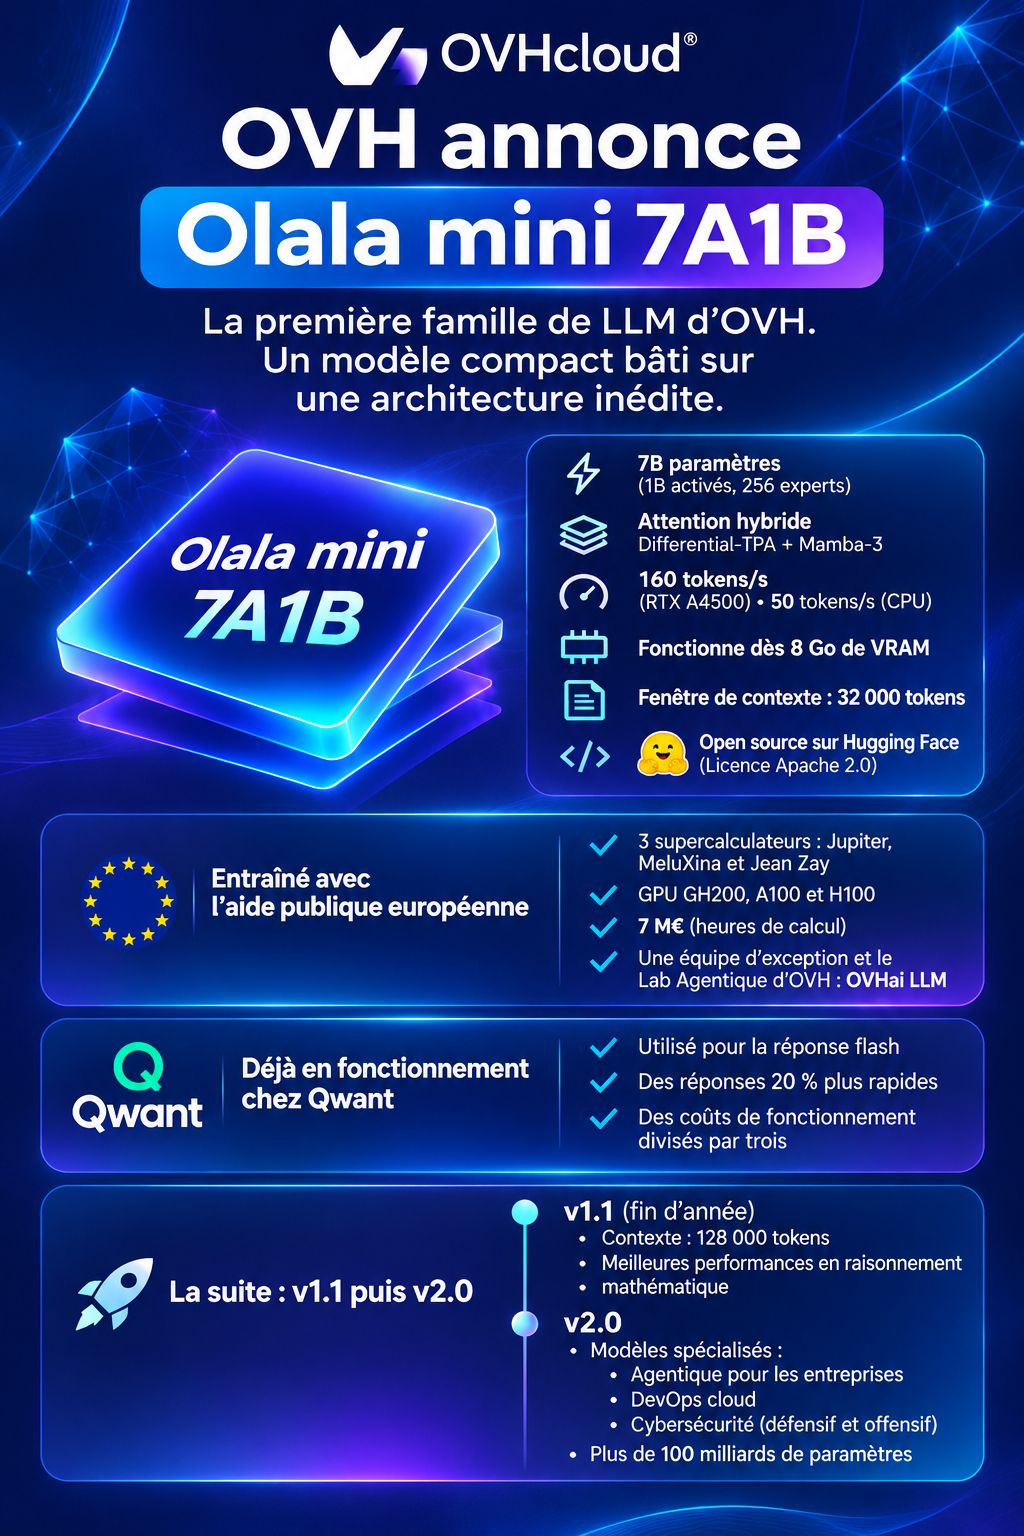
De naam leest als een technische fiche: 7 miljard parameters in totaal, waarvan 1 miljard geactiveerd per verzoek, verdeeld over 256 experts per laag. Met andere woorden, Olala mini is een mixture of experts-model, waarbij slechts een fractie van het netwerk werkt aan een gegeven tekst. OVHcloud ziet hierin een sneller en minder geheugenvretend model.
De aandacht is hybride, met Differential-TPA en Mamba-3, en het model komt uit in BF16-formaat. Volgens Next vermindert de eerste bouwsteen het voor inferentie benodigde geheugen en concentreert de aandacht op nuttige informatie. De Mamba-3-lagen werken op een samenvatting van constante grootte, terwijl het klassieke aandachtssysteem zijn geheugen ziet groeien met het gesprek. OVHcloud spreekt van een « ongekende » architectuur, maar hoe deze bouwstenen samengesteld zijn, is nog onbekend.
Olala mini op 8 GB of op een eenvoudige processor: aangekondigde snelheden, geen scores
Qua snelheid kondigt OVHcloud 160 tokens per seconde aan op een RTX A4500 en 50 tokens per seconde op een eenvoudige processor, met een contextvenster van 32.000 tokens. Deze cijfers komen van de groep, niet van een onafhankelijke benchmark.
Het persbericht publiceert echter geen benchmarkresultaten. We weten dus hoe snel Olala mini schrijft. Maar wat zijn de antwoorden waard?
Een ander punt dat opgehelderd moet worden: het geheugen. Zeven miljard parameters in BF16 (elk twee bytes) wegen ongeveer 14 GB, bijna het dubbele van de aangekondigde 8 GB, en het persbericht legt niet uit hoe dit verschil wordt opgevangen. De RTX A4500 is trouwens een professionele kaart van 20 GB, wat betekent dat de 160 tokens per seconde niet gemeten zijn op een kaart van 8 GB. Als je van plan was Olala mini op je PC te draaien, is dit cijfer van 8 GB het eerste dat je moet controleren.
Dan is er nog het venster van 32.000 tokens, dat Next meer geschikt vindt voor snelle antwoorden dan voor complexe verzoeken. OVHcloud belooft 128.000 tokens met versie 1.1.
Qwant gebruikt Olala mini al: antwoorden 20% sneller, volgens OVHcloud
OVHcloud beweert dat Qwant Olala mini al heeft geadopteerd voor zijn flash-antwoordfunctie: antwoorden 20% sneller en operationele kosten gedeeld door drie, vergeleken met het eerder gebruikte model. Volgens Next vertrouwde Qwant tot nu toe op modellen van Mistral.
Deze ervaring blijft een verklaring van OVHcloud, geen onafhankelijke meting. En de context weegt: Qwant is eigendom van een bedrijf dat mede in handen is van de familie Klaba en de Caisse des dépôts.
Olala mini: 7 M€ aan publieke rekenkracht, daarna meer dan 100 miljard parameters in v2.0
Olala mini is getraind op Jupiter, MeluXina en Jean Zay, drie Europese publieke supercomputers uitgerust met GH200-, A100- en H100-GPU’s. OVHcloud waardeert deze steun op het equivalent van 7 miljoen euro aan rekentuurtjes, bedankt de overheid en zegt dat het een uitzonderlijk team heeft doen ontstaan, dat het Lab Agentique van OVH is geworden: OVHai LLM.
De menselijke middelen blijven bescheiden: minder dan honderd personen werken aan AI bij OVHcloud, tegenover meer dan 1.000 bij Mistral, volgens AFP. Octave Klaba zegt te willen « aantonen dat het mogelijk is een model te trainen met weinig middelen ».
Een andere nuance, over het label « open »: de gewichten, het basismodel, het technische rapport en de AI Act-documentatie zullen worden gepubliceerd, maar Next merkt op dat de code en de trainingsgegevens niet worden genoemd.
OVHcloud kondigt het vervolg in twee fasen aan. Versie 1.1, verwacht tegen het einde van het jaar, moet de context op 128.000 tokens brengen en het wiskundig redeneren verbeteren. Versie 2.0, zonder datum, zal meer dan 100 miljard parameters overschrijden en worden opgesplitst in gespecialiseerde modellen: agentic voor bedrijven (OVHai Workspace, waarvan de versleutelde versie modellen vereist die lokaal op de werkplek kunnen draaien), cloud DevOps en cybersecurity, zowel defensief als offensief.
Het blijft de vraag of de antwoorden van Olala mini kunnen tippen aan die van andere kleine open modellen. Het technische rapport, verwacht op donderdag, zal de eerste plaats zijn om het antwoord te zoeken…
