OVHcloud desvela Olala mini 7A1B, el primer modelo de lenguaje de su nueva familia: 7 mil millones de parámetros de los cuales solo 1 mil millones están activos, anunciado para funcionar en una tarjeta gráfica de 8 GB, incluso en un simple procesador. Los pesos se publicarán el jueves 19 de noviembre bajo licencia Apache 2.0, pero por ahora no van acompañados de ninguna puntuación de calidad.
OVHcloud presenta Olala mini como el primer representante de una familia de modelos de lenguaje diseñada internamente, en un comunicado fechado el 17 de noviembre, en Roubaix. El lanzamiento oficial tiene lugar el jueves 19 de noviembre, durante el OVHcloud AI Summit: ese día, el grupo debe publicar en Hugging Face los pesos, el modelo base preentrenado, un informe técnico y una documentación de conformidad con la AI Act. Octave Klaba, CEO de OVHcloud, ha publicado el anuncio en X. Mientras tanto, las cifras disponibles son las de la empresa.
Olala mini 7A1B: 7 mil millones de parámetros, pero solo 1 mil millones activos
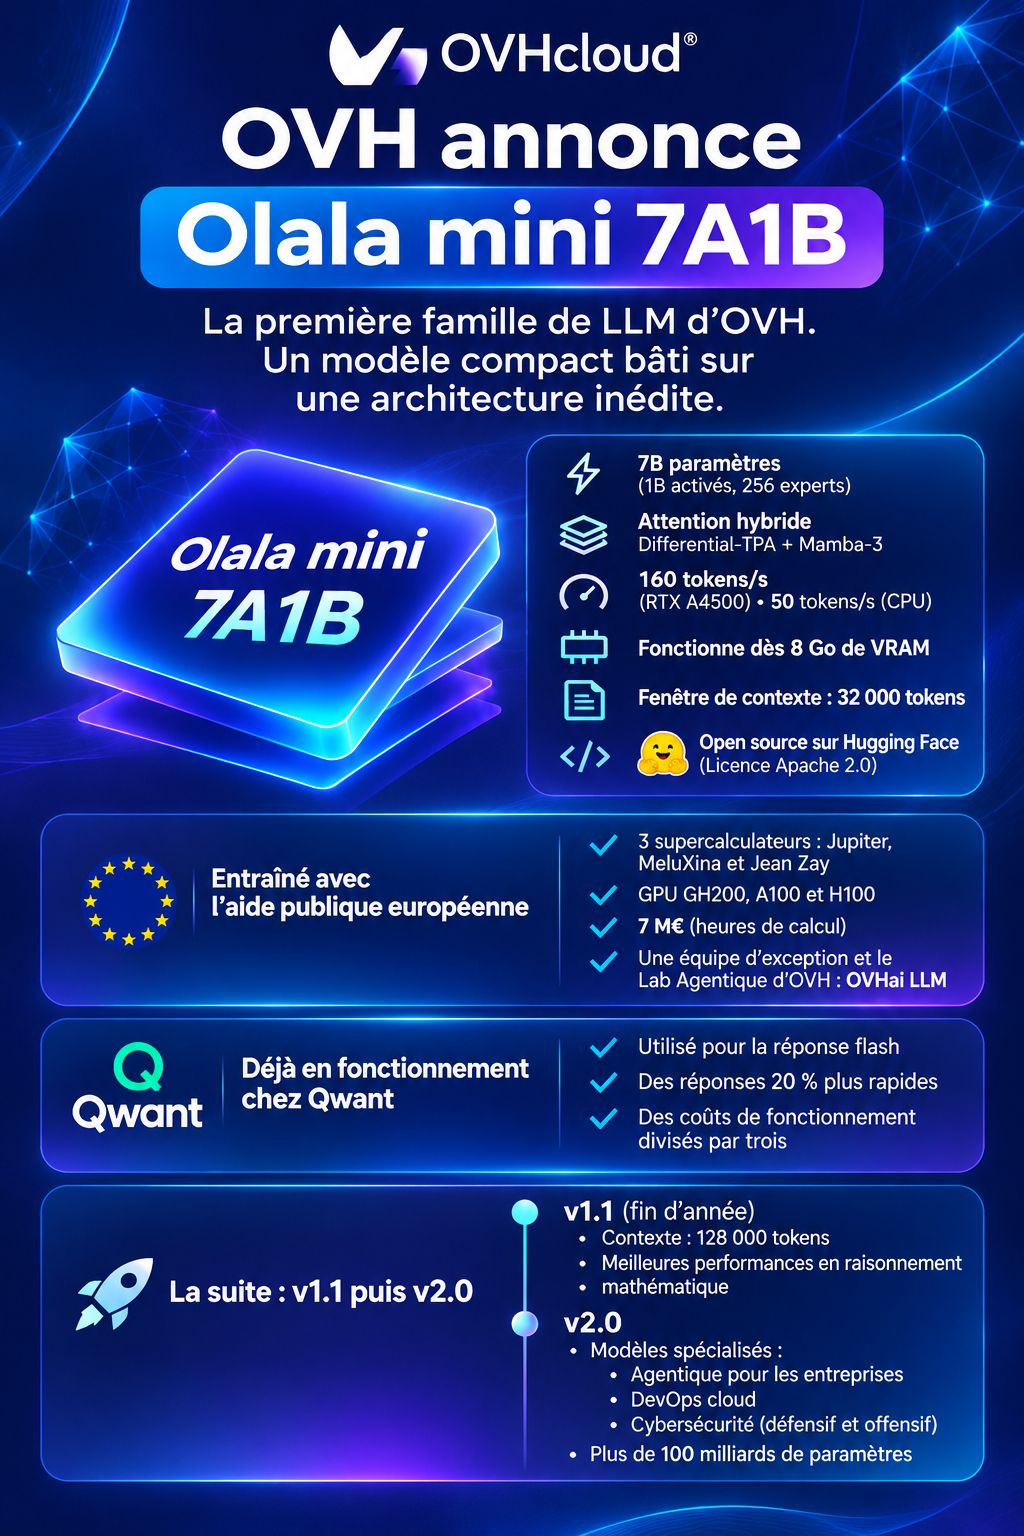
El nombre se lee como una ficha técnica: 7 mil millones de parámetros en total, de los cuales 1 mil millones se activan en cada solicitud, distribuidos entre 256 expertos por capa. En otras palabras, Olala mini es un modelo de mezcla de expertos, donde solo una fracción de la red trabaja en un texto dado. OVHcloud lo ve como un modelo más rápido y menos voraz en memoria.
La atención es híbrida, con Differential-TPA y Mamba-3, y el modelo sale en formato BF16. Según Next, el primer bloque reduce la memoria necesaria para la inferencia y concentra la atención en la información útil. Las capas Mamba-3, por su parte, trabajan sobre un resumen de tamaño constante, mientras que la atención clásica ve crecer su memoria con la conversación. OVHcloud habla de una arquitectura « inédita », pero aún se desconoce cómo se ensamblan estos bloques.
Olala mini en 8 GB o en un simple procesador: rendimientos anunciados, ninguna puntuación
En cuanto a velocidad, OVHcloud anuncia 160 tokens por segundo en una RTX A4500 y 50 tokens por segundo en un simple procesador, con una ventana de contexto de 32 000 tokens. Estas cifras provienen del grupo, no de un banco de pruebas independiente.
El comunicado, sin embargo, no publica ningún resultado de benchmark. Así que sabemos a qué velocidad escribe Olala mini. Pero, ¿qué valen sus respuestas?
Otro punto por aclarar: la memoria. Siete mil millones de parámetros en BF16 (a dos bytes cada uno) pesan unos 14 GB, casi el doble de los 8 GB anunciados, y el comunicado no explica cómo se cubre la diferencia. Por cierto, la RTX A4500 es una tarjeta profesional de 20 GB, lo que significa que los 160 tokens por segundo no se midieron en una tarjeta de 8 GB. Si pensabas hacer funcionar Olala mini en tu PC, esta cifra de 8 GB es la primera que debes verificar.
Queda la ventana de 32 000 tokens, que Next considera más adecuada para respuestas rápidas que para consultas complejas. OVHcloud promete 128 000 tokens con la versión 1.1.
Qwant ya utiliza Olala mini: respuestas un 20 % más rápidas, según OVHcloud
OVHcloud afirma que Qwant ya ha adoptado Olala mini para su función de respuesta flash: respuestas un 20 % más rápidas y costes operativos divididos por tres, en comparación con el modelo utilizado anteriormente. Según Next, Qwant se basaba hasta ahora en modelos de Mistral.
Este retorno de experiencia sigue siendo una declaración de OVHcloud, no una medida independiente. Y el contexto pesa: Qwant pertenece a una sociedad codetenida por la familia Klaba y la Caisse des dépôts.
Olala mini: 7 M€ de cálculo público, luego más de 100 mil millones de parámetros en v2.0
Olala mini se entrenó en Jupiter, MeluXina y Jean Zay, tres supercomputadores públicos europeos equipados con GPU GH200, A100 y H100. OVHcloud cifra este apoyo en el equivalente a 7 millones de euros en horas de cálculo, agradece a las autoridades públicas y dice que ha hecho emerger un equipo excepcional, convertido en el Lab Agentique de OVH: OVHai LLM.
Los medios humanos siguen siendo modestos: menos de un centenar de personas trabajan en IA en OVHcloud, frente a más de 1 000 en Mistral, según la AFP. Octave Klaba dice querer « demostrar que es posible entrenar un modelo con pocos medios ».
Otro matiz, sobre la etiqueta « abierto »: se publicarán los pesos, el modelo base, el informe técnico y la documentación de la AI Act, pero Next señala que el código y los datos de entrenamiento no se mencionan.
OVHcloud anuncia la continuación en dos fases. La versión 1.1, prevista para finales de año, debe llevar el contexto a 128 000 tokens y mejorar el razonamiento matemático. La versión 2.0, sin fecha, superará los 100 mil millones de parámetros y se desplegará en modelos especializados: la agentica para empresas (OVHai Workspace, cuya versión cifrada requerirá modelos capaces de funcionar localmente en el puesto de trabajo), el DevOps cloud y la ciberseguridad, tanto defensiva como ofensiva.
Queda por saber si las respuestas de Olala mini resisten la comparación con otros pequeños modelos abiertos. El informe técnico, previsto para el jueves, será el primer lugar donde buscar la respuesta…
