A OVHcloud revela o Olala mini 7A1B, o primeiro modelo de linguagem da sua nova família: 7 mil milhões de parâmetros, dos quais apenas 1 milhão está ativo, anunciado para funcionar numa placa gráfica de 8 GB, ou mesmo num simples processador. Os pesos devem ser disponibilizados online na quinta-feira, 19 de novembro, sob licença Apache 2.0, mas nenhuma pontuação de qualidade os acompanha por enquanto.
A OVHcloud apresenta o Olala mini como o primeiro representante de uma família de modelos de linguagem concebida internamente, num comunicado datado de 17 de novembro, em Roubaix. O lançamento oficial ocorre na quinta-feira, 19 de novembro, durante o OVHcloud AI Summit: nesse dia, o grupo deve publicar no Hugging Face os pesos, o modelo base pré-treinado, um relatório técnico e uma documentação de conformidade com o AI Act. Octave Klaba, CEO da OVHcloud, publicou o anúncio no X. Entretanto, os números disponíveis são os da empresa.
Olala mini 7A1B: 7 mil milhões de parâmetros, mas apenas 1 milhão ativo
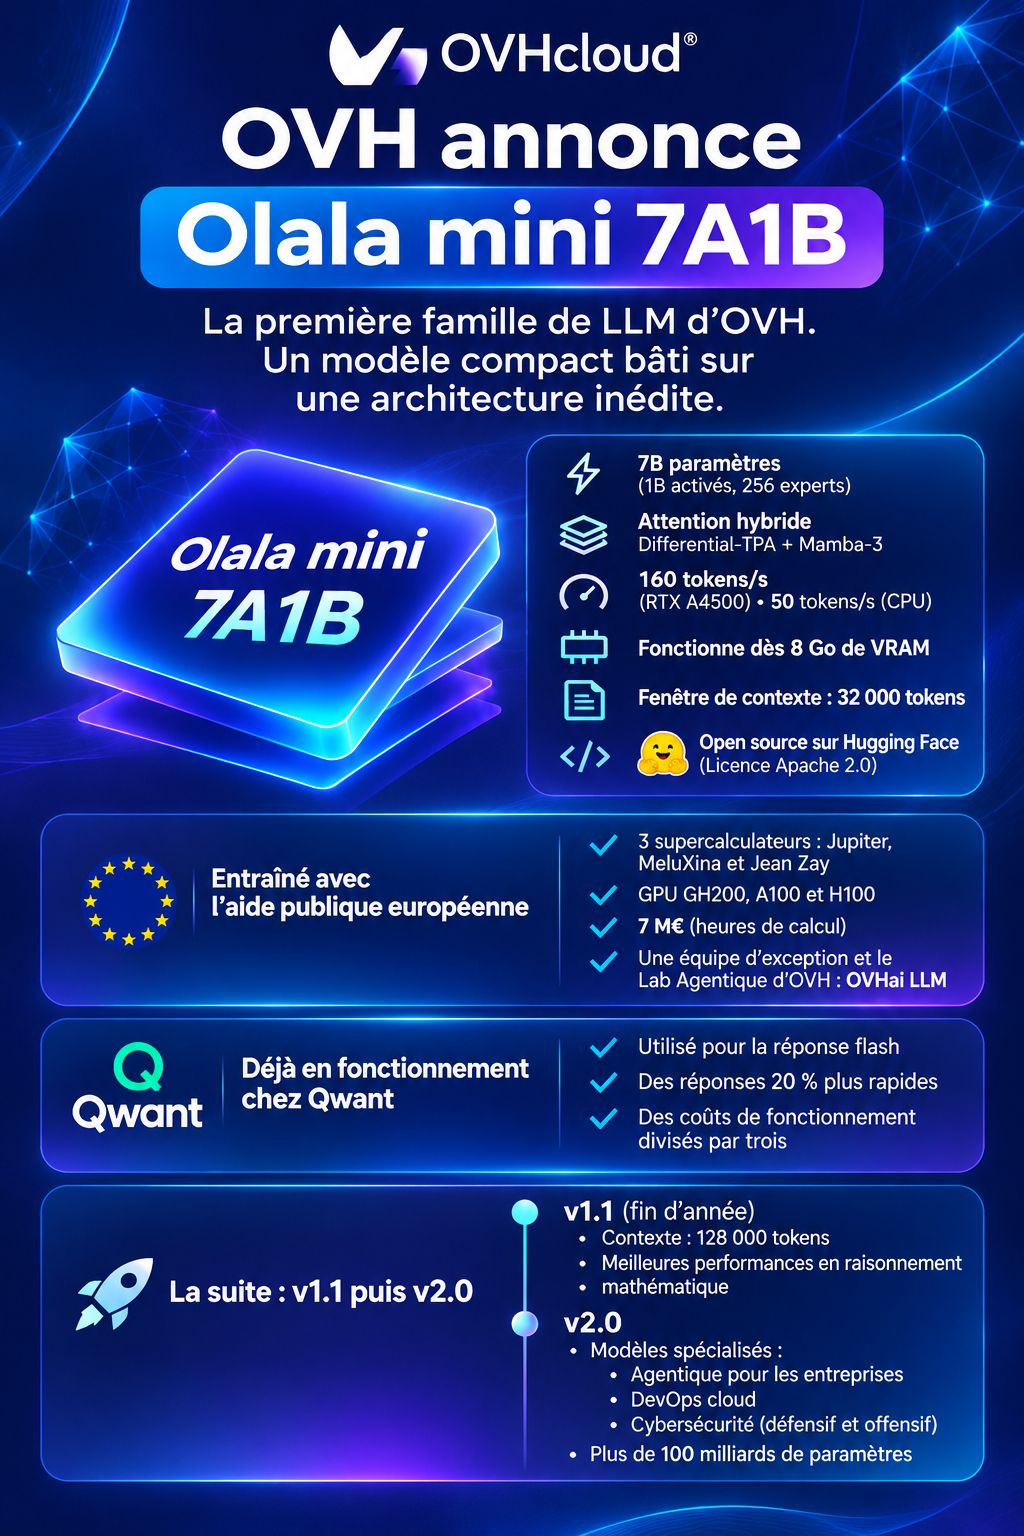
O nome lê-se como uma ficha técnica: 7 mil milhões de parâmetros no total, dos quais 1 milhão está ativado em cada pedido, distribuídos por 256 especialistas por camada. Por outras palavras, o Olala mini é um modelo de mistura de especialistas, onde apenas uma fração da rede trabalha num determinado texto. A OVHcloud vê nele um modelo mais rápido e menos exigente em memória.
A atenção é híbrida, com Differential-TPA e Mamba-3, e o modelo sai no formato BF16. Segundo a Next, o primeiro bloco reduz a memória necessária para a inferência e concentra a atenção nas informações úteis. As camadas Mamba-3, por sua vez, trabalham num resumo de tamanho constante, enquanto a atenção clássica vê a sua memória aumentar com a conversa. A OVHcloud fala de uma arquitetura « inédita », mas ainda se ignora como estes blocos se articulam.
Olala mini em 8 GB ou num simples processador: débitos anunciados, nenhuma pontuação
Em termos de velocidade, a OVHcloud anuncia 160 tokens por segundo numa RTX A4500 e 50 tokens por segundo num simples processador, com uma janela de contexto de 32 000 tokens. Estes números vêm do grupo, não de um teste independente.
O comunicado não publica, no entanto, nenhum resultado de benchmark. Sabe-se, portanto, a que velocidade o Olala mini escreve. Mas qual o valor das suas respostas?
Outro ponto a esclarecer: a memória. Sete mil milhões de parâmetros em BF16 (a dois bytes cada) pesam cerca de 14 GB, quase o dobro dos 8 GB anunciados, e o comunicado não explica como a diferença é colmatada. A RTX A4500 é aliás uma placa profissional de 20 GB, o que significa que os 160 tokens por segundo não foram medidos numa placa de 8 GB. Se contava fazer funcionar o Olala mini no seu PC, este número de 8 GB é o primeiro a verificar.
Resta a janela de 32 000 tokens, que a Next considera mais adequada para respostas rápidas do que para pedidos complexos. A OVHcloud promete 128 000 tokens com a versão 1.1.
Qwant já utiliza Olala mini: respostas 20% mais rápidas, segundo a OVHcloud
A OVHcloud afirma que a Qwant já adotou o Olala mini para a sua função de resposta flash: respostas 20% mais rápidas e custos operacionais divididos por três, em comparação com o modelo anteriormente utilizado. Segundo a Next, a Qwant baseava-se até agora em modelos da Mistral.
Este retorno de experiência continua a ser uma declaração da OVHcloud, não uma medição independente. E o contexto pesa: a Qwant pertence a uma sociedade co-detida pela família Klaba e pela Caisse des dépôts.
Olala mini: 7 M€ de cálculo público, depois mais de 100 mil milhões de parâmetros na v2.0
O Olala mini foi treinado no Jupiter, MeluXina e Jean Zay, três supercomputadores públicos europeus equipados com GPU GH200, A100 e H100. A OVHcloud quantifica este apoio no equivalente a 7 milhões de euros em horas de cálculo, agradece às autoridades públicas e diz que fez emergir uma equipa de exceção, que se tornou o Lab Agentique da OVH: OVHai LLM.
Os meios humanos permanecem modestos: menos de uma centena de pessoas trabalha em IA na OVHcloud, contra mais de 1 000 na Mistral, segundo a AFP. Octave Klaba diz querer « mostrar que é possível treinar um modelo com poucos meios ».
Outra nuance, sobre a etiqueta « aberto »: os pesos, o modelo base, o relatório técnico e a documentação AI Act serão publicados, mas a Next nota que o código e os dados de treino não são mencionados.
A OVHcloud anuncia a continuação em duas fases. A versão 1.1, esperada até ao final do ano, deve levar o contexto a 128 000 tokens e melhorar o raciocínio matemático. A versão 2.0, sem data, ultrapassará os 100 mil milhões de parâmetros e será desdobrada em modelos especializados: a agentique para empresas (OVHai Workspace, cuja versão encriptada exigirá modelos capazes de funcionar localmente na estação de trabalho), o DevOps cloud e a cibersegurança, defensiva e ofensiva.
Resta saber se as respostas do Olala mini se comparam com outros pequenos modelos abertos. O relatório técnico, esperado para quinta-feira, será o primeiro local para procurar a resposta…
