OVHcloud lève le voile sur Olala mini 7A1B, le premier modèle de langage de sa nouvelle famille : 7 milliards de paramètres dont 1 milliard seulement actif, annoncé pour tourner sur une carte graphique de 8 Go, voire sur un simple processeur. Les poids doivent être mis en ligne jeudi 19 novembre sous licence Apache 2.0, mais aucun score de qualité ne les accompagne pour l’instant.
OVHcloud présente Olala mini comme le premier représentant d’une famille de modèles de langage conçue en interne, dans un communiqué daté du 17 novembre, à Roubaix. Le lancement officiel a lieu jeudi 19 novembre, lors de l’OVHcloud AI Summit : ce jour-là, le groupe doit publier sur Hugging Face les poids, le modèle de base pré-entraîné, un rapport technique et une documentation de conformité à l’AI Act. Octave Klaba, PDG d’OVHcloud, a publié l’annonce sur X. En attendant, les chiffres disponibles sont ceux de l’entreprise.
Olala mini 7A1B : 7 milliards de paramètres, mais seulement 1 milliard actif
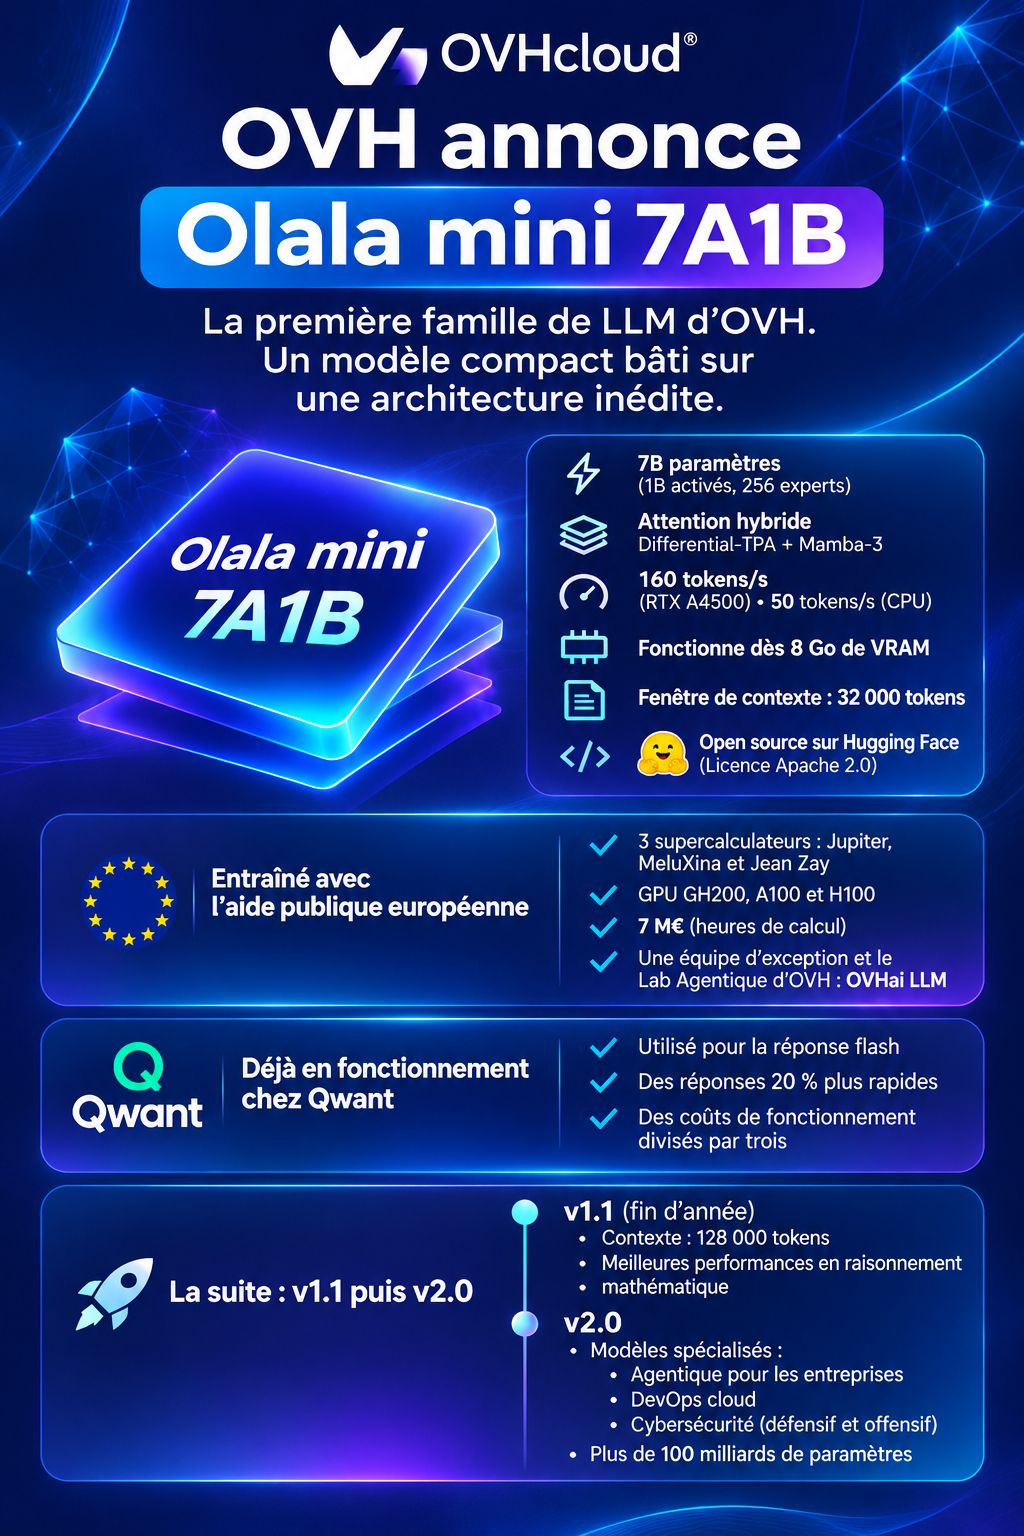
Le nom se lit comme une fiche technique : 7 milliards de paramètres au total, dont 1 milliard activé à chaque requête, répartis entre 256 experts par couche. Autrement dit, Olala mini est un modèle à mélange d’experts, où seule une fraction du réseau travaille sur un texte donné. OVHcloud y voit un modèle plus rapide et moins gourmand en mémoire.
L’attention est hybride, avec Differential-TPA et Mamba-3, et le modèle sort au format BF16. Selon Next, la première brique réduit la mémoire nécessaire à l’inférence et concentre l’attention sur les informations utiles. Les couches Mamba-3, elles, travaillent sur un résumé de taille constante, alors que l’attention classique voit sa mémoire grossir avec la conversation. OVHcloud parle d’une architecture « inédite », mais on ignore encore comment ces briques s’assemblent.
Olala mini sur 8 Go ou sur un simple processeur : des débits annoncés, aucun score
Côté vitesse, OVHcloud annonce 160 tokens par seconde sur une RTX A4500 et 50 tokens par seconde sur un simple processeur, avec une fenêtre de contexte de 32 000 tokens. Ces chiffres viennent du groupe, pas d’un banc d’essai indépendant.
Le communiqué ne publie en revanche aucun résultat de benchmark. On sait donc à quelle vitesse Olala mini écrit. Mais que valent ses réponses ?
Autre point à éclaircir : la mémoire. Sept milliards de paramètres en BF16 (à deux octets chacun) pèsent environ 14 Go, presque le double des 8 Go annoncés, et le communiqué n’explique pas comment l’écart se comble. La RTX A4500 est d’ailleurs une carte professionnelle de 20 Go, ce qui veut dire que les 160 tokens par seconde n’ont pas été mesurés sur une carte de 8 Go. Si vous comptiez faire tourner Olala mini sur votre PC, ce chiffre de 8 Go est celui à vérifier en premier.
Reste la fenêtre de 32 000 tokens, que Next juge plus adaptée aux réponses rapides qu’aux requêtes complexes. OVHcloud promet 128 000 tokens avec la version 1.1.
Qwant utilise déjà Olala mini : réponses 20 % plus rapides, d’après OVHcloud
OVHcloud affirme que Qwant a déjà adopté Olala mini pour sa fonction de réponse flash : des réponses 20 % plus rapides et des coûts de fonctionnement divisés par trois, par rapport au modèle précédemment utilisé. D’après Next, Qwant s’appuyait jusqu’ici sur des modèles de Mistral.
Ce retour d’expérience reste une déclaration d’OVHcloud, pas une mesure indépendante. Et le contexte pèse : Qwant appartient à une société codétenue par la famille Klaba et la Caisse des dépôts.
Olala mini : 7 M€ de calcul public, puis plus de 100 milliards de paramètres en v2.0
Olala mini a été entraîné sur Jupiter, MeluXina et Jean Zay, trois supercalculateurs publics européens équipés de GPU GH200, A100 et H100. OVHcloud chiffre ce soutien à l’équivalent de 7 millions d’euros d’heures de calcul, en remercie les pouvoirs publics et dit qu’il a fait émerger une équipe d’exception, devenue le Lab Agentique d’OVH : OVHai LLM.
Les moyens humains restent modestes : moins d’une centaine de personnes travaillent sur l’IA chez OVHcloud, contre plus de 1 000 chez Mistral, selon l’AFP. Octave Klaba dit vouloir « montrer qu’il est possible d’entraîner un modèle avec peu de moyens ».
Autre nuance, sur l’étiquette « ouvert » : les poids, le modèle de base, le rapport technique et la documentation AI Act seront publiés, mais Next relève que le code et les données d’entraînement ne sont pas mentionnés.
OVHcloud annonce la suite en deux temps. La version 1.1, attendue d’ici la fin de l’année, doit porter le contexte à 128 000 tokens et améliorer le raisonnement mathématique. La version 2.0, sans date, dépassera les 100 milliards de paramètres et se déclinera en modèles spécialisés : l’agentique pour les entreprises (OVHai Workspace, dont la version chiffrée nécessitera des modèles capables de tourner en local sur le poste de travail), le DevOps cloud et la cybersécurité, défensive comme offensive.
Reste à savoir si les réponses d’Olala mini tiennent la comparaison avec les autres petits modèles ouverts. Le rapport technique, attendu jeudi, sera le premier endroit où chercher la réponse…
