OVHcloud svela Olala mini 7A1B, il primo modello linguistico della sua nuova famiglia: 7 miliardi di parametri di cui solo 1 miliardo attivo, annunciato per funzionare su una scheda grafica da 8 GB, persino su una semplice CPU. I pesi saranno pubblicati giovedì 19 novembre con licenza Apache 2.0, ma al momento non sono accompagnati da alcun punteggio di qualità.
OVHcloud presenta Olala mini come il primo rappresentante di una famiglia di modelli linguistici progettata internamente, in un comunicato stampa datato 17 novembre, a Roubaix. Il lancio ufficiale avviene giovedì 19 novembre, durante l’OVHcloud AI Summit: quel giorno, il gruppo pubblicherà su Hugging Face i pesi, il modello base pre-addestrato, un rapporto tecnico e una documentazione di conformità all’AI Act. Octave Klaba, CEO di OVHcloud, ha pubblicato l’annuncio su X. Nel frattempo, i dati disponibili sono quelli dell’azienda.
Olala mini 7A1B: 7 miliardi di parametri, ma solo 1 miliardo attivo
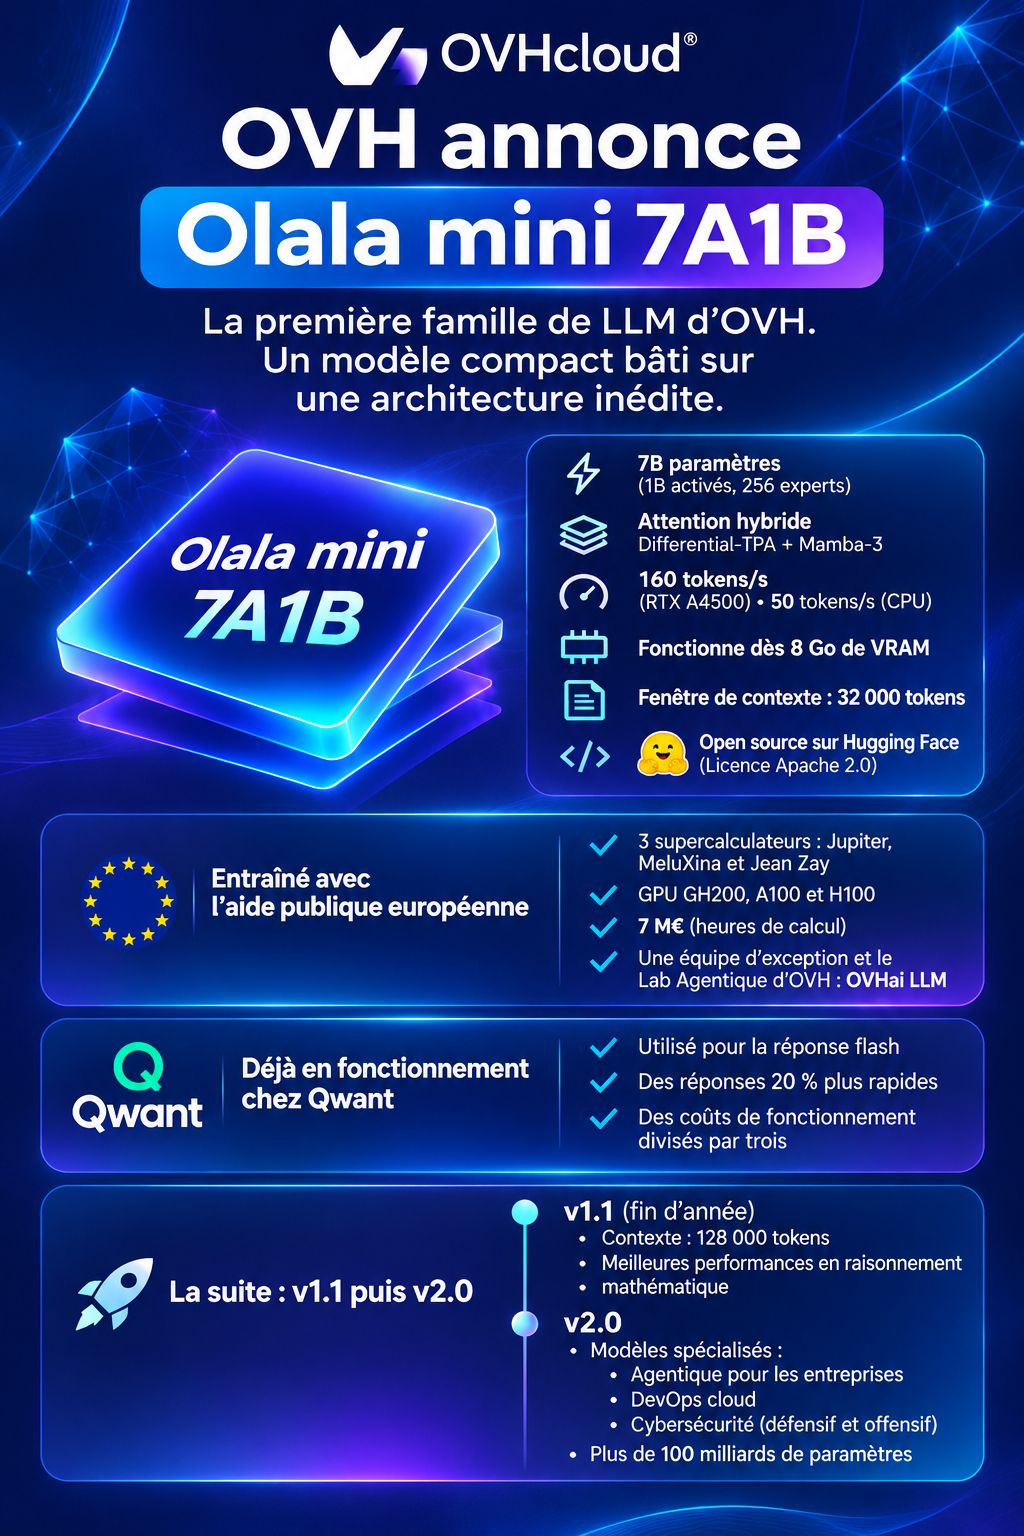
Il nome si legge come una scheda tecnica: 7 miliardi di parametri totali, di cui 1 miliardo attivato per ogni richiesta, distribuiti tra 256 esperti per strato. In altre parole, Olala mini è un modello a miscela di esperti, dove solo una frazione della rete lavora su un dato testo. OVHcloud lo vede come un modello più veloce e meno avido di memoria.
L’attenzione è ibrida, con Differential-TPA e Mamba-3, e il modello esce in formato BF16. Secondo Next, il primo blocco riduce la memoria necessaria per l’inferenza e concentra l’attenzione sulle informazioni utili. Gli strati Mamba-3, invece, lavorano su un riassunto di dimensione costante, mentre l’attenzione classica vede la sua memoria crescere con la conversazione. OVHcloud parla di un’architettura « inedita », ma non si sa ancora come questi blocchi si assemblino.
Olala mini su 8 GB o su una semplice CPU: velocità annunciate, nessun punteggio
Per quanto riguarda la velocità, OVHcloud annuncia 160 token al secondo su una RTX A4500 e 50 token al secondo su una semplice CPU, con una finestra di contesto di 32.000 token. Questi dati provengono dal gruppo, non da un banco di prova indipendente.
Il comunicato non pubblica invece alcun risultato di benchmark. Quindi sappiamo a che velocità Olala mini scrive. Ma quanto valgono le sue risposte?
Altro punto da chiarire: la memoria. Sette miliardi di parametri in BF16 (a due byte ciascuno) pesano circa 14 GB, quasi il doppio degli 8 GB annunciati, e il comunicato non spiega come si colmi il divario. La RTX A4500 è del resto una scheda professionale da 20 GB, il che significa che i 160 token al secondo non sono stati misurati su una scheda da 8 GB. Se pensavate di far girare Olala mini sul vostro PC, questa cifra di 8 GB è la prima da verificare.
Resta la finestra di 32.000 token, che Next giudica più adatta alle risposte rapide che alle richieste complesse. OVHcloud promette 128.000 token con la versione 1.1.
Qwant utilizza già Olala mini: risposte 20% più veloci, secondo OVHcloud
OVHcloud afferma che Qwant ha già adottato Olala mini per la sua funzione di risposta flash: risposte 20% più veloci e costi operativi divisi per tre, rispetto al modello precedentemente utilizzato. Secondo Next, Qwant si appoggiava finora a modelli di Mistral.
Questo feedback rimane una dichiarazione di OVHcloud, non una misura indipendente. E il contesto pesa: Qwant appartiene a una società co-detentrice della famiglia Klaba e della Caisse des dépôts.
Olala mini: 7 M€ di calcolo pubblico, poi oltre 100 miliardi di parametri in v2.0
Olala mini è stato addestrato su Jupiter, MeluXina e Jean Zay, tre supercomputer pubblici europei equipaggiati con GPU GH200, A100 e H100. OVHcloud quantifica questo sostegno nell’equivalente di 7 milioni di euro di ore di calcolo, ringrazia le autorità pubbliche e dice che ha fatto emergere un team d’eccezione, diventato il Lab Agentique di OVH: OVHai LLM.
Le risorse umane rimangono modeste: meno di un centinaio di persone lavorano sull’IA presso OVHcloud, contro più di 1.000 presso Mistral, secondo l’AFP. Octave Klaba dice di voler « dimostrare che è possibile addestrare un modello con pochi mezzi ».
Altra sfumatura, sull’etichetta « aperto »: i pesi, il modello base, il rapporto tecnico e la documentazione AI Act saranno pubblicati, ma Next rileva che il codice e i dati di addestramento non sono menzionati.
OVHcloud annuncia il seguito in due tempi. La versione 1.1, attesa entro fine anno, dovrebbe portare il contesto a 128.000 token e migliorare il ragionamento matematico. La versione 2.0, senza data, supererà i 100 miliardi di parametri e si declinerà in modelli specializzati: l’agente per le aziende (OVHai Workspace, la cui versione cifrata richiederà modelli capaci di funzionare in locale sulla postazione di lavoro), il DevOps cloud e la cybersecurity, difensiva come offensiva.
Resta da sapere se le risposte di Olala mini reggono il confronto con gli altri piccoli modelli aperti. Il rapporto tecnico, atteso giovedì, sarà il primo posto dove cercare la risposta…
