OVHcloud odsłania Olala mini 7A1B, pierwszy model językowy z nowej rodziny: 7 miliardów parametrów, z czego tylko 1 miliard aktywny, zapowiadany do działania na karcie graficznej z 8 GB, a nawet na zwykłym procesorze. Wagi mają zostać udostępnione w czwartek 19 listopada na licencji Apache 2.0, ale na razie nie towarzyszą im żadne wyniki oceny jakości.
OVHcloud przedstawia Olala mini jako pierwszego przedstawiciela rodziny modeli językowych zaprojektowanych wewnętrznie, w komunikacie datowanym na 17 listopada, w Roubaix. Oficjalna premiera odbędzie się w czwartek 19 listopada podczas OVHcloud AI Summit: tego dnia grupa ma opublikować na Hugging Face wagi, wstępnie wytrenowany model bazowy, raport techniczny oraz dokumentację zgodności z AI Act. Octave Klaba, prezes OVHcloud, opublikował ogłoszenie na X. Na razie dostępne są tylko liczby podane przez firmę.
Olala mini 7A1B: 7 miliardów parametrów, ale tylko 1 miliard aktywny
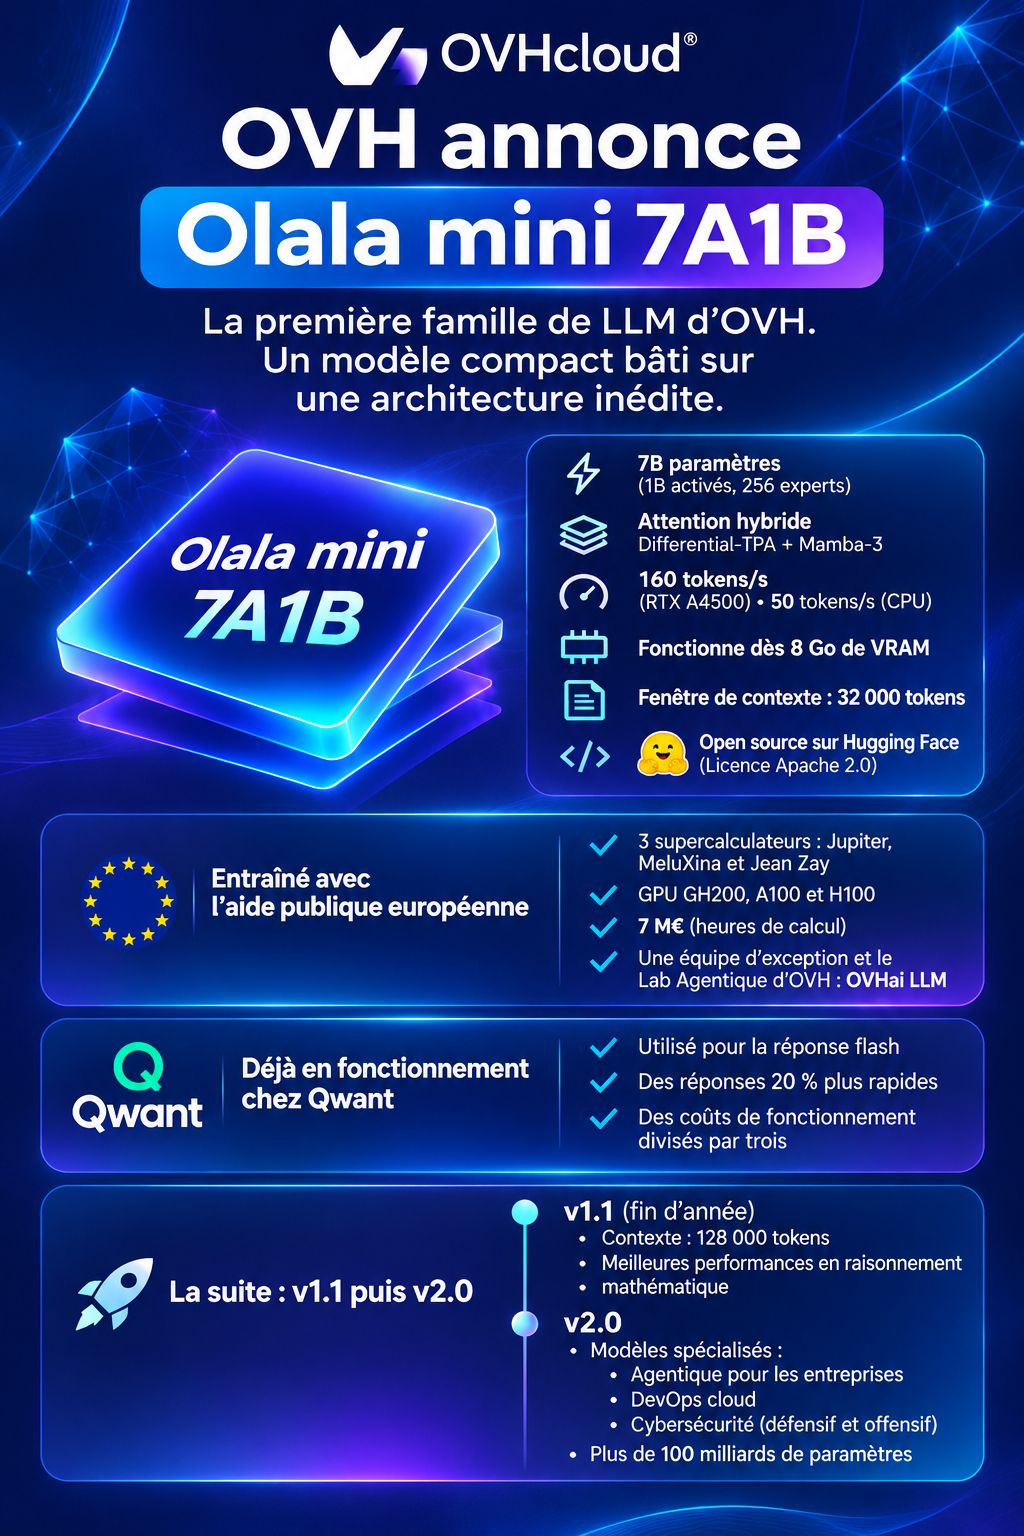
Nazwa czyta się jak specyfikacja techniczna: 7 miliardów parametrów w sumie, z czego 1 miliard aktywowany przy każdym zapytaniu, rozdzielonych między 256 ekspertów na warstwę. Innymi słowy, Olala mini jest modelem typu mixture of experts, gdzie tylko część sieci pracuje nad danym tekstem. OVHcloud widzi w tym szybszy i mniej pamięciochłonny model.
Mechanizm uwagi jest hybrydowy, z Differential-TPA i Mamba-3, a model jest udostępniany w formacie BF16. Według Next pierwszy komponent zmniejsza pamięć potrzebną do inferencji i skupia uwagę na użytecznych informacjach. Warstwy Mamba-3 pracują na stałym rozmiarze podsumowania, podczas gdy klasyczna uwaga wymaga rosnącej pamięci wraz z długością konwersacji. OVHcloud mówi o « nowatorskiej » architekturze, ale nie wiadomo jeszcze, jak te komponenty są ze sobą połączone.
Olala mini na 8 GB lub na zwykłym procesorze: deklarowane szybkości, brak wyników
Jeśli chodzi o szybkość, OVHcloud deklaruje 160 tokenów na sekundę na RTX A4500 i 50 tokenów na sekundę na zwykłym procesorze, z oknem kontekstu 32 000 tokenów. Te liczby pochodzą od grupy, a nie z niezależnych testów.
Komunikat nie zawiera jednak żadnych wyników benchmarków. Wiemy więc, jak szybko Olala mini pisze. Ale jakiej jakości są jego odpowiedzi?
Kolejna kwestia do wyjaśnienia: pamięć. Siedem miliardów parametrów w BF16 (po dwa bajty każdy) waży około 14 GB, prawie dwa razy więcej niż deklarowane 8 GB, a komunikat nie wyjaśnia, jak wypełnić tę lukę. RTX A4500 to zresztą profesjonalna karta z 20 GB, co oznacza, że 160 tokenów na sekundę nie było mierzone na karcie z 8 GB. Jeśli planujesz uruchomić Olala mini na swoim PC, to właśnie tę liczbę 8 GB należy najpierw zweryfikować.
Pozostaje okno 32 000 tokenów, które według Next jest lepiej dostosowane do szybkich odpowiedzi niż do złożonych zapytań. OVHcloud obiecuje 128 000 tokenów w wersji 1.1.
Qwant już używa Olala mini: odpowiedzi o 20% szybsze, według OVHcloud
OVHcloud twierdzi, że Qwant już przyjął Olala mini dla swojej funkcji szybkiej odpowiedzi: odpowiedzi o 20% szybsze i koszty operacyjne trzykrotnie niższe w porównaniu z poprzednio używanym modelem. Według Next, Qwant do tej pory opierał się na modelach Mistral.
To doświadczenie pozostaje deklaracją OVHcloud, a nie niezależnym pomiarem. Kontekst ma znaczenie: Qwant należy do spółki współwłasnością rodziny Klaba i Caisse des dépôts.
Olala mini: 7 mln € publicznych mocy obliczeniowych, a potem ponad 100 miliardów parametrów w wersji 2.0
Olala mini był trenowany na Jupiterze, MeluXinie i Jean Zay, trzech europejskich superkomputerach publicznych wyposażonych w GPU GH200, A100 i H100. OVHcloud wycenia to wsparcie na ekwiwalent 7 milionów euro godzin obliczeniowych, dziękuje władzom publicznym i mówi, że pozwoliło to wyłonić wyjątkowy zespół, który stał się Lab Agentique OVH: OVHai LLM.
Środki ludzkie pozostają skromne: mniej niż setka osób pracuje nad AI w OVHcloud, w porównaniu z ponad 1000 w Mistral, według AFP. Octave Klaba mówi, że chce « pokazać, że można wytrenować model przy niewielkich środkach ».
Kolejny niuans dotyczący etykiety « otwarty »: wagi, model bazowy, raport techniczny i dokumentacja AI Act zostaną opublikowane, ale Next zauważa, że kod i dane treningowe nie są wymienione.
OVHcloud zapowiada kontynuację w dwóch etapach. Wersja 1.1, oczekiwana do końca roku, ma zwiększyć kontekst do 128 000 tokenów i poprawić rozumowanie matematyczne. Wersja 2.0, bez daty, przekroczy 100 miliardów parametrów i będzie dostępna w wyspecjalizowanych wariantach: agentic dla firm (OVHai Workspace, którego zaszyfrowana wersja będzie wymagała modeli zdolnych do działania lokalnie na stanowisku pracy), DevOps w chmurze oraz cyberbezpieczeństwo, zarówno defensywne, jak i ofensywne.
Pozostaje pytanie, czy odpowiedzi Olala mini wytrzymają porównanie z innymi małymi, otwartymi modelami. Raport techniczny, oczekiwany w czwartek, będzie pierwszym miejscem, gdzie należy szukać odpowiedzi…
