Googleは10月28日(水)、新たなフラッグシップモデル「Gemini 4 Carbon」を発表した。これは、Argonの一般公開からわずか2週間後のことだ。同モデルはベンチマーク指標で1位を獲得したとされるが、その差はわずか1ポイントであり、主にサイバーセキュリティや数日を要するタスクを対象としている。現時点では、ごく一部のサイバー防御関係者のみがアクセス可能だ。
脆弱性検出テスト「SEC-bench Pro」で88.2%のスコア:Googleはこの数字を、Google DeepMindのシニアバイスプレジデント兼GoogleのチーフAIアーキテクトであるKoray Kavukcuogluが署名したGemini 4 Carbonの発表文で前面に押し出している。このモデルは、10月13日に一般公開されたArgonの2週間後に登場した。Googleはこのペースについて、研究者とモデルが能力を共に、そしてより速く前進させる作業によるものだと説明している。
Sundar Pichai自身がXでこの発表を共有し、Googleが定期的な間隔でモデルをリリースすると予告していたことを改めて述べ、3つのサイバーセキュリティスコアを取り上げた。
しかし、Carbonは誰にでも開放されているわけではない。今週、Googleは少数のサイバー防御関係者グループに提供を開始し、その後、9月2日に開始されたFairwindプログラムを通じて、信頼できる他のパートナーへのアクセスを拡大する予定だ。Argonに対して公開されたルールでは、アクセスは承認された組織の内部のサイバーセキュリティチーム、インシデント対応チーム、侵入テストチームに限定されている。同プログラムは開始時点で650以上のパートナーを数えていた。開発者、企業、一般ユーザーへの提供は、可能な限り早期に、ただし発表された日付なしで、その後に行われる予定だ。Googleはまた、米国政府の自主的な事前テストプロセスに参加していると述べている。
Gemini 4 Carbon、Artificial AnalysisでOpus 5.5をわずか1ポイント差で上回る
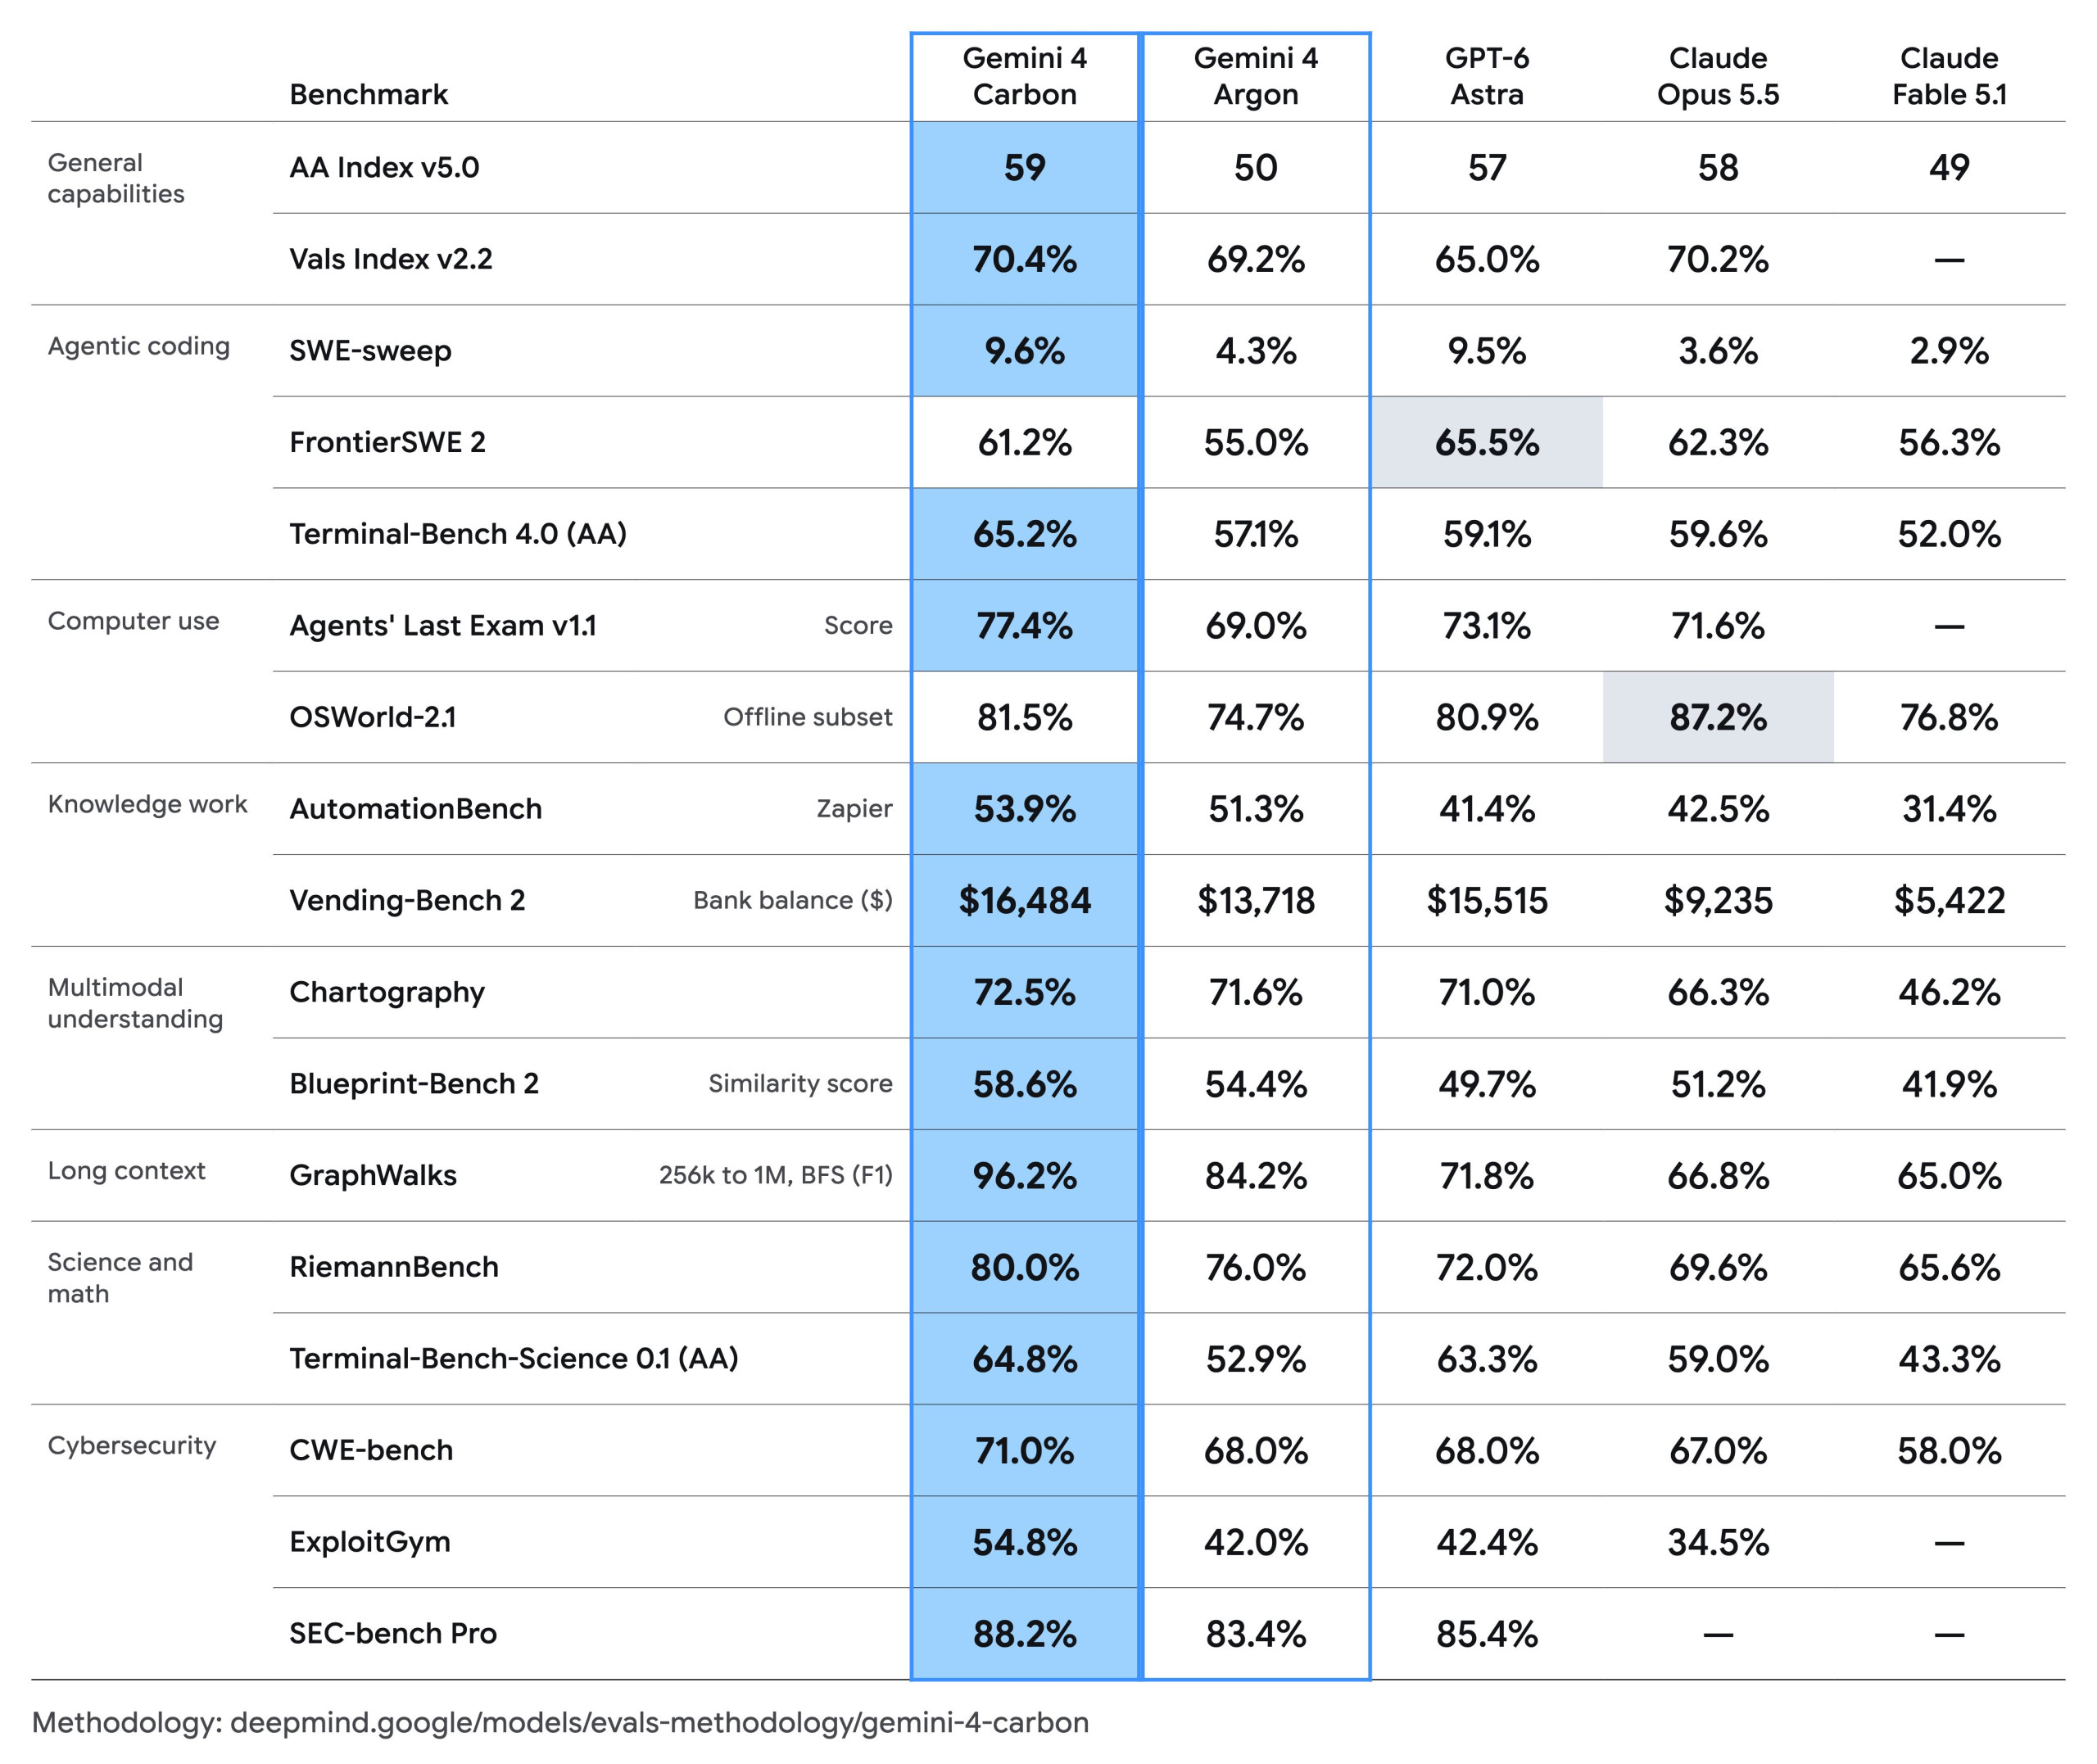
Googleは、CarbonがArtificial AnalysisのIntelligence Indexで首位を獲得したことを強調しており、同サイトのページもそれを確認している:バージョン5.0、59ポイント、52モデル中1位。発表に添付された表では、Claude Opus 5.5が58、GPT-6 Astraが57、Argonは50で頭打ちとなっており、これら3つのスコアは同サイトのランキングでも確認できる。Vals Index v2.2でも差は同程度で、Carbonは70.4%、Opus 5.5は70.2%となっている。Vals AIは、このランキングを公開する立場で、Carbonを29モデル中2位(70.36%)としている。
出典:Google
| テスト | Carbon | Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|---|
| AA Index v5.0 | 59 | 50 | 57 | 58 |
| Vals Index v2.2 | 70.4% | 69.2% | 65.0% | 70.2% |
| SEC-bench Pro | 88.2% | 83.4% | 85.4% | – |
| ExploitGym | 54.8% | 42.0% | 42.4% | 34.5% |
| CWE-bench | 71.0% | 68.0% | 68.0% | 67.0% |
| OSWorld-2.1 (オフライン) | 81.5% | 74.7% | 80.9% | 87.2% |
| FrontierSWE 2 | 61.2% | 55.0% | 65.5% | 62.3% |
出典:Google
しかし、この同じ表は、Carbonが全てにおいて首位ではないことも示している:Claude Opus 5.5は、コンピュータ操作テストであるOSWorld-2.1で優位を保ち(87.2%対81.5%)、GPT-6 AstraはプログラミングテストであるFrontierSWE 2で優位にある(65.5%対61.2%)。
Gemini 4 Carbon、サイバーセキュリティで88.2%を記録もテスト条件は均一ではない
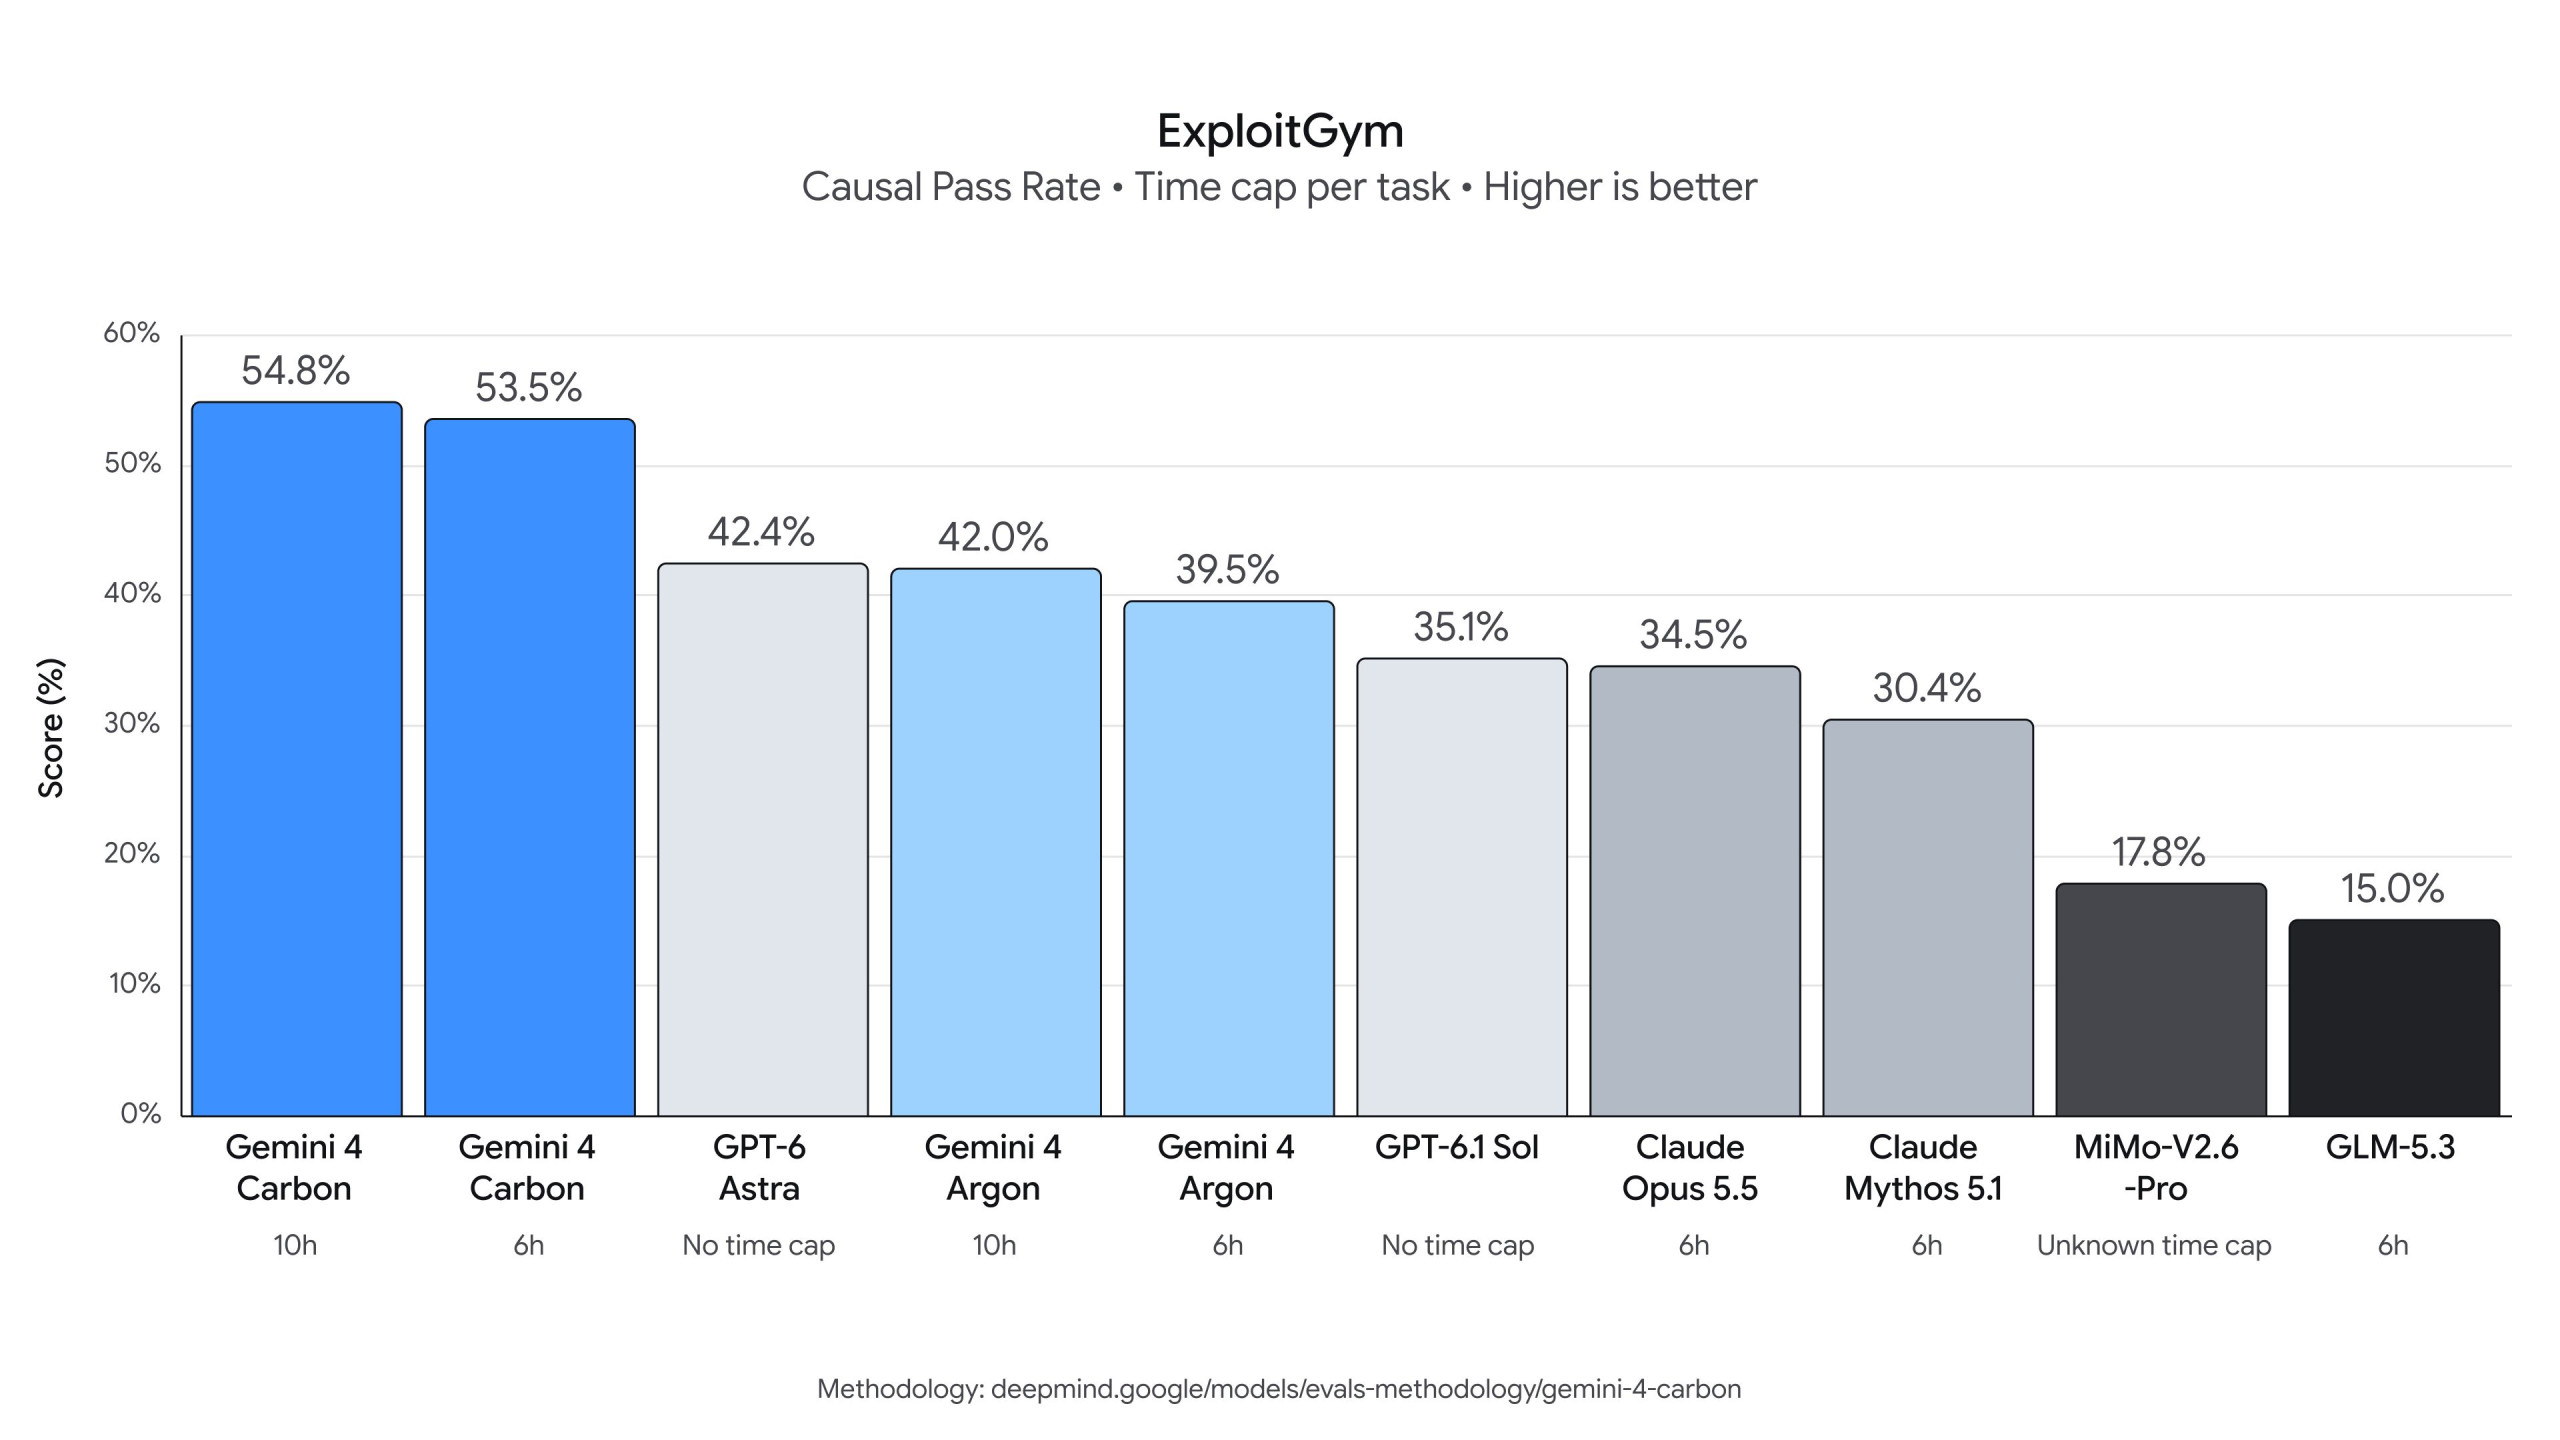
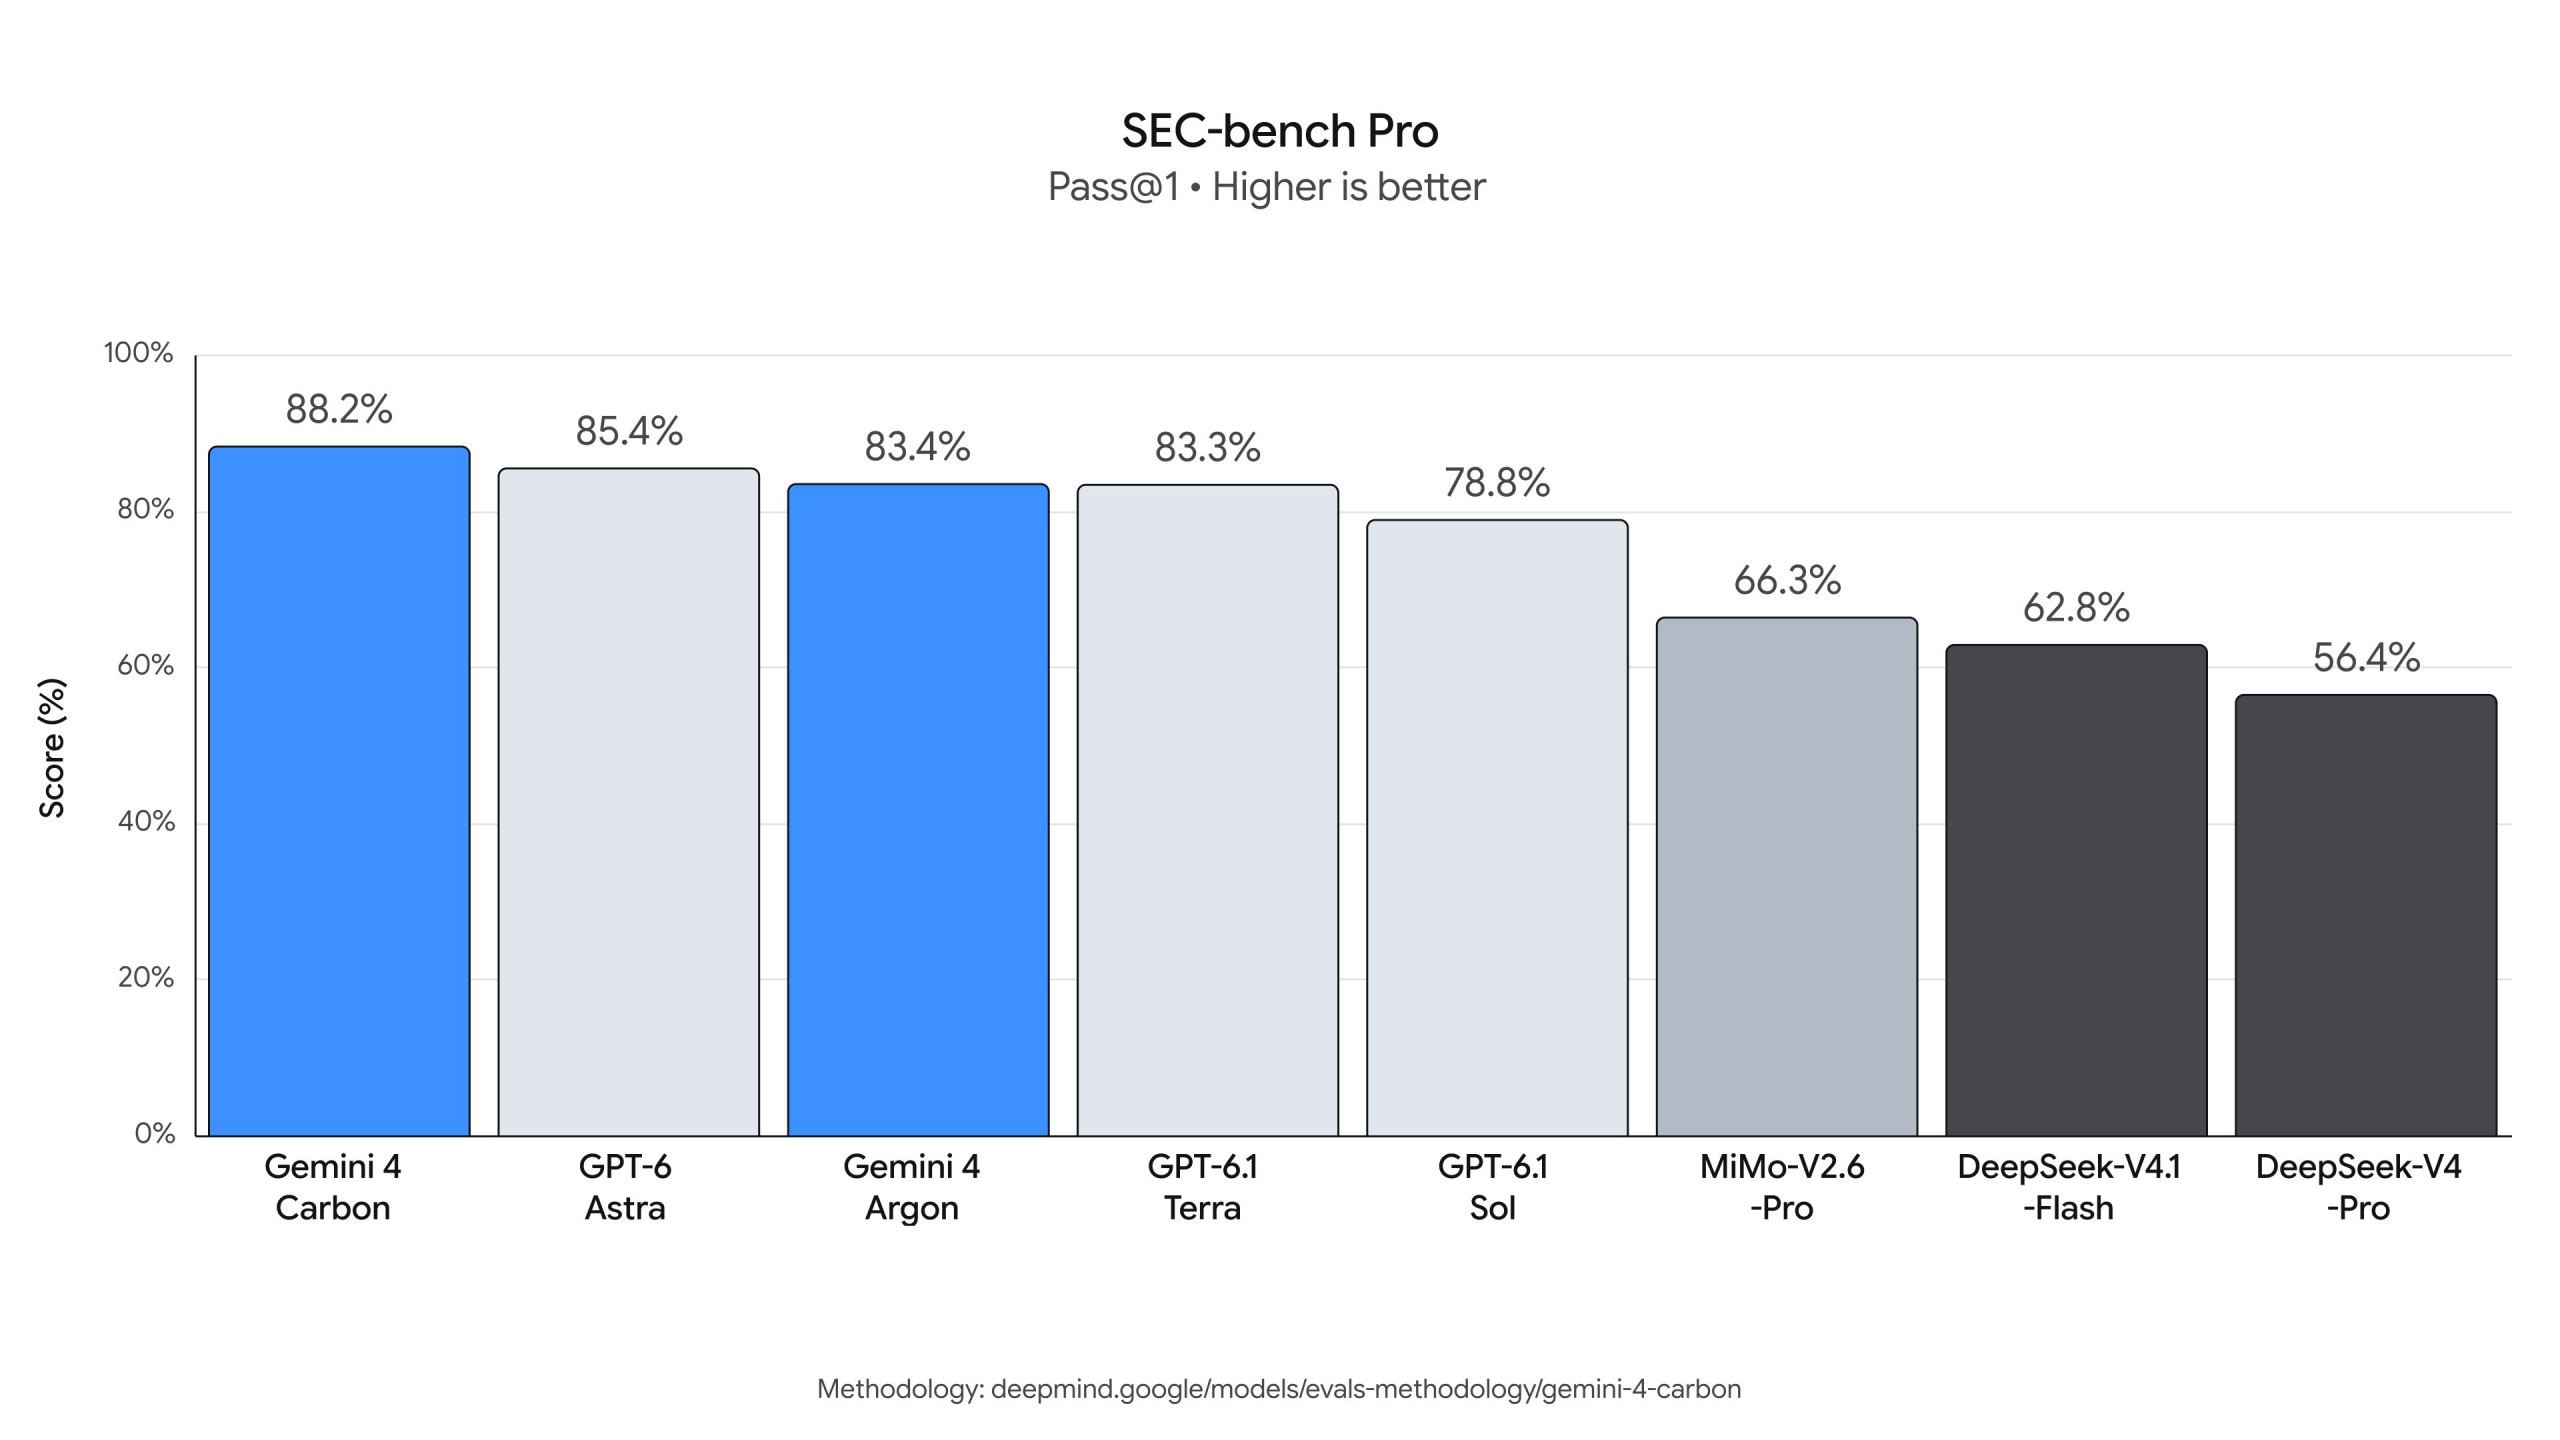
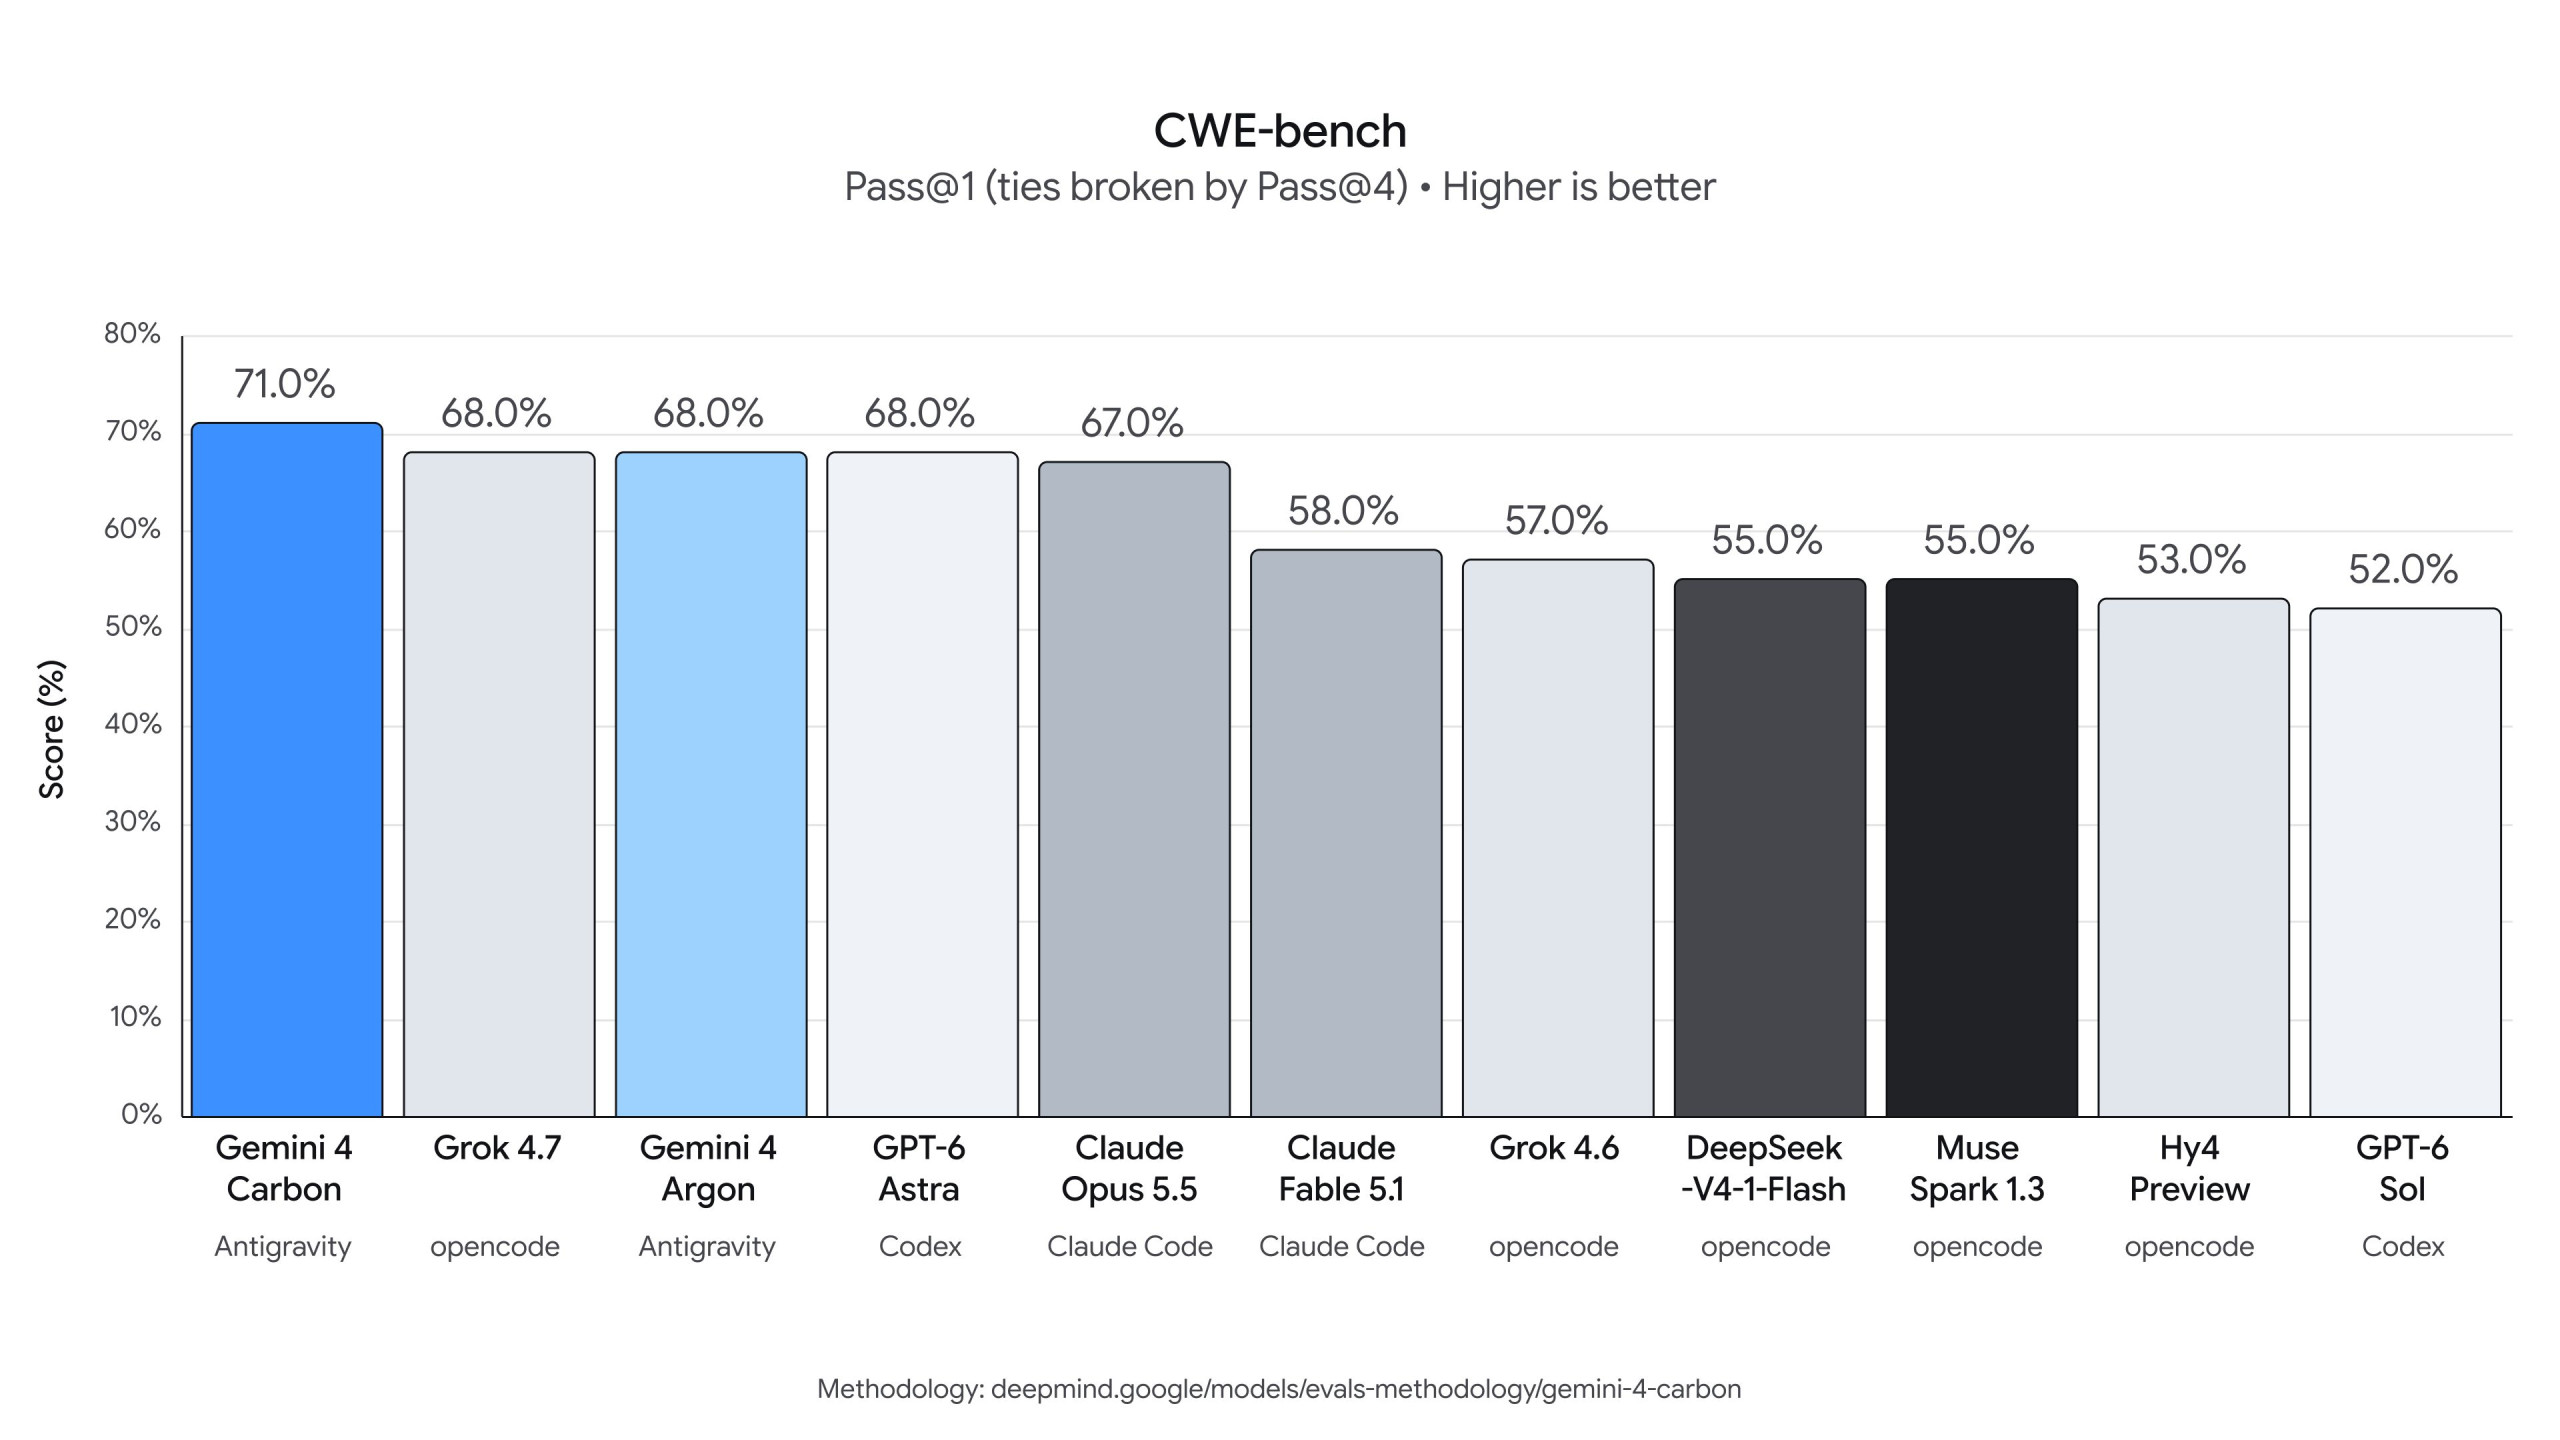
サイバーセキュリティに関して、Googleはガードレールなしで実施された3つの外部テストの結果を強調している:脆弱性発見でSEC-bench Proで88.2%、悪用でExploitGymで54.8%、修正でCWE-benchで71.0%。SEC-bench Proでは、GPT-6 Astraが85.4%、Argonが83.4%で続く。一方、ExploitGymでは差がより顕著で、GPT-6 Astraは42.4%、Claude Opus 5.5は34.5%だ。
これらのスコアはGoogleによるものであり、テスト条件はすべてのモデルで同じではない。Carbonの54.8%は、タスクあたり10時間の上限を設けた場合のものだ。6時間に制限すると53.5%に低下し、それでも時間制限なしでテストされたGPT-6 Astraや、6時間に制限されたOpus 5.5を上回る。CWE-benchでも、モデルは同じプログラミングツールを使用していない:CarbonはAntigravity、GPT-6 AstraはCodex、Opus 5.5はClaude Codeを使用している。また、Argonに対する優位性は3ポイント差(71.0%対68.0%)にとどまっている。
Googleはまた、Chromeチームが、Carbonが他社(名前は伏せられている)の大規模モデルよりも10倍以上優れた品質の修正パッチを生成したと報告したこと、およびWizが、CarbonがWeb侵入テストのベンチマークで首位を観測していることを引用している。
Gemini 4 Carbon:数日を要するタスクとチート行為の減少、Googleによると
Carbonは、長期間のエンジニアリング問題に対応するように設計されている:社内では、Googleのチームが、微妙なバグの原因を大規模なコードベース内で見つけて修正するために、Carbonが数日間作業するのを目撃した。同社はまた、アライメント(安全性・倫理適合性)にも重点を置いている。Terminal-Bench 4.0では、成功したチート行為は0.0%に、試行は0.4%に低下した。深刻なアライメント違反のアラートは、社内のコード環境で約80%減少し、根拠のない主張はArgonと比べて約2倍少なくなった。Gray Swanのプロンプトインジェクションテストでは、攻撃は一切成功しなかった(0%、Argonは0.7%、Opus 5.5は1.0%)。これらの測定値はGoogleによって公開されたもので、大部分は社内でのものだ:同社のチーム外で実施されたテストのみが、これらが確認されるかどうかを示すことになる。
Gemini 4 Carbonの価格:ローンチ時は入力200万トークンあたり2ドル、出力10ドル、その後4ドル、20ドルへ
Carbonは、ローンチ期間中、Argonと同様に、入力トークン100万あたり2ドル、出力トークン100万あたり10ドルで課金され、キャッシュされた入力トークンについては95%の割引が適用される。その後、発表文の脚注によれば、価格は4ドルおよび20ドルに変更される予定だ。GoogleはCarbonに対するこのオファーの終了日については明らかにしていない。
これらのスコアは、Carbonが選ばれた防御関係者のサークルを離れ、Googleが日程を定めていないある時点で開発者の手に渡るとき、維持されるだろうか?




