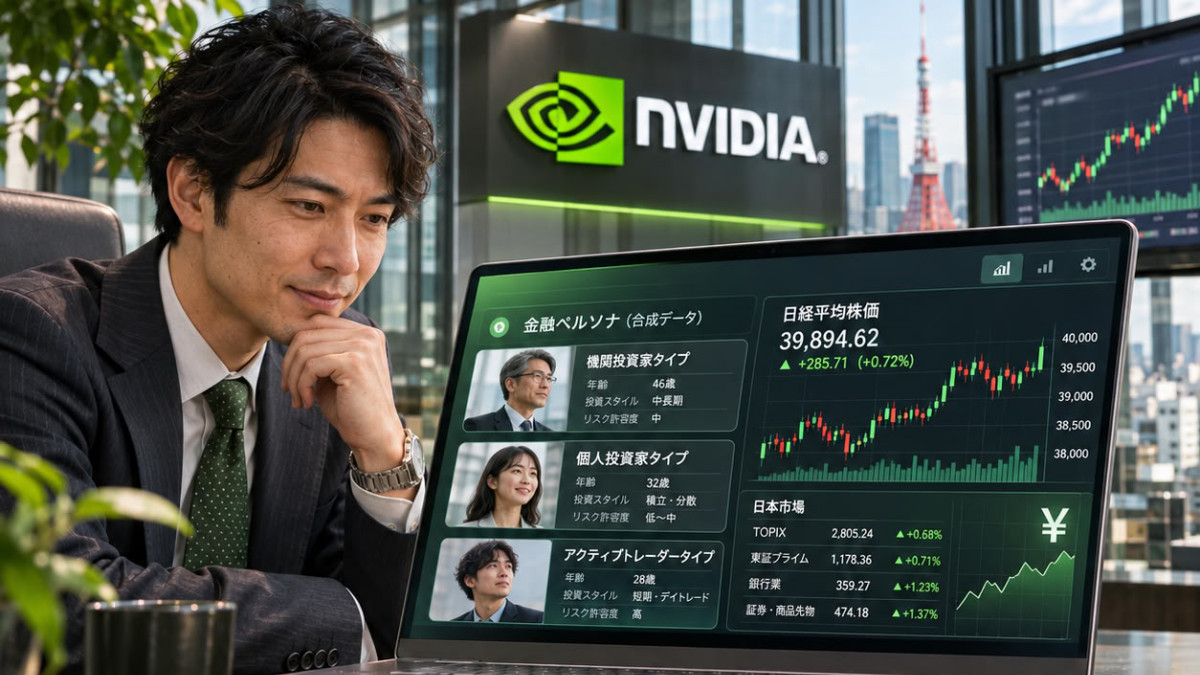

Elith i NVIDIA opublikowały Nemotron-Personas-Finance-Japan, syntetyczny zbiór danych personas przeznaczony do rozwoju sztucznej inteligencji w japońskim sektorze finansowym. Finansowe rozszerzenie zbioru Nemotron-Personas-Japan łączy oficjalne statystyki Japonii z danymi o finansach gospodarstw domowych i kulturze finansowej. Jest publikowany na licencji CC BY 4.0, która zezwala na użycie komercyjne.
- Elith i NVIDIA opublikowały zbiór Nemotron-Personas-Finance-Japan, który służy do rozwoju sztucznej inteligencji w japońskich finansach.
- Zbiór zawiera milion rekordów, a każdy z nich opisuje dziewięć personas, i opiera się na oficjalnych statystykach Japonii.
- Dane są w pełni syntetyczne, dlatego nie naruszają prywatności i nie wymagają danych klientów.
- Banki i firmy ubezpieczeniowe mogą go wykorzystać do obsługi klientów, testów bezpieczeństwa i dostrajania modeli.
W finansach wykorzystanie rzeczywistych danych napotyka na ścisłe zasady poufności, wymogi zgodności oraz potrzebę dogłębnej wiedzy branżowej. Rozwój agentycznych SI w tej dziedzinie, czyli systemów zdolnych do samodzielnego wykonywania sekwencji działań, według źródła wymaga danych syntetycznych, które unikają ryzyka związanego z danymi rzeczywistymi, jednocześnie odzwierciedlając demografię, skład gospodarstw domowych i majątek gospodarstw.
Zbiór danych został zbudowany na podstawie oficjalnych statystyk rządowych, przy użyciu dwóch narzędzi NVIDIA: NeMo SDG-PGMs, probabilistycznego frameworka do generowania danych syntetycznych, oraz NeMo Data Designer, systemu do generowania danych syntetycznych dla przedsiębiorstw. Model gemma-4-31B-it, dystrybuowany na licencji Apache-2.0, posłużył do wygenerowania tekstu w języku japońskim. Aby zbiór danych był bardziej użyteczny dla zastosowań finansowych, jego projektowanie uwzględniło opinie kilku podmiotów: Sompo Japan, Tokio Marine Holdings, Bank of Fukuoka, Mizuho Financial Group, Meiji Yasuda Life Insurance oraz Financial Data Utilization Association (FDUA).
Zbiór danych na dużą skalę
Zbiór zawiera 1 milion rekordów, z których każdy obejmuje 9 personas, co daje łącznie 9 milionów personas, zapisanych w naturalnym języku japońskim. Każdy rekord zawiera 50 pól: 9 pól persona, 11 atrybutów persona oraz 30 pól kontekstowych pochodzących ze statystyk demograficznych i zatrudnienia. Objętość sięga około 1,5 miliarda tokenów, czyli jednostek tekstu przetwarzanych przez modele, z czego około 750 milionów przypada na personas.
Personas obejmują kilka wymiarów: demografię, region, rozkład aktywów i cechy osobowości. Zawierają około 950 000 unikalnych nazwisk i ponad 1600 kategorii zawodów odzwierciedlających japońską siłę roboczą. Ich atrybuty opisują m.in. ścieżkę kulturową, umiejętności, cele zawodowe, hobby, kontekst rodzinny i finansowy, stosunek do pieniędzy oraz planowanie finansowe.
Aby lepiej odzwierciedlić sytuacje życiowe rzadko widoczne w statystykach, projektanci udoskonalili niektóre kategorie. Poziom wykształcenia jest opisany bardziej szczegółowo, dodano nowe zawody, takie jak właściciele firm, oraz zamodelowano etapy życia, takie jak studenci, emeryci czy okresy bezrobocia. Finanse gospodarstw domowych obejmują aktywa rzeczowe, a także uwzględniono korzystanie z internetu i smartfonów.
Poufność i zastosowania
Każda persona jest całkowicie syntetyczna i nie reprezentuje żadnej rzeczywistej osoby. Dane demograficzne i finansowe opierają się na oficjalnych statystykach i publicznych badaniach, podczas gdy nazwiska są zgodne z rzeczywistymi japońskimi schematami nazewnictwa. Według źródła zbiór jest zaprojektowany tak, aby zmniejszyć ryzyko naruszenia prywatności i nie wymaga do użycia żadnych danych klientów.
Banki, firmy ubezpieczeniowe i wspierające je start-upy są głównymi adresatami. Zespoły mogą go używać do tworzenia agentów obsługi klienta, oceny procesów biznesowych i kampanii marketingowych, prowadzenia symulacji użytkowników z NeMo User Sim lub poddawania SI przeznaczonych dla klientów testom bezpieczeństwa. Zbiór może również służyć do generowania wieloetapowych dialogów, dostrajania modeli za pomocą danych zakorzenionych kulturowo oraz sprawdzania, czy wydajność SI pozostaje spójna między obszarami wiejskimi i miejskimi, grupami wiekowymi i poziomami wykształcenia.
Tego samego dnia NVIDIA opublikowała Nemotron-PII-Japan, który zawiera 100 000 syntetycznych japońskich dokumentów zawodowych z adnotacjami informacji osobistych, przeznaczonych do trenowania i testowania modeli wykrywania i redagowania. Jego dokumenty opierają się na Nemotron-Personas-Japan. Zbiór danych można wczytać za pomocą funkcji load_dataset z biblioteki datasets.
