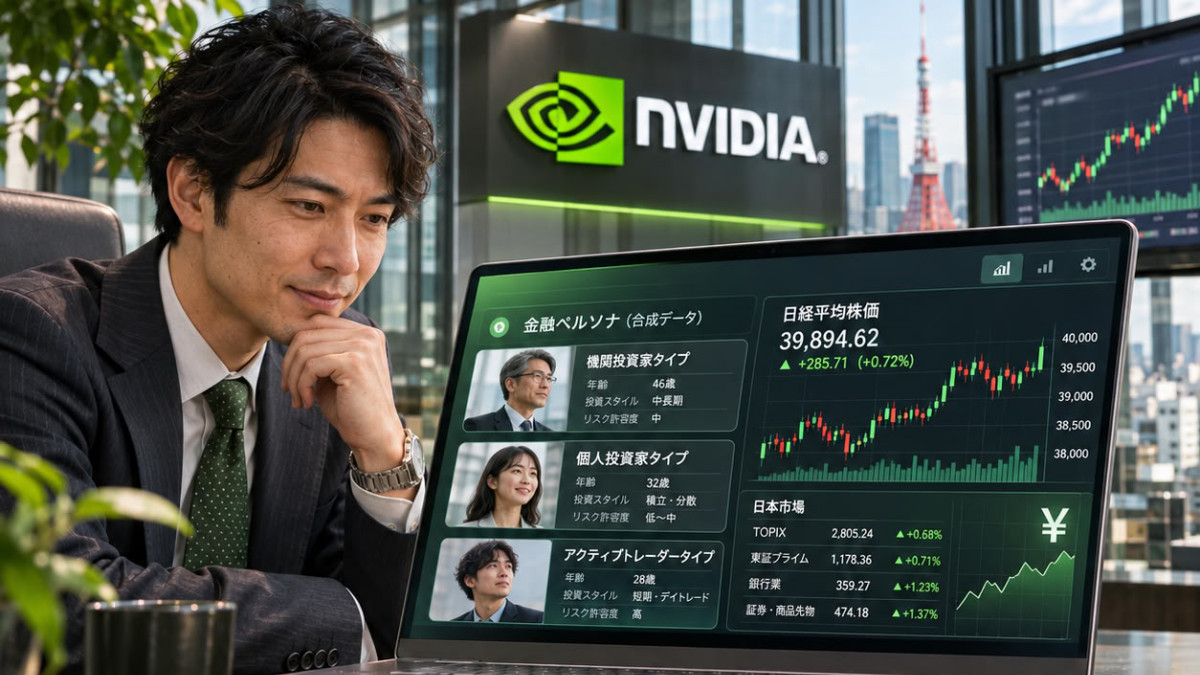

Elith e NVIDIA hanno pubblicato Nemotron-Personas-Finance-Japan, un dataset di personas sintetiche destinato allo sviluppo di intelligenze artificiali nel settore finanziario giapponese. Estensione finanziaria del dataset Nemotron-Personas-Japan, associa le statistiche ufficiali del Giappone a dati sulle finanze domestiche e la cultura finanziaria. È pubblicato con licenza CC BY 4.0, che autorizza l’uso commerciale.
Nella finanza, l’utilizzo di dati reali si scontra con regole di riservatezza rigorose, esigenze di conformità e la necessità di una profonda competenza di settore. Lo sviluppo di IA agentiche in questo ambito, ovvero sistemi capaci di concatenare azioni in modo autonomo, richiede secondo la fonte dati sintetici che evitino i rischi legati ai dati reali riflettendo al contempo la demografia, la composizione dei nuclei familiari e il patrimonio delle famiglie.
Il dataset è stato costruito a partire da statistiche governative ufficiali, con due strumenti di NVIDIA: NeMo SDG-PGMs, un framework di modellazione probabilistica per la generazione di dati sintetici, e NeMo Data Designer, un sistema di generazione di dati sintetici destinato alle aziende. Il modello gemma-4-31B-it, distribuito con licenza Apache-2.0, è stato utilizzato per generare il testo in giapponese. Per rendere il dataset più utile ai casi d’uso finanziari, la sua progettazione ha integrato i feedback di diversi attori: Sompo Japan, Tokio Marine Holdings, Bank of Fukuoka, Mizuho Financial Group, Meiji Yasuda Life Insurance e la Financial Data Utilization Association (FDUA).
Un dataset su larga scala
Il dataset conta 1 milione di record contenenti ciascuno 9 personas, per un totale di 9 milioni di personas, scritti in giapponese naturale. Ogni record contiene 50 campi: 9 campi di persona, 11 attributi di persona e 30 campi contestuali derivati dalle statistiche demografiche e occupazionali. Il volume raggiunge circa 1,5 miliardi di token, ovvero unità di testo elaborate dai modelli, di cui circa 750 milioni per le personas.
Le personas coprono diverse dimensioni: demografia, regione, distribuzione degli asset e tratti di personalità. Comprendono circa 950.000 nomi unici e oltre 1.600 categorie di professioni che riflettono la popolazione attiva giapponese. I loro attributi descrivono in particolare il percorso culturale, le competenze, gli obiettivi di carriera, gli hobby, il contesto familiare e finanziario, il rapporto con il denaro e la pianificazione finanziaria.
Per riflettere meglio situazioni di vita raramente visibili nelle statistiche, i progettisti hanno affinato alcune categorie. Il livello di istruzione è descritto in modo più dettagliato, sono state aggiunte nuove professioni come gli imprenditori, e sono state modellate fasi di vita come studenti, pensionati o periodi di disoccupazione. Le finanze domestiche includono asset reali, e l’uso di internet e dello smartphone è preso in considerazione.
Riservatezza e utilizzi
Ogni persona è interamente sintetica e non rappresenta alcuna persona reale. I dati demografici e finanziari seguono le statistiche ufficiali e le indagini pubbliche, mentre i nomi rispettano gli schemi di denominazione giapponesi reali. Secondo la fonte, il dataset è concepito per ridurre il rischio di violazione della privacy e non richiede alcun dato cliente per essere utilizzato.
Le banche, le assicurazioni e le startup che le affiancano sono i primi destinatari previsti. I team possono servirsene per creare agenti di servizio clienti, valutare procedure commerciali e campagne di marketing, condurre simulazioni di utenti con NeMo User Sim, o sottoporre IA destinate alla clientela a test di sicurezza. Il dataset può anche servire a generare dialoghi multi-turno, affinare modelli con dati culturalmente ancorati e verificare se le prestazioni di un’IA rimangano omogenee tra zone rurali e urbane, fasce d’età e livelli di istruzione.
Lo stesso giorno, NVIDIA ha pubblicato Nemotron-PII-Japan, che contiene 100.000 documenti professionali giapponesi sintetici dotati di informazioni personali annotate, destinati ad addestrare e testare modelli di rilevamento e redazione. I suoi documenti si basano su Nemotron-Personas-Japan. Il dataset si carica con la funzione load_dataset della libreria datasets.
