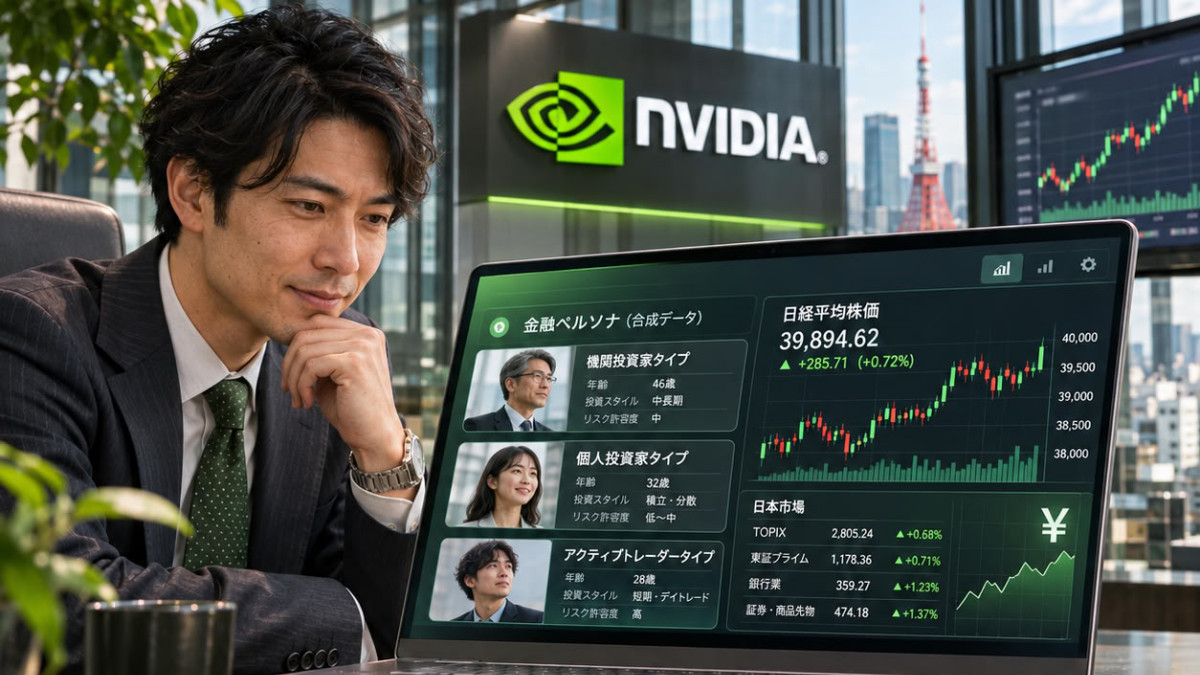

A Elith e a NVIDIA lançaram o Nemotron-Personas-Finance-Japan, um conjunto de dados de personas sintéticas destinado ao desenvolvimento de inteligências artificiais no setor financeiro japonês. Sendo uma extensão financeira do conjunto de dados Nemotron-Personas-Japan, combina as estatísticas oficiais do Japão com dados sobre as finanças dos agregados familiares e a literacia financeira. É publicado sob a licença CC BY 4.0, que autoriza o uso comercial.
- A Elith e a NVIDIA lançaram o Nemotron-Personas-Finance-Japan, um conjunto de dados sintéticos para desenvolver IA no setor financeiro japonês.
- O conjunto contém 9 milhões de personas e combina estatísticas oficiais com dados sobre finanças familiares e literacia financeira.
- As personas são totalmente sintéticas, por isso reduzem riscos de privacidade e não exigem dados de clientes.
- Bancos, seguradoras e start-ups podem usá-lo para testar agentes de atendimento, campanhas de marketing e a segurança das suas IAs.
No setor financeiro, a utilização de dados reais depara-se com regras de confidencialidade rigorosas, requisitos de conformidade e a necessidade de um profundo conhecimento do negócio. O desenvolvimento de IA agentica nesta área, ou seja, de sistemas capazes de encadear ações de forma autónoma, requer, segundo a fonte, dados sintéticos que evitem os riscos associados aos dados reais, ao mesmo tempo que refletem a demografia, a composição dos lares e o património das famílias.
O conjunto de dados foi construído a partir de estatísticas governamentais oficiais, com duas ferramentas da NVIDIA: o NeMo SDG-PGMs, uma estrutura de modelação probabilística para a geração de dados sintéticos, e o NeMo Data Designer, um sistema de geração de dados sintéticos destinado a empresas. O modelo gemma-4-31B-it, distribuído sob a licença Apache-2.0, foi utilizado para gerar o texto em japonês. Para tornar o conjunto de dados mais útil para casos de uso financeiros, o seu desenho incorporou o *feedback* de vários intervenientes: Sompo Japan, Tokio Marine Holdings, Bank of Fukuoka, Mizuho Financial Group, Meiji Yasuda Life Insurance e a Financial Data Utilization Association (FDUA).
Um conjunto de dados de grande escala
O conjunto contém 1 milhão de registos, cada um com 9 personas, totalizando 9 milhões de personas, escritas em japonês natural. Cada registo contém 50 campos: 9 campos de persona, 11 atributos de persona e 30 campos contextuais provenientes das estatísticas demográficas e de emprego. O volume atinge aproximadamente 1,5 mil milhões de *tokens*, ou seja, unidades de texto processadas pelos modelos, dos quais cerca de 750 milhões são de personas.
As personas abrangem várias dimensões: demografia, região, distribuição de ativos e traços de personalidade. Incluem cerca de 950 mil nomes únicos e mais de 1600 categorias de profissões que refletem a população ativa japonesa. Os seus atributos descrevem, nomeadamente, o percurso cultural, as competências, os objetivos de carreira, os passatempos, o contexto familiar e financeiro, a relação com o dinheiro e o planeamento financeiro.
Para refletir melhor situações de vida raramente visíveis nas estatísticas, os criadores aperfeiçoaram algumas categorias. O nível de escolaridade é descrito de forma mais detalhada, foram adicionadas novas profissões como os empresários, e foram modeladas etapas da vida como estudantes, reformados ou períodos de desemprego. As finanças dos agregados familiares incluem ativos reais, e o uso da internet e do *smartphone* é tido em conta.
Confidencialidade e utilizações
Cada persona é totalmente sintética e não representa qualquer pessoa real. Os dados demográficos e financeiros seguem as estatísticas oficiais e os inquéritos públicos, enquanto os nomes respeitam os padrões de nomenclatura japoneses reais. Segundo a fonte, o conjunto foi concebido para reduzir o risco de violação da privacidade e não requer quaisquer dados de clientes para ser utilizado.
Os bancos, as seguradoras e as *start-ups* que os apoiam são os primeiros destinatários visados. As equipas podem utilizá-lo para criar agentes de serviço ao cliente, avaliar processos comerciais e campanhas de marketing, realizar simulações de utilizadores com o NeMo User Sim, ou submeter IAs destinadas aos clientes a testes de segurança. O conjunto também pode servir para gerar diálogos multi-turno, para afinar modelos com dados culturalmente ancorados e para verificar se o desempenho de uma IA se mantém homogéneo entre zonas rurais e urbanas, faixas etárias e níveis de escolaridade.
No mesmo dia, a NVIDIA lançou o Nemotron-PII-Japan, que contém 100 mil documentos profissionais japoneses sintéticos com informações pessoais anotadas, destinados a treinar e testar modelos de deteção e ofuscação. Os seus documentos baseiam-se no Nemotron-Personas-Japan. O conjunto de dados é carregado com a função load_dataset da biblioteca datasets.
