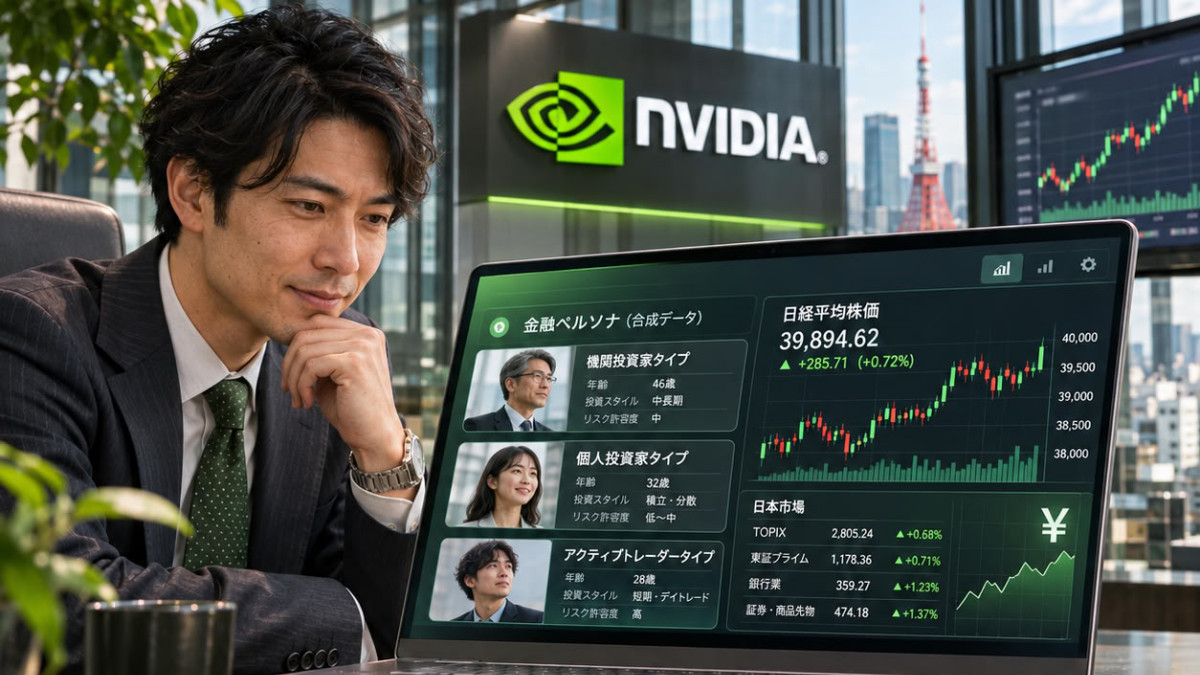

Elith y NVIDIA han publicado Nemotron-Personas-Finance-Japan, un conjunto de datos de personas sintéticas destinado al desarrollo de inteligencias artificiales en el sector financiero japonés. Extensión financiera del conjunto de datos Nemotron-Personas-Japan, combina las estadísticas oficiales de Japón con datos sobre las finanzas de los hogares y la cultura financiera. Se publica bajo la licencia CC BY 4.0, que autoriza el uso comercial.
En las finanzas, el uso de datos reales se enfrenta a normas de confidencialidad estrictas, requisitos de cumplimiento y la necesidad de un profundo conocimiento del sector. El desarrollo de IA agentivas en este ámbito, es decir, de sistemas capaces de encadenar acciones de manera autónoma, requiere según la fuente datos sintéticos que eviten los riesgos asociados a los datos reales y reflejen la demografía, la composición de los hogares y el patrimonio de las familias.
El conjunto de datos se construyó a partir de estadísticas gubernamentales oficiales, con dos herramientas de NVIDIA: NeMo SDG-PGMs, un marco de modelado probabilístico para la generación de datos sintéticos, y NeMo Data Designer, un sistema de generación de datos sintéticos para empresas. El modelo gemma-4-31B-it, distribuido bajo licencia Apache-2.0, se utilizó para generar el texto en japonés. Para hacer el conjunto de datos más útil para casos de uso financieros, su diseño incorporó los comentarios de varios actores: Sompo Japan, Tokio Marine Holdings, Bank of Fukuoka, Mizuho Financial Group, Meiji Yasuda Life Insurance y la Financial Data Utilization Association (FDUA).
Un conjunto de datos a gran escala
El conjunto cuenta con 1 millón de registros que contienen cada uno 9 personas, es decir, 9 millones de personas en total, escritas en japonés natural. Cada registro contiene 50 campos: 9 campos de persona, 11 atributos de persona y 30 campos contextuales procedentes de estadísticas demográficas y de empleo. El volumen alcanza aproximadamente 1.500 millones de tokens, es decir, unidades de texto procesadas por los modelos, de los cuales unos 750 millones corresponden a las personas.
Las personas cubren varias dimensiones: demografía, región, distribución de activos y rasgos de personalidad. Incluyen aproximadamente 950.000 nombres únicos y más de 1.600 categorías de profesiones que reflejan la población activa japonesa. Sus atributos describen, entre otros, la trayectoria cultural, las habilidades, los objetivos profesionales, los pasatiempos, el contexto familiar y financiero, la relación con el dinero y la planificación financiera.
Para reflejar mejor situaciones de vida raramente visibles en las estadísticas, los diseñadores afinaron ciertas categorías. El nivel educativo se describe con mayor detalle, se añadieron nuevas profesiones como la de empresario, y se modelaron etapas de la vida como estudiantes, jubilados o periodos de desempleo. Las finanzas de los hogares incluyen activos reales, y se tiene en cuenta el uso de internet y del teléfono inteligente.
Confidencialidad y usos
Cada persona es completamente sintética y no representa a ninguna persona real. Los datos demográficos y financieros siguen las estadísticas oficiales y las encuestas públicas, mientras que los nombres respetan los patrones de nomenclatura japoneses reales. Según la fuente, el conjunto está diseñado para reducir el riesgo de violación de la privacidad y no requiere ningún dato de cliente para ser utilizado.
Los bancos, aseguradoras y startups que los acompañan son los primeros destinatarios previstos. Los equipos pueden utilizarlo para crear agentes de servicio al cliente, evaluar procesos comerciales y campañas de marketing, realizar simulaciones de usuarios con NeMo User Sim, o someter a pruebas de seguridad a IAs destinadas a la clientela. El conjunto también puede servir para generar diálogos de múltiples turnos, afinar modelos con datos culturalmente anclados y verificar si el rendimiento de una IA se mantiene homogéneo entre zonas rurales y urbanas, grupos de edad y niveles educativos.
El mismo día, NVIDIA publicó Nemotron-PII-Japan, que contiene 100.000 documentos profesionales japoneses sintéticos con información personal anotada, destinados a entrenar y probar modelos de detección y enmascaramiento. Sus documentos se basan en Nemotron-Personas-Japan. El conjunto de datos se carga con la función load_dataset de la biblioteca datasets.
