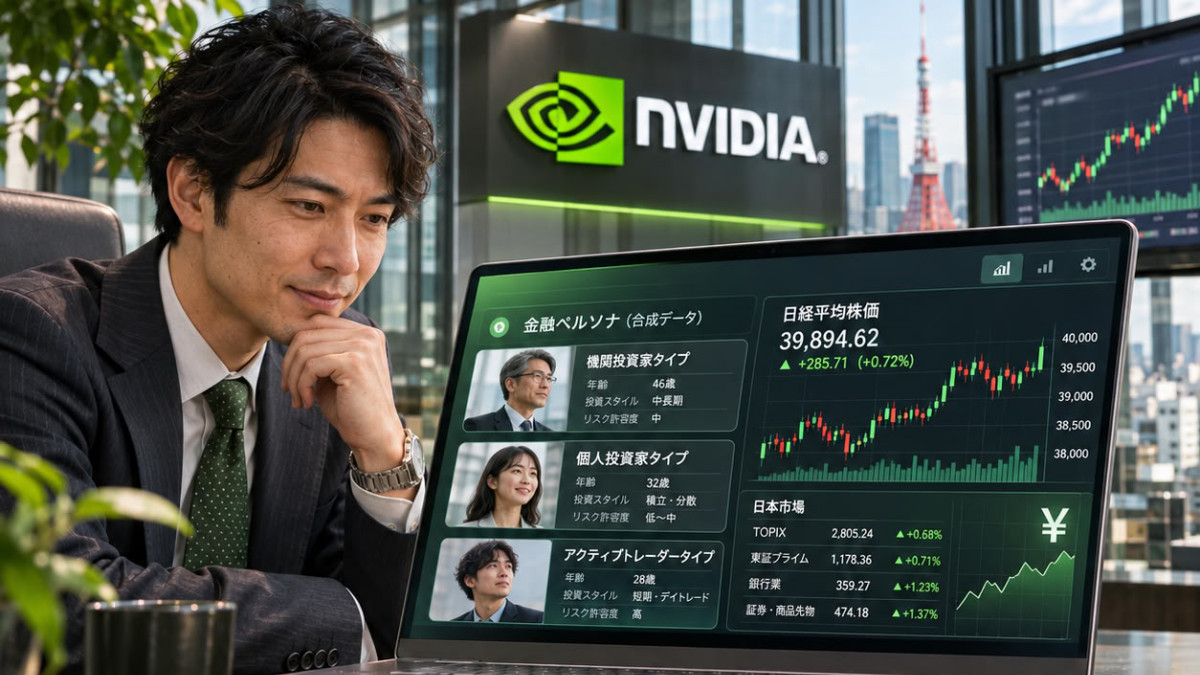

Elith und NVIDIA haben Nemotron-Personas-Finance-Japan veröffentlicht, einen Datensatz synthetischer Personas für die Entwicklung von Künstlicher Intelligenz im japanischen Finanzsektor. Als finanzielle Erweiterung des Datensatzes Nemotron-Personas-Japan kombiniert er offizielle japanische Statistiken mit Daten zu Haushaltsfinanzen und Finanzbildung. Er wird unter der Lizenz CC BY 4.0 veröffentlicht, die kommerzielle Nutzung erlaubt.
In der Finanzbranche stößt die Nutzung echter Daten auf strenge Datenschutzregeln, Compliance-Anforderungen und den Bedarf an tiefgreifendem Fachwissen. Die Entwicklung agentischer KI in diesem Bereich, also von Systemen, die eigenständig Handlungen aneinanderreihen können, erfordert laut Quelle synthetische Daten, die Risiken echter Daten vermeiden und gleichzeitig Demografie, Haushaltszusammensetzung und Vermögen der Haushalte widerspiegeln.
Der Datensatz wurde auf Basis offizieller Regierungsstatistiken mit zwei NVIDIA-Tools erstellt: NeMo SDG-PGMs, einem probabilistischen Modellierungsframework für die Erzeugung synthetischer Daten, und NeMo Data Designer, einem System zur Generierung synthetischer Daten für Unternehmen. Das unter Apache-2.0-Lizenz verbreitete Modell gemma-4-31B-it wurde zur Erzeugung des japanischen Textes verwendet. Um den Datensatz für Finanz-Anwendungsfälle nützlicher zu machen, flossen bei der Konzeption Rückmeldungen mehrerer Akteure ein: Sompo Japan, Tokio Marine Holdings, Bank of Fukuoka, Mizuho Financial Group, Meiji Yasuda Life Insurance und die Financial Data Utilization Association (FDUA).
Ein groß angelegter Datensatz
Der Datensatz umfasst 1 Million Einträge mit jeweils 9 Personas, also insgesamt 9 Millionen Personas, verfasst in natürlichem Japanisch. Jeder Eintrag enthält 50 Felder: 9 Persona-Felder, 11 Persona-Attribute und 30 kontextbezogene Felder aus Bevölkerungs- und Beschäftigungsstatistiken. Das Volumen beträgt etwa 1,5 Milliarden Tokens, also Texteinheiten, die von Modellen verarbeitet werden, davon etwa 750 Millionen für die Personas.
Die Personas decken mehrere Dimensionen ab: Demografie, Region, Vermögensverteilung und Persönlichkeitsmerkmale. Sie enthalten etwa 950.000 eindeutige Namen und über 1.600 Berufskategorien, die die japanische Erwerbsbevölkerung widerspiegeln. Ihre Attribute beschreiben unter anderem den kulturellen Hintergrund, Fähigkeiten, Karriereziele, Hobbys, familiären und finanziellen Kontext, das Verhältnis zu Geld und die Finanzplanung.
Um Lebenssituationen besser abzubilden, die in Statistiken selten sichtbar sind, haben die Entwickler bestimmte Kategorien verfeinert. Das Bildungsniveau wird detaillierter beschrieben, neue Berufe wie Unternehmensführer wurden hinzugefügt, und Lebensphasen wie Studierende, Rentner oder Phasen der Arbeitslosigkeit wurden modelliert. Die Haushaltsfinanzen umfassen reale Vermögenswerte, und die Nutzung von Internet und Smartphone wird berücksichtigt.
Datenschutz und Anwendungen
Jede Persona ist vollständig synthetisch und stellt keine reale Person dar. Die demografischen und finanziellen Daten folgen offiziellen Statistiken und öffentlichen Erhebungen, während die Namen realen japanischen Namensmustern entsprechen. Laut Quelle ist der Datensatz so konzipiert, dass das Risiko von Datenschutzverletzungen reduziert wird und keine Kundendaten für seine Nutzung erforderlich sind.
Banken, Versicherer und sie unterstützende Start-ups sind die primären Zielgruppen. Teams können ihn nutzen, um Kundenservice-Agenten zu erstellen, Geschäftsprozesse und Marketingkampagnen zu bewerten, Nutzersimulationen mit NeMo User Sim durchzuführen oder KI-Systeme für Kunden Sicherheitstests zu unterziehen. Der Datensatz kann auch zur Erzeugung mehrstufiger Dialoge, zur Feinabstimmung von Modellen mit kulturell verankerten Daten und zur Überprüfung der Leistungskonsistenz einer KI zwischen ländlichen und städtischen Gebieten, Altersgruppen und Bildungsniveaus dienen.
Am selben Tag veröffentlichte NVIDIA Nemotron-PII-Japan, das 100.000 synthetische japanische Geschäftsdokumente mit annotierten persönlichen Informationen enthält, zum Training und Testen von Erkennungs- und Schwärzungsmodellen. Seine Dokumente basieren auf Nemotron-Personas-Japan. Der Datensatz wird mit der Funktion load_dataset der Bibliothek datasets geladen.
