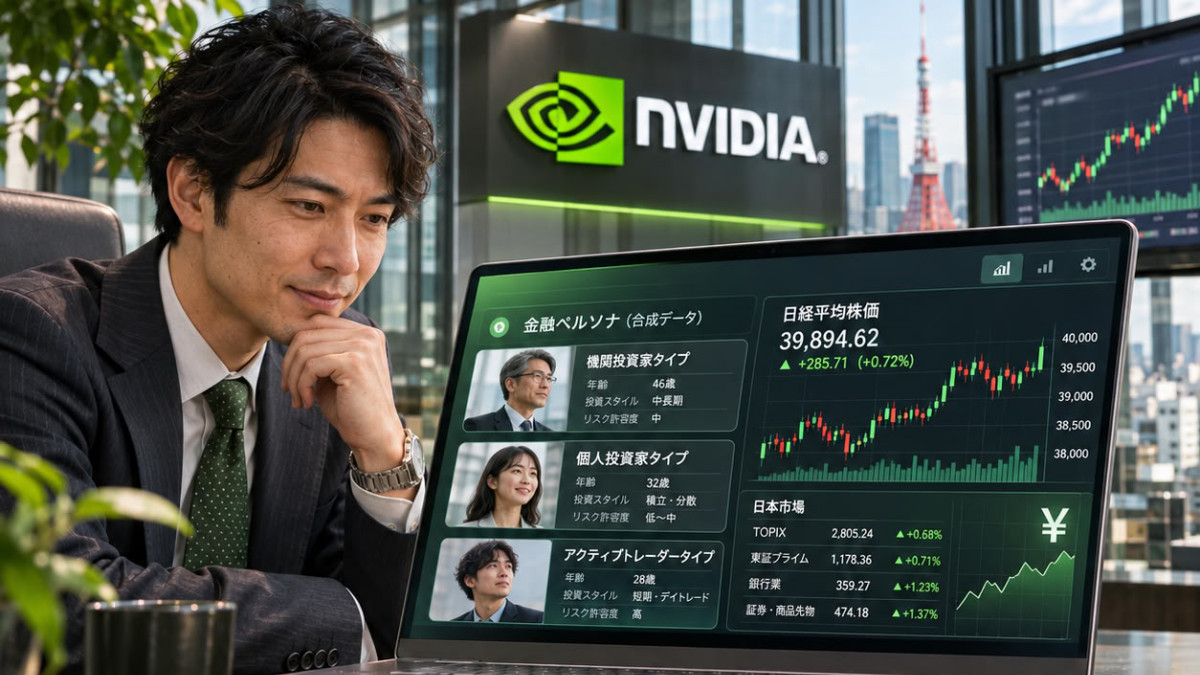

Elith и NVIDIA выпустили Nemotron-Personas-Finance-Japan — набор синтетических персонажей, предназначенный для разработки искусственного интеллекта в японском финансовом секторе. Будучи финансовым расширением датасета Nemotron-Personas-Japan, он сочетает официальную статистику Японии с данными о финансах домохозяйств и финансовой грамотности. Он опубликован под лицензией CC BY 4.0, разрешающей коммерческое использование.
В финансовой сфере использование реальных данных наталкивается на строгие правила конфиденциальности, требования соответствия и необходимость глубокой экспертизы в предметной области. Разработка агентного ИИ в этой области, то есть систем, способных автономно выполнять цепочки действий, по мнению источника, требует синтетических данных, которые позволяют избежать рисков, связанных с реальными данными, и при этом отражают демографию, состав домохозяйств и благосостояние семей.
Датасет был создан на основе официальной государственной статистики с использованием двух инструментов NVIDIA: NeMo SDG-PGMs — фреймворка вероятностного моделирования для генерации синтетических данных, и NeMo Data Designer — системы генерации синтетических данных для предприятий. Модель gemma-4-31B-it, распространяемая под лицензией Apache-2.0, использовалась для генерации текста на японском языке. Чтобы сделать датасет более полезным для финансовых сценариев использования, в его разработке учитывалась обратная связь от нескольких участников: Sompo Japan, Tokio Marine Holdings, Bank of Fukuoka, Mizuho Financial Group, Meiji Yasuda Life Insurance и Financial Data Utilization Association (FDUA).
Крупномасштабный датасет
Набор содержит 1 миллион записей, каждая из которых включает 9 персонажей, что в сумме составляет 9 миллионов персонажей, написанных на естественном японском языке. Каждая запись содержит 50 полей: 9 полей персонажей, 11 атрибутов персонажей и 30 контекстных полей, основанных на демографической и трудовой статистике. Объём данных достигает примерно 1,5 миллиарда токенов (единиц текста, обрабатываемых моделями), из которых около 750 миллионов приходится на персонажей.
Персонажи охватывают несколько измерений: демографию, регион, распределение активов и черты личности. Они включают около 950 000 уникальных имён и более 1600 категорий профессий, отражающих японскую рабочую силу. Их атрибуты описывают, в частности, культурный бэкграунд, навыки, карьерные цели, хобби, семейный и финансовый контекст, отношение к деньгам и финансовое планирование.
Чтобы лучше отражать жизненные ситуации, редко встречающиеся в статистике, разработчики уточнили некоторые категории. Уровень образования описан более детально, добавлены новые профессии, такие как владельцы бизнеса, а также смоделированы этапы жизни, включая студентов, пенсионеров или периоды безработицы. Финансы домохозяйств включают реальные активы, а также учтено использование интернета и смартфонов.
Конфиденциальность и применение
Каждый персонаж является полностью синтетическим и не представляет ни одного реального человека. Демографические и финансовые данные следуют официальной статистике и публичным опросам, в то время как имена соответствуют реальным японским схемам именования. По данным источника, набор разработан для снижения риска нарушения конфиденциальности и не требует использования каких-либо клиентских данных.
Банки, страховые компании и сопровождающие их стартапы являются первоочередными целевыми пользователями. Команды могут использовать его для создания агентов клиентского обслуживания, оценки бизнес-процессов и маркетинговых кампаний, проведения симуляций пользователей с помощью NeMo User Sim или для тестирования безопасности ИИ, предназначенных для клиентов. Набор также можно использовать для генерации многоходовых диалогов, тонкой настройки моделей на культурно-закреплённых данных и проверки однородности производительности ИИ между сельскими и городскими районами, возрастными группами и уровнями образования.
В тот же день NVIDIA выпустила Nemotron-PII-Japan, который содержит 100 000 синтетических японских профессиональных документов с аннотированной персональной информацией, предназначенных для обучения и тестирования моделей обнаружения и обезличивания. Его документы основаны на Nemotron-Personas-Japan. Датасет загружается с помощью функции load_dataset библиотеки datasets.
