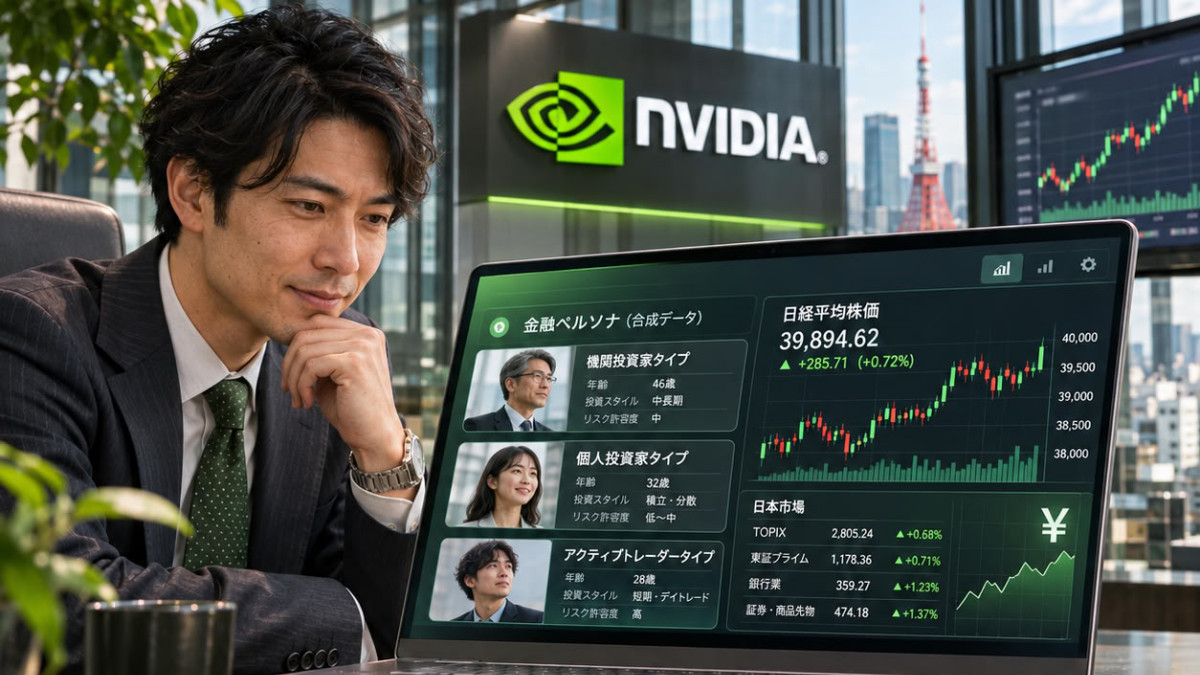

Elith en NVIDIA hebben Nemotron-Personas-Finance-Japan gepubliceerd, een dataset van synthetische persona’s bedoeld voor de ontwikkeling van kunstmatige intelligentie in de Japanse financiële sector. Als financiële uitbreiding van de dataset Nemotron-Personas-Japan combineert het officiële Japanse statistieken met gegevens over huishoudfinanciën en financiële cultuur. Het is gepubliceerd onder de CC BY 4.0-licentie, die commercieel gebruik toestaat.
In de financiële sector stuit het gebruik van echte gegevens op strikte privacyregels, nalevingsvereisten en de behoefte aan diepgaande vakinhoudelijke expertise. De ontwikkeling van agentische AI in dit domein, dat wil zeggen systemen die zelfstandig acties kunnen aaneenschakelen, vereist volgens de bron synthetische gegevens die de risico’s van echte data vermijden terwijl ze de demografie, huishoudsamenstelling en vermogenspositie van huishoudens weerspiegelen.
De dataset is opgebouwd uit officiële overheidsstatistieken, met twee tools van NVIDIA: NeMo SDG-PGMs, een probabilistisch modelleerkader voor de generatie van synthetische gegevens, en NeMo Data Designer, een systeem voor synthetische datageneratie voor bedrijven. Het model gemma-4-31B-it, gedistribueerd onder de Apache-2.0-licentie, is gebruikt om de Japanse tekst te genereren. Om de dataset nuttiger te maken voor financiële use cases, is bij het ontwerp feedback verwerkt van verschillende partijen: Sompo Japan, Tokio Marine Holdings, Bank of Fukuoka, Mizuho Financial Group, Meiji Yasuda Life Insurance en de Financial Data Utilization Association (FDUA).
Een grootschalige dataset
De dataset bevat 1 miljoen records met elk 9 persona’s, wat neerkomt op in totaal 9 miljoen persona’s, geschreven in natuurlijk Japans. Elk record bevat 50 velden: 9 persona-velden, 11 persona-attributen en 30 contextuele velden afkomstig uit demografische en werkgelegenheidsstatistieken. Het volume bedraagt ongeveer 1,5 miljard tokens, dat wil zeggen teksteenheden die door modellen worden verwerkt, waarvan ongeveer 750 miljoen voor de persona’s.
De persona’s beslaan verschillende dimensies: demografie, regio, vermogensverdeling en persoonlijkheidskenmerken. Ze bevatten ongeveer 950.000 unieke namen en meer dan 1.600 beroepscategorieën die de Japanse beroepsbevolking weerspiegelen. Hun attributen beschrijven onder meer culturele achtergrond, vaardigheden, carrièredoelen, hobby’s, gezins- en financiële context, omgang met geld en financiële planning.
Om levenssituaties die zelden in statistieken zichtbaar zijn beter weer te geven, hebben de ontwerpers bepaalde categorieën verfijnd. Het opleidingsniveau is gedetailleerder beschreven, nieuwe beroepen zoals ondernemers zijn toegevoegd, en levensfasen zoals studenten, gepensioneerden of periodes van werkloosheid zijn gemodelleerd. De huishoudfinanciën omvatten reële activa, en het gebruik van internet en smartphone is meegenomen.
Privacy en toepassingen
Elke persona is volledig synthetisch en vertegenwoordigt geen enkele echte persoon. De demografische en financiële gegevens volgen officiële statistieken en openbare enquêtes, terwijl de namen echte Japanse naamgevingspatronen respecteren. Volgens de bron is de dataset ontworpen om het risico op privacyinbreuk te verminderen en vereist het geen klantgegevens om te worden gebruikt.
Banken, verzekeraars en de start-ups die hen ondersteunen, zijn de eerste beoogde gebruikers. Teams kunnen het gebruiken om klantenservice-agents te creëren, commerciële processen en marketingcampagnes te evalueren, gebruikerssimulaties uit te voeren met NeMo User Sim, of klantgerichte AI-systemen aan veiligheidstests te onderwerpen. De dataset kan ook dienen om meerdaagse dialogen te genereren, modellen te verfijnen met cultureel verankerde gegevens, en te controleren of de prestaties van een AI consistent blijven tussen landelijke en stedelijke gebieden, leeftijdsgroepen en opleidingsniveaus.
Op dezelfde dag publiceerde NVIDIA Nemotron-PII-Japan, dat 100.000 synthetische Japanse professionele documenten bevat met geannoteerde persoonlijke informatie, bedoeld voor het trainen en testen van modellen voor detectie en redactie. De documenten zijn gebaseerd op Nemotron-Personas-Japan. De dataset kan worden geladen met de load_dataset-functie van de datasets-bibliotheek.
