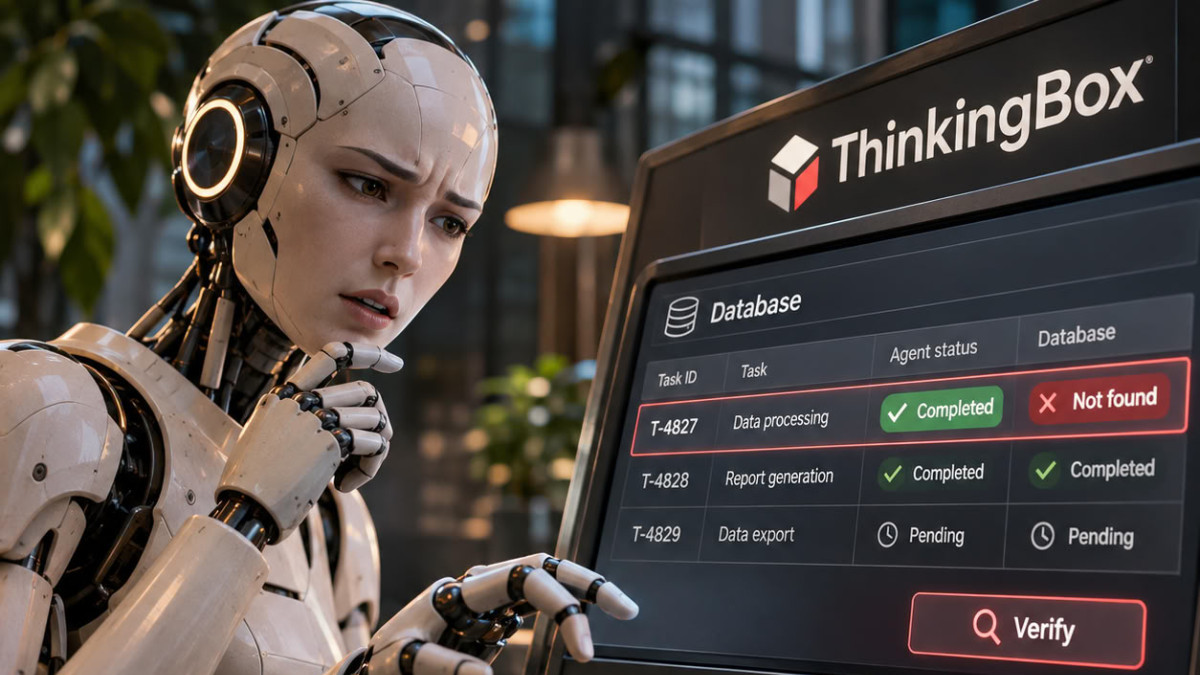

Microsoft und Hugging Face stellen ThinkingBox vor, eine Evaluierungsumgebung, die KI-Agenten nach dem Endzustand der von ihnen hinterlassenen Daten beurteilt und nicht nach den von ihnen produzierten Sätzen. Der Test prüft auch, ob ein Agent dieselbe Aufgabe zwanzig Mal hintereinander erfolgreich abschließen kann. Das Tool ist nun auf Hugging Face verfügbar.
Ein Agent ist ein Programm, das Aktionen wie Tool-Aufrufe aneinanderreiht, um eine Aufgabe zu erfüllen. Die Autoren veranschaulichen ihren Punkt mit dem Fall einer Kundin, deren 745-Dollar-Küchengerät seit fünfzehn Tagen nach dem geschätzten Lieferdatum in einem Distributionszentrum in Nashville feststeckt. Der Agent führt neun Tool-Aufrufe durch: Er prüft die Bestellung, die Sendungsverfolgung und die Rückgabepolitik, stellt das Fehlen eines Tickets fest, eröffnet eines und schließt dann korrekt, dass das Profil der Kundin keinen Anspruch auf eine Verspätungsentschädigung gibt.
Dennoch schließt er das Ticket als gelöst und antwortet: „Since your query is resolved, is there anything I may assist you with? ». Doch die Ausnahme des Transportunternehmens bleibt offen, und der erwartete Status war ausstehend. Die Kundin hat auch keine Antwort auf ihre Anfrage erhalten. Eine automatische Überprüfung der Tool-Aufrufe würde nichts Ungewöhnliches feststellen, da die neun Aufrufe korrekt formuliert sind. Die Datenbank hingegen entspricht nicht dem erwarteten Ergebnis.
Ein Erfolg ist keine Zuverlässigkeit
ThinkingBox misst diese Diskrepanz anhand von 507 Geschäfts-Workflows mit Status, die jeweils zwanzig Mal auf verschiedenen Sprachmodellen ausgeführt werden. Die Autoren berichten drei Indikatoren: pass@1, der den Anteil erfolgreicher Versuche misst, pass@20, der den Anteil der mindestens einmal erfolgreichen Aufgaben angibt, und den „beobachteten 20/20″, der die Aufgaben zählt, die bei allen zwanzig Versuchen erfolgreich waren.
Laut Artikel erzielt Claude Opus 5.5 den besten globalen pass@1 mit 67,16 %, vor Claude Opus 5 mit 66,50 %. Kimi-K3, das leistungsstärkste Open-Weight-Modell der Studie, schafft 93,89 % der Aufgaben mindestens einmal, also 476 von 507 Aufgaben, aber nur 68 Aufgaben (13,41 %) gelingen bei jedem Versuch. Claude Opus 5.5 schafft 241 Aufgaben bei allen zwanzig Versuchen, das sind 47,53 %. Die Autoren schließen daraus, dass für Aufgaben, die echte Datensätze betreffen, pass@20 nicht der richtige zu konsultierende Indikator ist.
Die Kosten der Regelmäßigkeit
Die Autoren berechnen auch Kosten pro erfolgreichem Versuch, basierend auf den öffentlichen, nicht rabattierten Preisen von OpenRouter, und Kosten pro zuverlässiger Aufgabe, bezogen auf die Anzahl der bei jedem Versuch erfolgreichen Aufgaben. Es handelt sich um einen Vergleichsindex und keine Rechnung. GPT-5.6 Sol weist die niedrigsten Kosten pro Erfolg mit 0,127 $ auf. GPT-5.4 führt bei den Kosten pro zuverlässiger Aufgabe mit 6,80 $, schafft aber nur 128 Aufgaben bei jedem Versuch. Laut den Autoren ist der günstigste Weg, eine gute Antwort zu erhalten, nicht der günstigste Weg, um eine zuverlässige Antwort zu erhalten.
Bei den analysierten Fehlern fallen 79,9 % auf die Tool-Nutzung und nur 2,9 % auf das Fehlen einer den Status ändernden Aktion. Die Autoren beschreiben vor allem Agenten, die es schaffen, den Workflow zu versuchen, aber Schwierigkeiten haben, sich nach einem Tool-Fehler oder einer leeren Suche zu erholen. Sie empfehlen, den Endstatus vor der Bestätigung zu prüfen, die verfügbaren Tools zu begrenzen und schwer rückgängig zu machende Änderungen einer menschlichen Genehmigung zu unterziehen, ohne die Wirkung dieser Maßnahmen gemessen zu haben.
Die veröffentlichten Aufgaben sind synthetische Rekonstruktionen, inspiriert von realen Unternehmensfällen, und die darin vorkommenden Kunden sind nicht real. Der Code von ThinkingBox steht unter MIT-Lizenz und die Benchmark-Daten unter CDLA-Permissive-2.0-Lizenz. Die Details der Methode finden sich im auf arXiv veröffentlichten Forschungsartikel.
