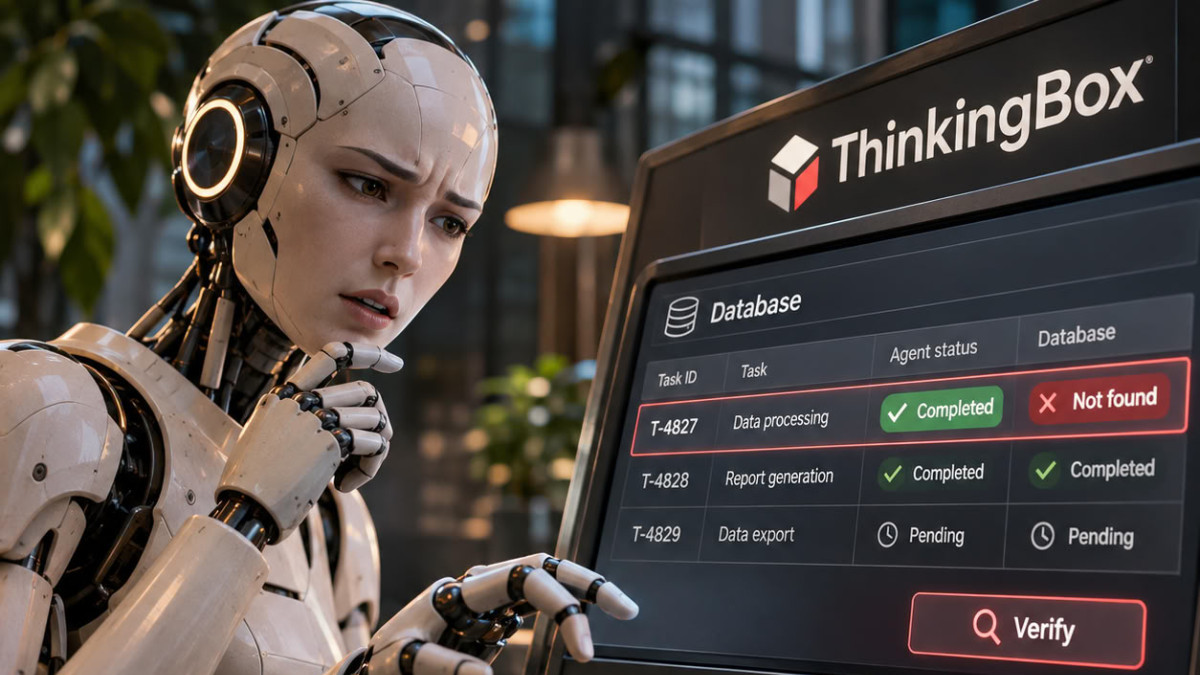

マイクロソフトとHugging Faceは、ThinkingBoxを発表した。これは、AIエージェントを、その生成する文言ではなく、残されたデータの最終状態に基づいて評価する環境である。このテストはまた、エージェントが同じタスクを20回連続で成功できるかどうかも検証する。このツールは現在Hugging Faceで利用可能。
エージェントとは、タスクを達成するためにツール呼び出しなどのアクションを連鎖させるプログラムである。著者らは、例として、745ドルの調理器具が納期予定日から15日経過してもナッシュビルの配送センターで滞留している顧客のケースを挙げている。エージェントは9回のツール呼び出しを行う:注文、追跡、返品ポリシーを確認し、チケットがないことを確認して新規作成し、最終的に顧客のプロファイルでは遅延補償の対象外であると正しく結論づける。
しかし、エージェントはチケットを解決済みとして閉じ、「Since your query is resolved, is there anything I may assist you with?」と返答する。しかし、運送会社の例外は未解決のままであり、期待された状態は保留中であった。顧客の問い合わせに対する回答も得られていない。ツール呼び出しの自動チェックでは、9回の呼び出しが適切に形成されているため異常を検知できない。一方、データベースは期待される結果と一致しない。
1回の成功は信頼性を意味しない
ThinkingBoxは、状態を持つ507の業務ワークフローそれぞれについて、異なる言語モデルで20回実行し、この乖離を測定する。著者らは3つの指標を報告している:pass@1(試行の成功率)、pass@20(少なくとも1回は成功したタスクの割合)、そして「観測された20/20」(20回の試行すべてで成功したタスクの数)。
論文によると、Claude Opus 5.5が全体のpass@1で最高の67.16%を記録し、Claude Opus 5の66.50%を上回った。本研究で最高性能のオープンウェイトモデルであるKimi-K3は、93.89%のタスク(507中476タスク)で少なくとも1回は成功したが、毎回成功したタスクは68(13.41%)のみであった。Claude Opus 5.5は241タスク(47.53%)で20回すべての試行に成功した。著者らは、実際の記録に影響を与えるタスクにおいては、pass@20は参照すべき適切な指標ではないと結論づけている。
一貫性のコスト
著者らはまた、OpenRouterの非割引公開価格を用いて、成功した試行あたりのコストと、毎回の試行で成功したタスク数に基づく信頼できるタスクあたりのコストを算出している。これは請求書ではなく比較指標である。GPT-5.6 Solが成功あたりの最低コスト0.127ドルを記録した。GPT-5.4は信頼できるタスクあたりのコストで6.80ドルとトップだが、毎回成功したタスクは128件のみである。著者らによれば、良い回答を得るための最も安価な方法は、信頼できる回答を得るための最も安価な方法とは異なる。
分析された失敗例のうち、79.9%はツール使用に関連し、状態変更アクションの欠如によるものはわずか2.9%であった。著者らは主に、ワークフローを試行することはできても、ツールエラーや空の検索結果からの回復に苦労するエージェントについて述べている。彼らは、最終状態を承認前に確認すること、利用可能なツールを制限すること、取り消しが困難な変更については人間の承認を求めることを推奨しているが、これらの対策の効果は測定されていない。
公開されているタスクは、実際の企業事例に基づく合成再構成であり、登場する顧客は実在しない。ThinkingBoxのコードはMITライセンス下にあり、ベンチマークデータはCDLA-Permissive-2.0ライセンス下にある。手法の詳細はarXivに公開された研究論文に記載されている。
