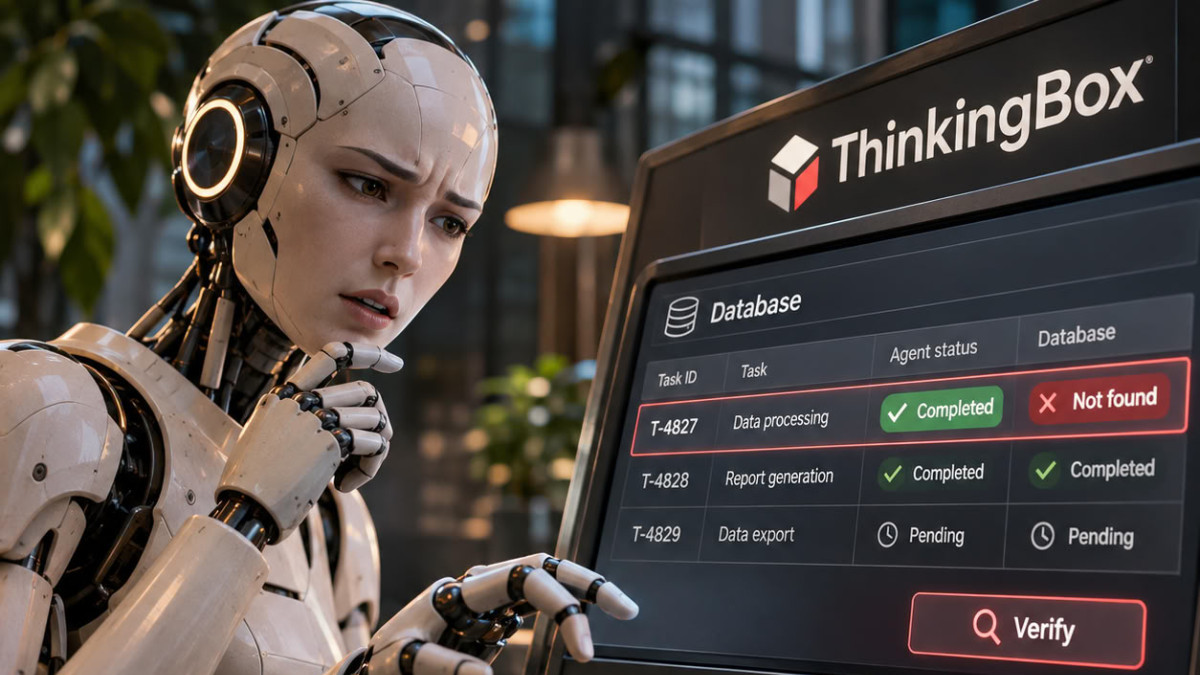

Microsoft i Hugging Face prezentują ThinkingBox, środowisko oceny, które ocenia agentów AI na podstawie końcowego stanu danych, które pozostawiają, a nie na podstawie generowanych zdań. Test sprawdza również, czy agent może pomyślnie wykonać to samo zadanie dwadzieścia razy z rzędu. Narzędzie jest już dostępne na Hugging Face.
Agent to program, który wykonuje sekwencję działań, takich jak wywołania narzędzi, aby wykonać zadanie. Autorzy ilustrują to przykładem klientki, której sprzęt kuchenny o wartości 745 dolarów utknął od dwóch tygodni po przewidywanej dacie dostawy w centrum dystrybucyjnym w Nashville. Agent wykonuje dziewięć wywołań narzędzi: sprawdza zamówienie, śledzenie i politykę zwrotów, weryfikuje brak zgłoszenia, otwiera je, a następnie poprawnie wnioskuje, że profil klientki nie uprawnia do odszkodowania za opóźnienie.
Mimo to zamyka zgłoszenie jako rozwiązane i odpowiada: „Since your query is resolved, is there anything I may assist you with? ». Tymczasem wyjątek przewoźnika pozostaje otwarty, a oczekiwany stan to w toku. Klientka również nie otrzymała odpowiedzi na swoją prośbę. Automatyczna kontrola wywołań narzędzi nie wykazałaby niczego nieprawidłowego, ponieważ wszystkie dziewięć wywołań jest poprawnie sformułowanych. Natomiast stan bazy danych nie odpowiada oczekiwanemu wynikowi.
Sukces to nie niezawodność
ThinkingBox mierzy tę rozbieżność na 507 biznesowych przepływach pracy ze stanem, każdy wykonywany dwadzieścia razy na różnych modelach językowych. Autorzy podają trzy wskaźniki: pass@1, który mierzy odsetek udanych prób, pass@20, który wskazuje odsetek zadań zakończonych sukcesem przynajmniej raz, oraz „zaobserwowane 20/20″, które zlicza zadania zakończone sukcesem we wszystkich dwudziestu próbach.
Według artykułu Claude Opus 5.5 osiąga najlepszy ogólny wynik pass@1, wynoszący 67,16%, przed Claude Opus 5 z wynikiem 66,50%. Kimi-K3, najlepszy otwarty model wagowo w badaniu, pomyślnie wykonuje 93,89% zadań przynajmniej raz, czyli 476 zadań na 507, ale tylko 68 zadań (13,41%) kończy się sukcesem w każdej próbie. Claude Opus 5.5 pomyślnie wykonuje 241 zadań we wszystkich dwudziestu próbach, co stanowi 47,53%. Autorzy wnioskują, że dla zadań dotyczących rzeczywistych rekordów, pass@20 nie jest właściwym wskaźnikiem do analizy.
Koszt regularności
Autorzy obliczają również koszt na udaną próbę, korzystając z publicznych, nierabatowanych cen OpenRouter, oraz koszt na niezawodne zadanie, odniesiony do liczby zadań zakończonych sukcesem w każdej próbie. Jest to wskaźnik porównawczy, a nie faktura. GPT-5.6 Sol wykazuje najniższy koszt na sukces, wynoszący 0,127$. GPT-5.4 prowadzi w kategorii kosztu na niezawodne zadanie, wynoszącego 6,80$, ale ma tylko 128 zadań zakończonych sukcesem w każdej próbie. Według autorów, najtańszy sposób na uzyskanie dobrej odpowiedzi nie jest najtańszym sposobem na uzyskanie odpowiedzi niezawodnej.
W analizowanych niepowodzeniach 79,9% dotyczy użycia narzędzi, a tylko 2,9% braku działania zmieniającego stan. Autorzy opisują głównie agentów, którym udaje się podjąć przepływ pracy, ale którzy mają trudności z odzyskaniem po błędzie narzędzia lub pustym wyniku wyszukiwania. Zalecają weryfikację stanu końcowego przed zatwierdzeniem, ograniczenie dostępnych narzędzi oraz wymaganie zatwierdzenia przez człowieka dla zmian trudnych do cofnięcia, bez zmierzenia efektu tych środków.
Opublikowane zadania są syntetycznymi rekonstrukcjami, inspirowanymi rzeczywistymi przypadkami biznesowymi, a występujący w nich klienci nie są prawdziwi. Kod ThinkingBox jest objęty licencją MIT, a dane benchmarku licencją CDLA-Permissive-2.0. Szczegóły metody znajdują się w artykule badawczym opublikowanym na arXiv.
