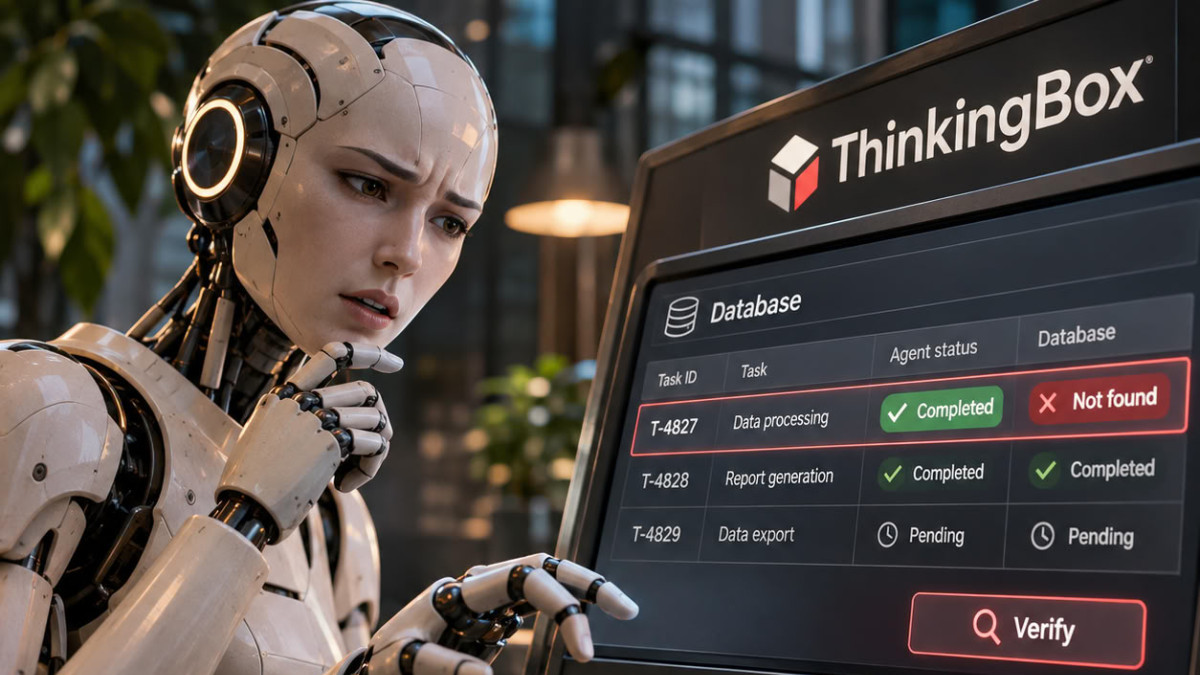

Microsoft et Hugging Face présentent ThinkingBox, un environnement d’évaluation qui juge les agents d’IA d’après l’état final des données qu’ils laissent derrière eux, et non d’après les phrases qu’ils produisent. Le test vérifie aussi si un agent peut réussir la même tâche vingt fois de suite. L’outil est désormais disponible sur Hugging Face.
Un agent est un programme qui enchaîne des actions, comme l’appel d’outils, pour accomplir une tâche. Les auteurs illustrent leur propos par le cas d’une cliente dont un appareil de cuisine à 745 $ est bloqué depuis quinze jours après sa date de livraison estimée, dans un centre de distribution de Nashville. L’agent effectue neuf appels d’outils : il consulte la commande, le suivi et la politique de remboursement, vérifie l’absence de ticket, en ouvre un, puis conclut correctement que le profil de la cliente ne donne pas droit à une compensation pour retard.
Il clôt pourtant le ticket comme résolu et répond : « Since your query is resolved, is there anything I may assist you with? ». Or l’exception du transporteur reste ouverte, et l’état attendu était en attente. La cliente n’a pas non plus obtenu de réponse à sa demande. Un contrôle automatique des appels d’outils n’y verrait rien d’anormal, car les neuf appels sont bien formés. La base de données, elle, ne correspond pas au résultat attendu.
Une réussite n’est pas une fiabilité
ThinkingBox mesure cet écart sur 507 workflows métiers avec état, chacun exécuté vingt fois sur différents modèles de langage. Les auteurs rapportent trois indicateurs : le pass@1, qui mesure la part des tentatives réussies, le pass@20, qui indique la part des tâches réussies au moins une fois, et le « 20/20 observé », qui compte les tâches réussies lors des vingt tentatives.
Selon l’article, Claude Opus 5.5 obtient le meilleur pass@1 global, avec 67,16 %, devant Claude Opus 5 à 66,50 %. Kimi-K3, le modèle à poids ouverts le plus performant de l’étude, réussit 93,89 % des tâches au moins une fois, soit 476 tâches sur 507, mais seulement 68 tâches (13,41 %) le sont à chaque tentative. Claude Opus 5.5 réussit 241 tâches sur les vingt tentatives, soit 47,53 %. Les auteurs en concluent que, pour des tâches touchant de vrais enregistrements, le pass@20 n’est pas le bon indicateur à consulter.
Le coût de la régularité
Les auteurs calculent aussi un coût par tentative réussie, en utilisant les tarifs publics non remisés d’OpenRouter, et un coût par tâche fiable, rapporté au nombre de tâches réussies à chaque tentative. Il s’agit d’un indice comparatif et non d’une facture. GPT-5.6 Sol affiche le coût le plus bas par succès, à 0,127 $. GPT-5.4 arrive en tête pour le coût par tâche fiable, à 6,80 $, mais ne compte que 128 tâches réussies à chaque tentative. Selon les auteurs, le moyen le moins cher d’obtenir une bonne réponse n’est pas le moins cher pour obtenir une réponse fiable.
Dans les échecs analysés, 79,9 % relèvent de l’usage des outils, et seulement 2,9 % d’une absence d’action modifiant l’état. Les auteurs décrivent surtout des agents qui parviennent à tenter le workflow, mais peinent à se rétablir après une erreur d’outil ou une recherche vide. Ils recommandent de vérifier l’état final avant validation, de limiter les outils disponibles et de soumettre à approbation humaine les modifications difficiles à annuler, sans avoir mesuré l’effet de ces mesures.
Les tâches publiées sont des reconstitutions synthétiques, inspirées de cas réels d’entreprises, et les clients qui y figurent ne sont pas réels. Le code de ThinkingBox est sous licence MIT, et les données du benchmark sous licence CDLA-Permissive-2.0. Les détails de la méthode figurent dans l’article de recherche publié sur arXiv.
