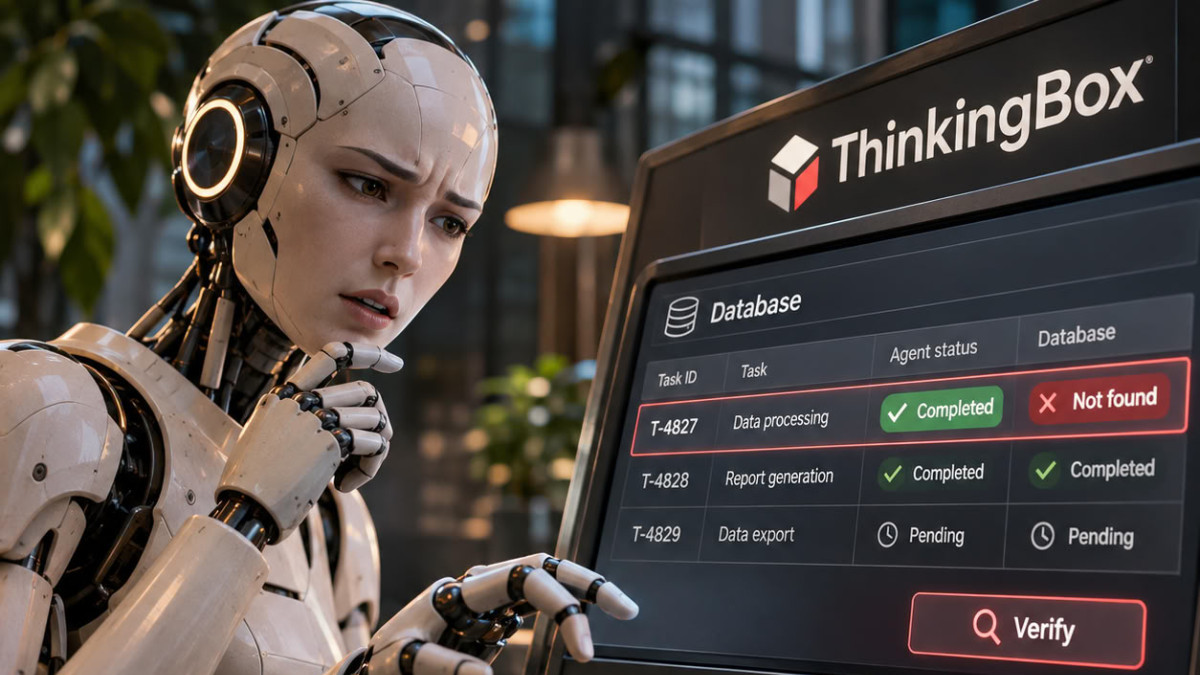

Microsoft en Hugging Face presenteren ThinkingBox, een evaluatieomgeving die AI-agents beoordeelt op basis van de eindtoestand van de gegevens die ze achterlaten, en niet op basis van de zinnen die ze produceren. De test controleert ook of een agent dezelfde taak twintig keer achter elkaar kan uitvoeren. De tool is nu beschikbaar op Hugging Face.
Een agent is een programma dat acties aan elkaar koppelt, zoals het aanroepen van tools, om een taak te voltooien. De auteurs illustreren hun punt met het geval van een klant wiens keukenapparaat van $745 al vijftien dagen vastzit na de geschatte leverdatum, in een distributiecentrum in Nashville. De agent voert negen toolaanroepen uit: hij raadpleegt de bestelling, de tracking en het retourbeleid, controleert op afwezigheid van een ticket, opent er een, en concludeert correct dat het profiel van de klant geen recht geeft op compensatie voor vertraging.
Toch sluit hij het ticket als opgelost en antwoordt: ‘Since your query is resolved, is there anything I may assist you with?’. Echter, de uitzondering van de vervoerder blijft open, en de verwachte status was in afwachting. De klant heeft ook geen antwoord op haar verzoek gekregen. Een automatische controle van de toolaanroepen zou niets abnormaals zien, omdat de negen aanroepen correct zijn opgebouwd. De database komt echter niet overeen met het verwachte resultaat.
Een succes is geen betrouwbaarheid
ThinkingBox meet dit verschil op 507 bedrijfsworkflows met status, elk twintig keer uitgevoerd op verschillende taalmodelen. De auteurs rapporteren drie indicatoren: de pass@1, die het aandeel succesvolle pogingen meet, de pass@20, die het aandeel taken aangeeft dat minstens één keer slaagt, en de ‘waargenomen 20/20’, die de taken telt die bij alle twintig pogingen slagen.
Volgens het artikel behaalt Claude Opus 5.5 de beste algemene pass@1, met 67,16 %, voor Claude Opus 5 met 66,50 %. Kimi-K3, het best presterende open-weight model van de studie, slaagt voor 93,89 % van de taken minstens één keer, dat zijn 476 taken op 507, maar slechts 68 taken (13,41 %) slagen bij elke poging. Claude Opus 5.5 slaagt voor 241 taken bij alle twintig pogingen, oftewel 47,53 %. De auteurs concluderen dat, voor taken die echte gegevens raken, de pass@20 niet de juiste indicator is om te raadplegen.
De kosten van regelmaat
De auteurs berekenen ook een kosten per succesvolle poging, met behulp van de niet-gesubsidieerde publieke tarieven van OpenRouter, en een kosten per betrouwbare taak, gerelateerd aan het aantal taken dat bij elke poging slaagt. Het gaat om een vergelijkende index en niet om een factuur. GPT-5.6 Sol toont de laagste kosten per succes, op $0,127. GPT-5.4 staat bovenaan voor de kosten per betrouwbare taak, op $6,80, maar telt slechts 128 taken die bij elke poging slagen. Volgens de auteurs is de goedkoopste manier om een goed antwoord te krijgen niet de goedkoopste manier om een betrouwbaar antwoord te krijgen.
In de geanalyseerde mislukkingen is 79,9 % toe te schrijven aan het gebruik van tools, en slechts 2,9 % aan een gebrek aan actie die de status wijzigt. De auteurs beschrijven vooral agents die erin slagen de workflow te proberen, maar moeite hebben om te herstellen na een toolfout of een lege zoekopdracht. Ze raden aan de eindstatus te controleren voor validatie, de beschikbare tools te beperken en wijzigingen die moeilijk ongedaan te maken zijn voor menselijke goedkeuring voor te leggen, zonder het effect van deze maatregelen te hebben gemeten.
De gepubliceerde taken zijn synthetische reconstructies, geïnspireerd op echte bedrijfscases, en de klanten die erin voorkomen zijn niet echt. De code van ThinkingBox valt onder de MIT-licentie, en de benchmarkgegevens onder de CDLA-Permissive-2.0-licentie. De details van de methode staan in het onderzoeksartikel gepubliceerd op arXiv.
