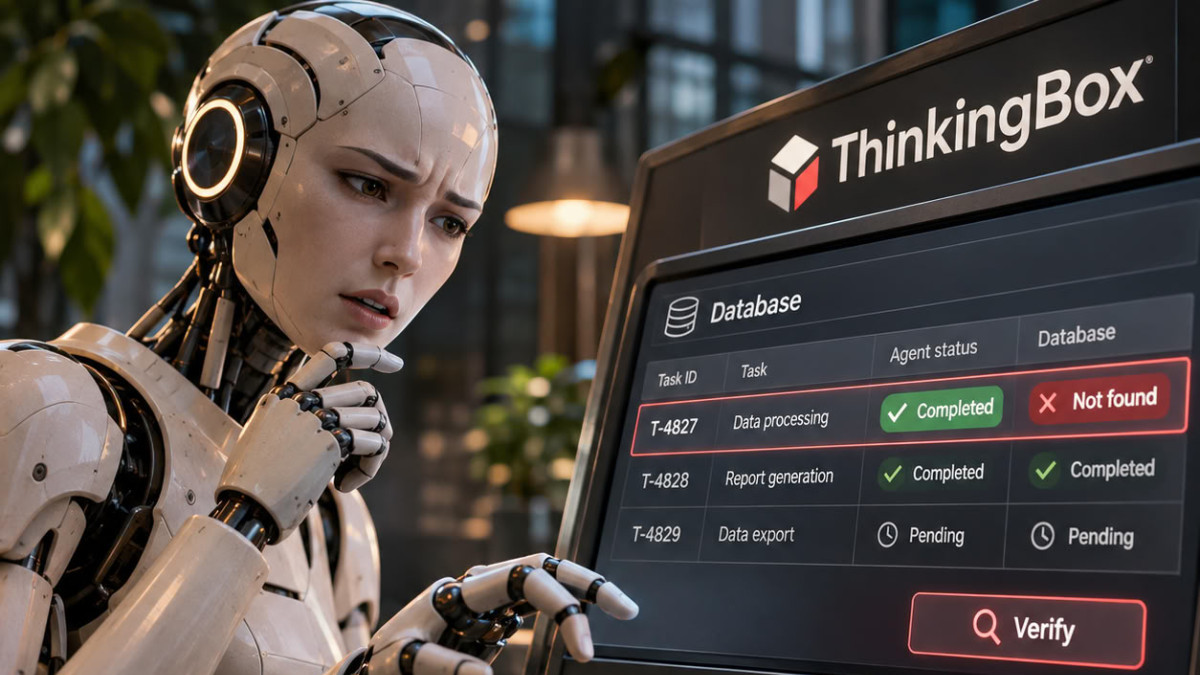

يقدم مايكروسوفت وهجينج فيس ThinkingBox، وهي بيئة تقييم تحكم على وكلاء الذكاء الاصطناعي بناءً على الحالة النهائية للبيانات التي يتركونها خلفهم، وليس بناءً على الجمل التي ينتجونها. يختبر التقييم أيضًا ما إذا كان الوكيل يمكنه إنجاز المهمة نفسها عشرين مرة متتالية. الأداة متاحة الآن على هجينج فيس.
الوكيل هو برنامج يربط سلسلة من الإجراءات، مثل استدعاء الأدوات، لإنجاز مهمة. يوضح المؤلفون فكرتهم من خلال حالة عميلة علق جهاز مطبخ بقيمة 745 دولارًا لمدة خمسة عشر يومًا بعد تاريخ التسليم المتوقع له، في مركز توزيع في ناشفيل. يقوم الوكيل بتسع استدعاءات لأدوات: فهو يستعلم عن الطلب، والتتبع، وسياسة الاسترداد، ويتحقق من عدم وجود تذكرة، ثم يفتح واحدة، ويخلص بعد ذلك بشكل صحيح إلى أن ملف العميلة لا يؤهلها للحصول على تعويض عن التأخير.
ومع ذلك، فإنه يُغلق التذكرة على أنها تم حلها ويجيب: «Since your query is resolved, is there anything I may assist you with?». لكن استثناء شركة النقل لا يزال مفتوحًا، والحالة المتوقعة كانت قيد الانتظار. كما أن العميلة لم تحصل على رد على طلبها. لن يرى الفحص الآلي لاستدعاءات الأدوات أي شيء غير طبيعي، لأن الاستدعاءات التسعة صحيحة من الناحية الشكلية. لكن قاعدة البيانات لا تتطابق مع النتيجة المتوقعة.
النجاح ليس موثوقية
يقيس ThinkingBox هذا الفارق عبر 507 سير عمل تجارية ذات حالة، يتم تنفيذ كل منها عشرين مرة على نماذج لغوية مختلفة. يقدم المؤلفون ثلاثة مؤشرات: pass@1، الذي يقيس نسبة المحاولات الناجحة، وpass@20، الذي يشير إلى نسبة المهام التي تم إنجازها بنجاح مرة واحدة على الأقل، و«20/20 الملاحظ»، الذي يحسب المهام التي نجحت في جميع المحاولات العشرين.
وفقًا للورقة البحثية، يحقق Claude Opus 5.5 أفضل نتيجة في pass@1 بشكل عام، بنسبة 67.16%، يليه Claude Opus 5 بنسبة 66.50%. Kimi-K3، النموذج مفتوح الأوزان الأكثر أداءً في الدراسة، ينجح في 93.89% من المهام مرة واحدة على الأقل، أي 476 مهمة من أصل 507، لكن 68 مهمة فقط (13.41%) تنجح في كل محاولة. ينجح Claude Opus 5.5 في 241 مهمة في جميع المحاولات العشرين، أي بنسبة 47.53%. يستنتج المؤلفون أنه بالنسبة للمهام التي تتعامل مع سجلات حقيقية، فإن pass@20 ليس المؤشر الصحيح للاستناد إليه.
تكلفة الانتظام
يحسب المؤلفون أيضًا تكلفة لكل محاولة ناجحة، باستخدام أسعار OpenRouter العامة غير المخفضة، وتكلفة لكل مهمة موثوقة، مقارنة بعدد المهام التي تنجح في كل محاولة. هذا مؤشر مقارن وليس فاتورة فعلية. يُظهر GPT-5.6 Sol أدنى تكلفة لكل نجاح، عند 0.127 دولار. يتصدر GPT-5.4 من حيث التكلفة لكل مهمة موثوقة، عند 6.80 دولار، لكنه يحقق فقط 128 مهمة ناجحة في كل محاولة. وفقًا للمؤلفين، فإن الطريقة الأقل تكلفة للحصول على إجابة جيدة ليست الأقل تكلفة للحصول على إجابة موثوقة.
في حالات الفشل التي تم تحليلها، تنسب 79.9% إلى استخدام الأدوات، و2.9% فقط إلى عدم وجود إجراء يغير الحالة. يصف المؤلفون بشكل أساسي وكلاءً يتمكنون من محاولة سير العمل، لكنهم يجدون صعوبة في التعافي بعد خطأ في أداة أو نتيجة بحث فارغة. يوصون بالتحقق من الحالة النهائية قبل الإقرار، وتقييد الأدوات المتاحة، وإخضاع التعديلات التي يصعب التراجع عنها للموافقة البشرية، دون قياس تأثير هذه الإجراءات.
المهام المنشورة هي إعادة بناء اصطناعية، مستوحاة من حالات حقيقية لشركات، والعملاء المذكورين فيها ليسوا حقيقيين. كود ThinkingBox مرخص بموجب رخصة MIT، وبيانات المعيار مرخصة بموجب رخصة CDLA-Permissive-2.0. تفاصيل المنهجية موجودة في الورقة البحثية المنشورة على arXiv.
