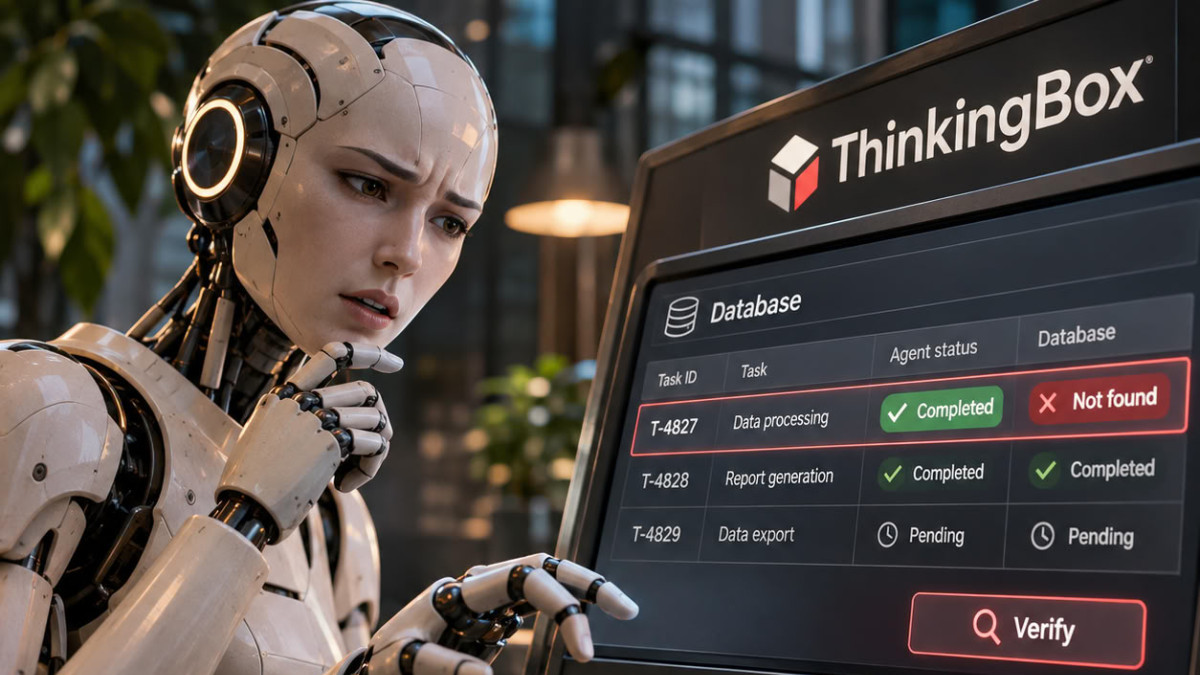

Microsoft y Hugging Face presentan ThinkingBox, un entorno de evaluación que juzga a los agentes de IA según el estado final de los datos que dejan tras de sí, y no según las frases que producen. La prueba también verifica si un agente puede completar la misma tarea veinte veces seguidas. La herramienta ya está disponible en Hugging Face.
Un agente es un programa que encadena acciones, como la llamada a herramientas, para cumplir una tarea. Los autores ilustran su punto con el caso de una cliente cuyo aparato de cocina de 745 $ lleva bloqueado quince días después de su fecha de entrega estimada, en un centro de distribución de Nashville. El agente realiza nueve llamadas a herramientas: consulta el pedido, el seguimiento y la política de reembolso, verifica la ausencia de un ticket, abre uno y concluye correctamente que el perfil de la cliente no da derecho a una compensación por retraso.
Sin embargo, cierra el ticket como resuelto y responde: «Since your query is resolved, is there anything I may assist you with?». Pero la excepción del transportista sigue abierta, y el estado esperado era en espera. La cliente tampoco ha obtenido respuesta a su solicitud. Un control automático de las llamadas a herramientas no vería nada anormal, pues las nueve llamadas están bien formuladas. La base de datos, en cambio, no coincide con el resultado esperado.
Un éxito no es una fiabilidad
ThinkingBox mide esta discrepancia en 507 flujos de trabajo empresariales con estado, cada uno ejecutado veinte veces en diferentes modelos de lenguaje. Los autores reportan tres indicadores: el pass@1, que mide la proporción de intentos exitosos; el pass@20, que indica la proporción de tareas completadas al menos una vez; y el «20/20 observado», que cuenta las tareas completadas en los veinte intentos.
Según el artículo, Claude Opus 5.5 obtiene el mejor pass@1 global, con un 67,16 %, por delante de Claude Opus 5 con un 66,50 %. Kimi-K3, el modelo de código abierto más eficaz del estudio, completa el 93,89 % de las tareas al menos una vez, es decir, 476 tareas de 507, pero solo 68 tareas (13,41 %) lo logran en cada intento. Claude Opus 5.5 completa 241 tareas en los veinte intentos, un 47,53 %. Los autores concluyen que, para tareas que afectan a registros reales, el pass@20 no es el indicador adecuado a consultar.
El costo de la regularidad
Los autores también calculan un costo por intento exitoso, utilizando los precios públicos sin descuento de OpenRouter, y un costo por tarea fiable, referido al número de tareas completadas en cada intento. Se trata de un índice comparativo y no de una factura. GPT-5.6 Sol muestra el costo más bajo por éxito, con 0,127 $. GPT-5.4 encabeza la lista en costo por tarea fiable, con 6,80 $, pero solo cuenta con 128 tareas completadas en cada intento. Según los autores, la forma más barata de obtener una buena respuesta no es la más barata para obtener una respuesta fiable.
En los fracasos analizados, el 79,9 % se debe al uso de herramientas, y solo el 2,9 % a una falta de acción que modifique el estado. Los autores describen principalmente agentes que logran intentar el flujo de trabajo, pero tienen dificultades para recuperarse tras un error de herramienta o una búsqueda vacía. Recomiendan verificar el estado final antes de la validación, limitar las herramientas disponibles y someter a aprobación humana las modificaciones difíciles de deshacer, sin haber medido el efecto de estas medidas.
Las tareas publicadas son reconstrucciones sintéticas, inspiradas en casos reales de empresas, y los clientes que aparecen en ellas no son reales. El código de ThinkingBox está bajo licencia MIT, y los datos del benchmark bajo licencia CDLA-Permissive-2.0. Los detalles del método figuran en el artículo de investigación publicado en arXiv.
