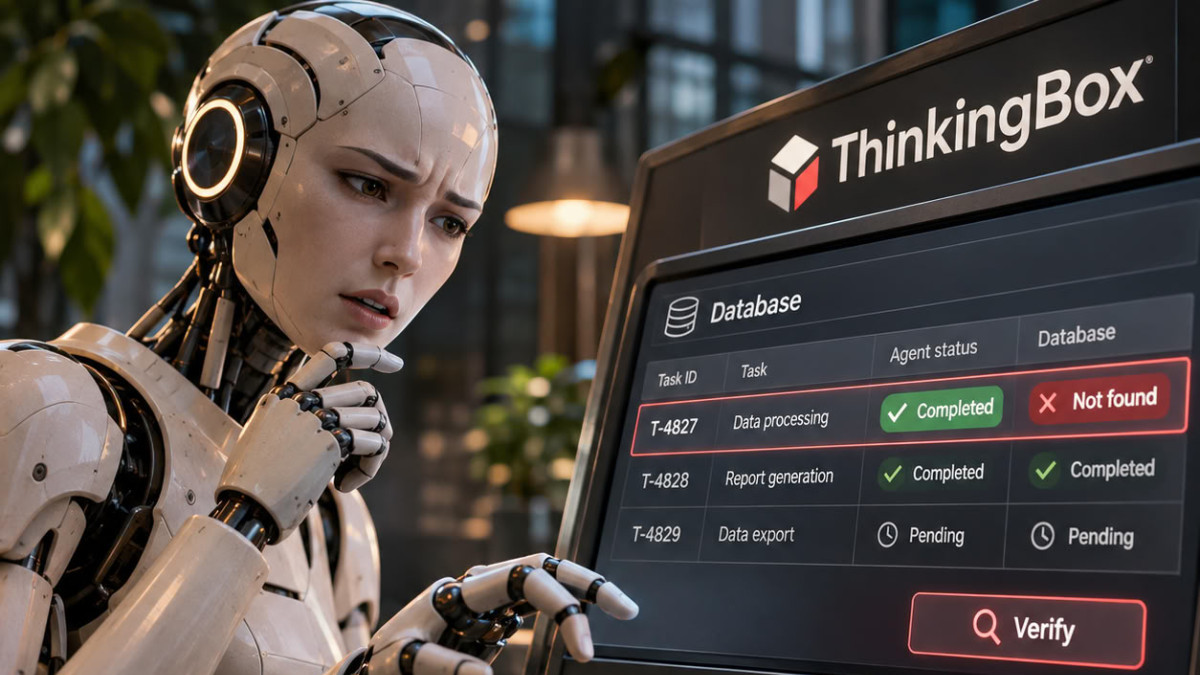

Microsoft и Hugging Face представляют ThinkingBox — среду оценки, которая судит ИИ-агентов по конечному состоянию оставленных ими данных, а не по генерируемым фразам. Тест также проверяет, может ли агент успешно выполнить одну и ту же задачу двадцать раз подряд. Инструмент теперь доступен на Hugging Face.
Агент — это программа, которая выполняет цепочку действий, например, вызов инструментов, для решения задачи. Авторы иллюстрируют свою мысль случаем клиентки, чья кухонная техника стоимостью 745 долларов застряла на две недели после предполагаемой даты доставки в распределительном центре в Нэшвилле. Агент выполняет девять вызовов инструментов: проверяет заказ, отслеживание и политику возвратов, убеждается в отсутствии тикета, открывает его, а затем правильно заключает, что профиль клиентки не дает права на компенсацию за задержку.
Однако он закрывает тикет как решённый и отвечает: «Since your query is resolved, is there anything I may assist you with?». Но исключение перевозчика остаётся открытым, а ожидаемым статусом был в ожидании. Клиентка также не получила ответа на свой запрос. Автоматическая проверка вызовов инструментов не увидела бы ничего необычного, так как все девять вызовов корректны. Однако состояние базы данных не соответствует ожидаемому результату.
Успех — это не надёжность
ThinkingBox измеряет это расхождение на 507 бизнес-процессах с состоянием, каждый из которых выполняется двадцать раз на разных языковых моделях. Авторы приводят три показателя: pass@1, измеряющий долю успешных попыток; pass@20, показывающий долю задач, успешно выполненных хотя бы один раз; и «наблюдаемый 20/20», подсчитывающий задачи, успешно выполненные во всех двадцати попытках.
Согласно статье, Claude Opus 5.5 показывает лучший общий результат по pass@1 — 67,16%, опережая Claude Opus 5 с 66,50%. Kimi-K3, самая производительная открытая модель в исследовании, успешно выполняет хотя бы раз 93,89% задач, то есть 476 из 507, но только 68 задач (13,41%) выполняются при каждой попытке. Claude Opus 5.5 успешно выполняет все двадцать попыток для 241 задачи, что составляет 47,53%. Авторы делают вывод, что для задач, затрагивающих реальные записи, pass@20 — не тот показатель, на который стоит ориентироваться.
Цена стабильности
Авторы также рассчитывают стоимость за успешную попытку, используя публичные недисконтированные тарифы OpenRouter, и стоимость за надёжную задачу, отнесённую к числу задач, успешно выполненных при каждой попытке. Это сравнительный индекс, а не реальный счёт. GPT-5.6 Sol демонстрирует самую низкую стоимость за успех — 0,127 доллара. GPT-5.4 лидирует по стоимости за надёжную задачу — 6,80 доллара, но при этом только 128 задач выполняются успешно при каждой попытке. По мнению авторов, самый дешёвый способ получить хороший ответ — не самый дешёвый способ получить надёжный ответ.
В проанализированных неудачах 79,9% связаны с использованием инструментов, и лишь 2,9% — с отсутствием действий, меняющих состояние. Авторы в основном описывают агентов, которым удаётся попытаться выполнить рабочий процесс, но которые с трудом восстанавливаются после ошибки инструмента или пустого результата поиска. Они рекомендуют проверять конечное состояние перед подтверждением, ограничивать доступные инструменты и отправлять на человеческое одобрение изменения, которые сложно отменить, хотя и не измерили эффект от этих мер.
Опубликованные задачи — синтетические реконструкции, вдохновлённые реальными бизнес-кейсами, а фигурирующие в них клиенты не являются реальными. Код ThinkingBox распространяется под лицензией MIT, а данные бенчмарка — под лицензией CDLA-Permissive-2.0. Подробности метода изложены в исследовательской статье, опубликованной на arXiv.
