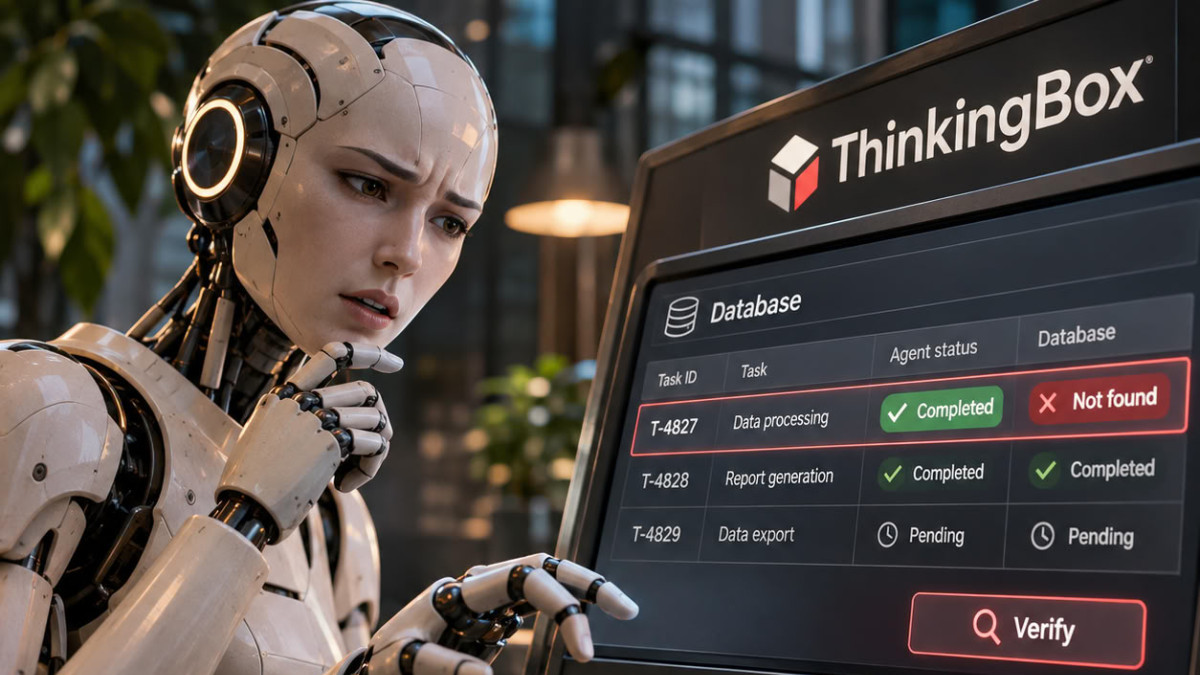

A Microsoft e a Hugging Face apresentam o ThinkingBox, um ambiente de avaliação que julga os agentes de IA com base no estado final dos dados que deixam para trás, e não nas frases que produzem. O teste verifica também se um agente consegue realizar a mesma tarefa vinte vezes seguidas. A ferramenta está agora disponível na Hugging Face.
Um agente é um programa que encadeia ações, como a chamada de ferramentas, para realizar uma tarefa. Os autores ilustram o seu ponto com o caso de uma cliente cujo aparelho de cozinha de 745 dólares está bloqueado há quinze dias após a data estimada de entrega, num centro de distribuição de Nashville. O agente efetua nove chamadas de ferramentas: consulta a encomenda, o rastreio e a política de reembolso, verifica a ausência de um ticket, abre um e conclui corretamente que o perfil da cliente não dá direito a uma compensação por atraso.
No entanto, ele fecha o ticket como resolvido e responde: «Since your query is resolved, is there anything I may assist you with?». Contudo, a exceção do transportador permanece aberta, e o estado esperado era em espera. A cliente também não obteve resposta ao seu pedido. Um controlo automático das chamadas de ferramentas não detetaria nada de anormal, pois as nove chamadas estão bem formadas. A base de dados, porém, não corresponde ao resultado esperado.
Um sucesso não é uma fiabilidade
O ThinkingBox mede este desvio em 507 fluxos de trabalho empresariais com estado, cada um executado vinte vezes em diferentes modelos de linguagem. Os autores relatam três indicadores: o pass@1, que mede a percentagem de tentativas bem-sucedidas; o pass@20, que indica a percentagem de tarefas concluídas com sucesso pelo menos uma vez; e o «20/20 observado», que conta as tarefas bem-sucedidas nas vinte tentativas.
Segundo o artigo, o Claude Opus 5.5 obtém o melhor pass@1 global, com 67,16%, à frente do Claude Opus 5 com 66,50%. O Kimi-K3, o modelo de pesos abertos mais eficiente do estudo, consegue realizar 93,89% das tarefas pelo menos uma vez, ou seja, 476 tarefas em 507, mas apenas 68 tarefas (13,41%) o são em todas as tentativas. O Claude Opus 5.5 consegue realizar 241 tarefas nas vinte tentativas, ou seja, 47,53%. Os autores concluem que, para tarefas que envolvem registos reais, o pass@20 não é o indicador correto a consultar.
O custo da regularidade
Os autores calculam também um custo por tentativa bem-sucedida, utilizando os preços públicos não descontados do OpenRouter, e um custo por tarefa fiável, reportado ao número de tarefas bem-sucedidas em cada tentativa. Trata-se de um índice comparativo e não de uma fatura. O GPT-5.6 Sol apresenta o custo mais baixo por sucesso, a 0,127 dólares. O GPT-5.4 lidera no custo por tarefa fiável, a 6,80 dólares, mas conta apenas com 128 tarefas bem-sucedidas em cada tentativa. Segundo os autores, o meio mais barato para obter uma boa resposta não é o mais barato para obter uma resposta fiável.
Nas falhas analisadas, 79,9% devem-se ao uso das ferramentas, e apenas 2,9% à ausência de uma ação que altere o estado. Os autores descrevem sobretudo agentes que conseguem tentar o fluxo de trabalho, mas têm dificuldade em recuperar após um erro de ferramenta ou uma pesquisa vazia. Recomendam verificar o estado final antes da validação, limitar as ferramentas disponíveis e submeter a aprovação humana as alterações difíceis de anular, sem terem medido o efeito destas medidas.
As tarefas publicadas são reconstituições sintéticas, inspiradas em casos reais de empresas, e os clientes que nelas figuram não são reais. O código do ThinkingBox está sob licença MIT, e os dados do benchmark sob licença CDLA-Permissive-2.0. Os detalhes do método constam do artigo de investigação publicado no arXiv.
