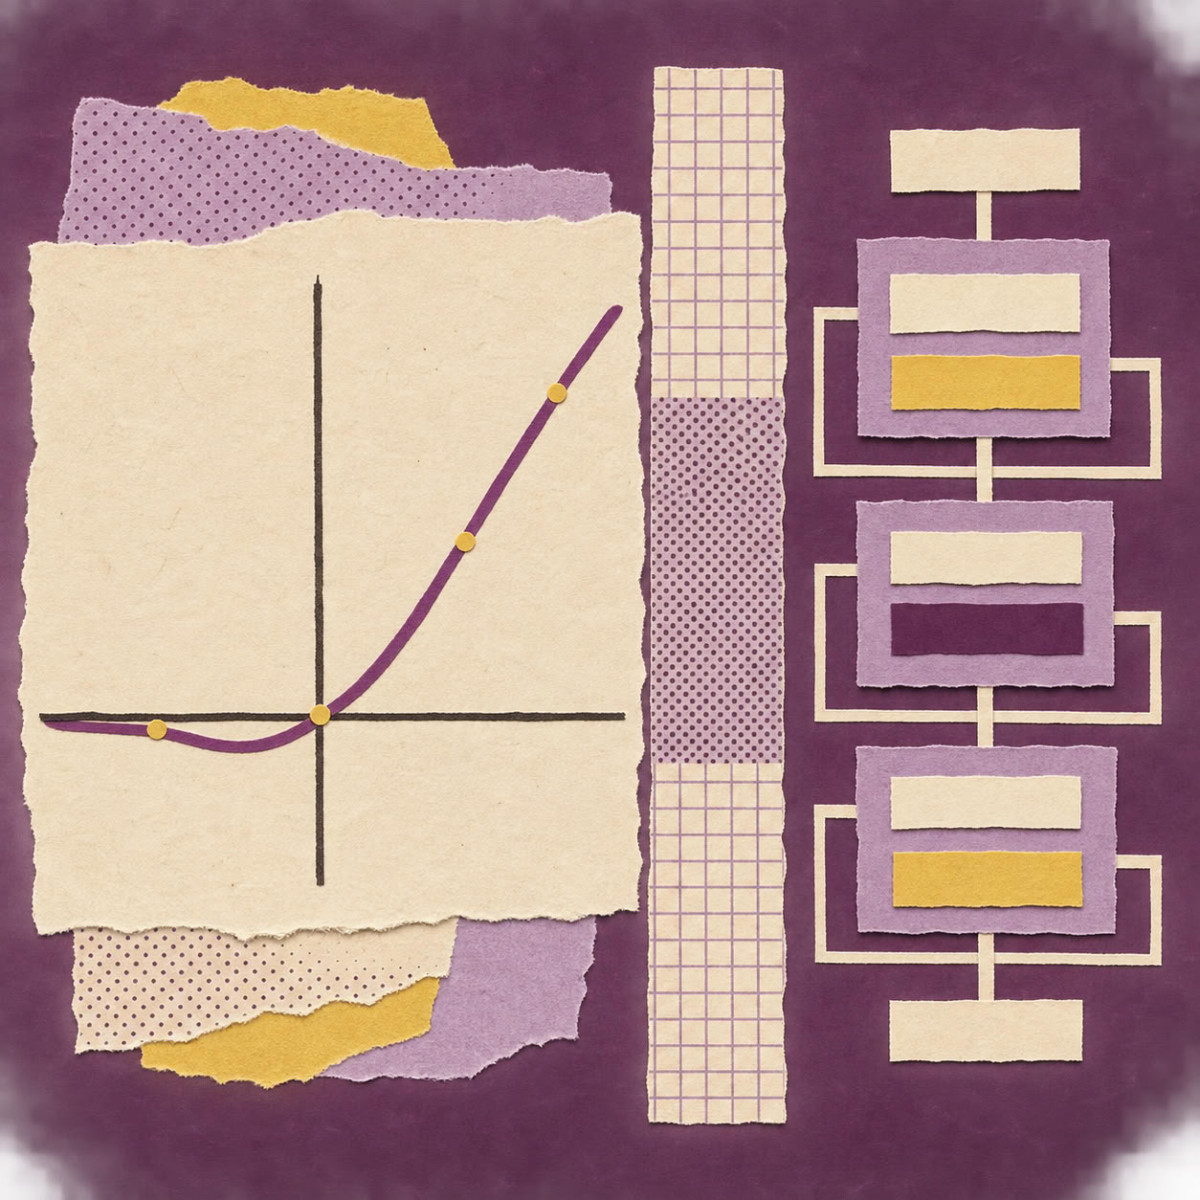

¿Por qué los modelos Transformer, como BERT, utilizan la función GELU en lugar de la función ReLU? Según un artículo publicado por Analytics Vidhya, la respuesta radica en cómo cada una procesa la información. Mientras que ReLU elimina por completo las entradas negativas, GELU aplica un mecanismo suave, que depende del valor de cada entrada, para decidir qué parte de la información debe pasar.
GELU, por Gaussian Error Linear Unit, es una función de activación no lineal introducida en 2016 por Dan Hendrycks y Kevin Gimpel. Una función de activación determina cómo una neurona transforma su entrada antes de transmitirla a la siguiente capa. Sin ella, el apilamiento de capas lineales solo produciría una transformación globalmente lineal, lo que limitaría lo que puede aprender una red neuronal.
GELU no aplica un umbral estricto. Escala cada entrada en función de su valor. Los valores positivos fuertes pasan casi sin cambios, los valores cercanos a cero se atenúan parcialmente y los valores negativos fuertes se reducen hacia cero. Los valores moderadamente negativos pueden conservar una pequeña salida negativa. El artículo señala que el trabajo original de GELU evaluó la función en visión por computadora, procesamiento del lenguaje natural y reconocimiento de voz, y que informó mejoras respecto a varias funciones tradicionales en sus experimentos.
GELU frente a ReLU
ReLU, por Rectified Linear Unit, devuelve 0 para una entrada negativa y el valor mismo para una entrada positiva. Así, para una entrada de -1, devuelve 0, y para una entrada de 2, devuelve 2. GELU se comporta de manera diferente: una entrada de -1 da aproximadamente -0,159, y una entrada de 2 da aproximadamente 1,954. La función, por tanto, no es estrictamente creciente en todo su dominio, presentando su zona negativa una ligera depresión antes de acercarse a cero para valores muy negativos.
GELU se escribe como x × Φ(x), donde Φ(x) es la función de distribución acumulativa de la distribución normal estándar, es decir, una distribución de media cero y desviación estándar uno. Esta función se expresa mediante la función de error erf. Para una entrada de 1, el valor de Φ es aproximadamente 0,8413: la señal positiva se conserva en gran medida, mientras que la señal negativa de -1 se reduce drásticamente. El texto precisa que GELU es determinista. No elimina aleatoriamente salidas de neuronas durante la ejecución, aunque su funcionamiento a veces se describe como un mecanismo de filtrado probabilístico.
ReLU sigue siendo popular porque es simple y poco costosa en cálculo. GELU ofrece una transformación más suave, pero su forma matemática requiere más cálculos. El artículo subraya además que ninguna de las dos es automáticamente mejor: la arquitectura del modelo, el conjunto de datos, el hardware y la implementación influyen todos en el resultado final.
¿Por qué está presente GELU en los Transformers?
Un Transformer, la arquitectura en la que se basan BERT y muchos grandes modelos de lenguaje, combina mecanismos de atención, capas de normalización y redes neuronales de propagación hacia adelante, o FFN. GELU se utiliza comúnmente en el FFN, y no en el cálculo de las probabilidades de atención. En la arquitectura BERT, es la función de activación por defecto de las capas ocultas, como indica la configuración de BERT de Hugging Face. También aparece en los Transformers de visión, pero algunos modelos recientes utilizan variantes con puerta basadas en SiLU, como SwiGLU.
La fórmula exacta de GELU hace uso de la función de distribución acumulativa gaussiana, más costosa de calcular que funciones más simples. El artículo presenta una aproximación común basada en la función tangente hiperbólica, que produce valores cercanos a GELU exacta. PyTorch permite utilizar ambas formulaciones gracias a su parámetro approximate.
Un experimento en Python
El autor compara dos redes idénticas, una con ReLU y otra con GELU, en el conjunto de datos make_moons de scikit-learn, compuesto por 2.000 muestras. Ambos modelos comparten la misma arquitectura, el mismo optimizador Adam, la misma tasa de aprendizaje de 0,001 y la misma semilla aleatoria, durante 100 épocas. El artículo advierte que una sola ejecución no basta para establecer la mejor función: recomienda repetir el experimento con varias semillas aleatorias y reservar el conjunto de prueba para la evaluación final. Su objetivo no es demostrar que GELU es universalmente superior.
Para un modelo preentrenado, el texto recomienda generalmente conservar la función de activación original. Sustituir GELU por ReLU en un Transformer preentrenado modifica sus cálculos y puede reducir su rendimiento, a menos que el modelo modificado sea correctamente reentrenado o afinado.
