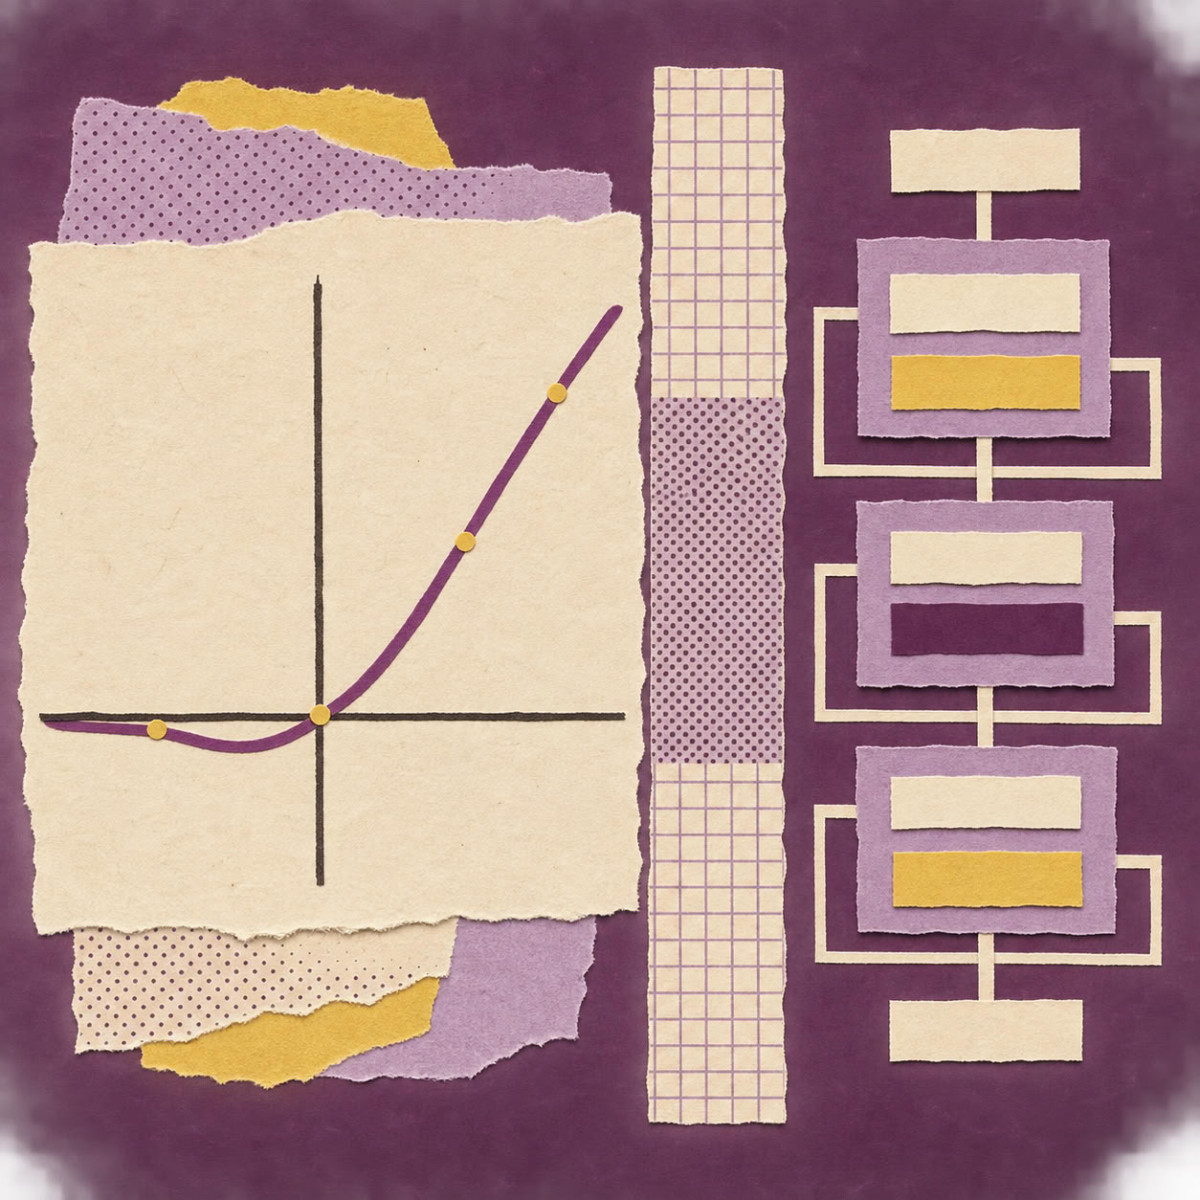

Warum verwenden Transformer-Modelle wie BERT die GELU-Funktion statt der ReLU-Funktion? Laut einem Artikel von Analytics Vidhya liegt die Antwort in der Art und Weise, wie jede Funktion Informationen verarbeitet. Während ReLU negative Eingaben vollständig unterdrückt, wendet GELU einen glatten Mechanismus an, der vom Wert jeder Eingabe abhängt, um zu entscheiden, welcher Teil der Information durchgelassen werden soll.
GELU, für Gaussian Error Linear Unit, ist eine nichtlineare Aktivierungsfunktion, die 2016 von Dan Hendrycks und Kevin Gimpel eingeführt wurde. Eine Aktivierungsfunktion bestimmt, wie ein Neuron seine Eingabe transformiert, bevor sie an die nächste Schicht weitergegeben wird. Ohne sie würde das Stapeln linearer Schichten nur eine insgesamt lineare Transformation erzeugen, was die Lernfähigkeit eines neuronalen Netzwerks einschränken würde.
GELU wendet keine strikte Schwelle an. Sie skaliert jede Eingabe basierend auf ihrem Wert. Starke positive Werte passieren nahezu unverändert, Werte nahe Null werden teilweise abgeschwächt und stark negative Werte werden gegen Null gedrückt. Mäßig negative Werte können eine kleine negative Ausgabe behalten. Der Artikel stellt fest, dass die ursprüngliche GELU-Publikation die Funktion in den Bereichen Computer Vision, Natural Language Processing und Spracherkennung evaluierte und in ihren Experimenten Verbesserungen gegenüber mehreren traditionellen Funktionen berichtete.
GELU im Vergleich zu ReLU
ReLU, für Rectified Linear Unit, gibt 0 für eine negative Eingabe und den Wert selbst für eine positive Eingabe zurück. Für eine Eingabe von -1 gibt sie also 0 zurück, für eine Eingabe von 2 gibt sie 2 zurück. GELU verhält sich anders: Eine Eingabe von -1 ergibt etwa -0,159, und eine Eingabe von 2 ergibt etwa 1,954. Die Funktion ist daher nicht streng monoton steigend über ihren gesamten Definitionsbereich, wobei ihr negativer Bereich eine leichte Delle aufweist, bevor sie sich für sehr negative Werte Null nähert.
GELU wird geschrieben als x × Φ(x), wobei Φ(x) die kumulative Verteilungsfunktion der Standardnormalverteilung ist, also einer Verteilung mit Mittelwert Null und Standardabweichung Eins. Diese Funktion wird mit der Fehlerfunktion erf ausgedrückt. Für eine Eingabe von 1 beträgt der Wert von Φ etwa 0,8413: Das positive Signal wird also weitgehend beibehalten, während das negative Signal von -1 stark reduziert wird. Der Text präzisiert, dass GELU deterministisch ist. Sie löscht während der Ausführung nicht zufällig Neuronenaustgaben, auch wenn ihre Funktionsweise manchmal als probabilistischer Filtrationsmechanismus beschrieben wird.
ReLU bleibt beliebt, weil sie einfach und recheneffizient ist. GELU bietet eine glattere Transformation, aber ihre mathematische Form erfordert mehr Berechnungen. Der Artikel hebt außerdem hervor, dass keine der beiden Funktionen automatisch besser ist: Die Modellarchitektur, der Datensatz, die Hardware und die Implementierung beeinflussen alle das Endergebnis.
Warum GELU in Transformers vorhanden ist
Ein Transformer, die Architektur, auf der BERT und viele große Sprachmodelle basieren, kombiniert Aufmerksamkeitsmechanismen, Normalisierungsschichten und sogenannte Feed-Forward-Neuronale Netze (FFN). GELU wird üblicherweise im FFN verwendet und nicht bei der Berechnung der Aufmerksamkeitswahrscheinlichkeiten. In der BERT-Architektur ist sie die Standard-Aktivierungsfunktion für die verborgenen Schichten, wie die BERT-Konfiguration von Hugging Face angibt. Sie taucht auch in Vision Transformers auf, aber einige neuere Modelle verwenden gated Varianten basierend auf SiLU, wie SwiGLU.
Die exakte Formel für GELU beinhaltet die Gauß’sche Verteilungsfunktion, die rechenintensiver ist als einfachere Funktionen. Der Artikel stellt eine gängige Approximation vor, die auf der hyperbolischen Tangensfunktion basiert und Werte nahe der exakten GELU liefert. PyTorch ermöglicht die Verwendung beider Formulierungen über seinen Parameter approximate.
Ein Experiment in Python
Der Autor vergleicht zwei identische Netzwerke, eines mit ReLU und eines mit GELU, auf dem make_moons-Datensatz von scikit-learn, der aus 2000 Stichproben besteht. Beide Modelle teilen sich die gleiche Architektur, den gleichen Adam-Optimierer, die gleiche Lernrate von 0,001 und den gleichen Zufallsseed, über 100 Epochen. Der Artikel warnt, dass ein einzelner Lauf nicht ausreicht, um die beste Funktion zu bestimmen: Er empfiehlt, das Experiment mit mehreren Zufallsseeds zu wiederholen und den Testdatensatz für die finale Evaluation aufzubewahren. Sein Ziel ist nicht zu zeigen, dass GELU universell überlegen ist.
Für ein vortrainiertes Modell empfiehlt der Text generell, die ursprüngliche Aktivierungsfunktion beizubehalten. Das Ersetzen von GELU durch ReLU in einem vortrainierten Transformer verändert seine Berechnungen und kann seine Leistung reduzieren, es sei denn, das modifizierte Modell wird angemessen neu trainiert oder fine-getuned.
