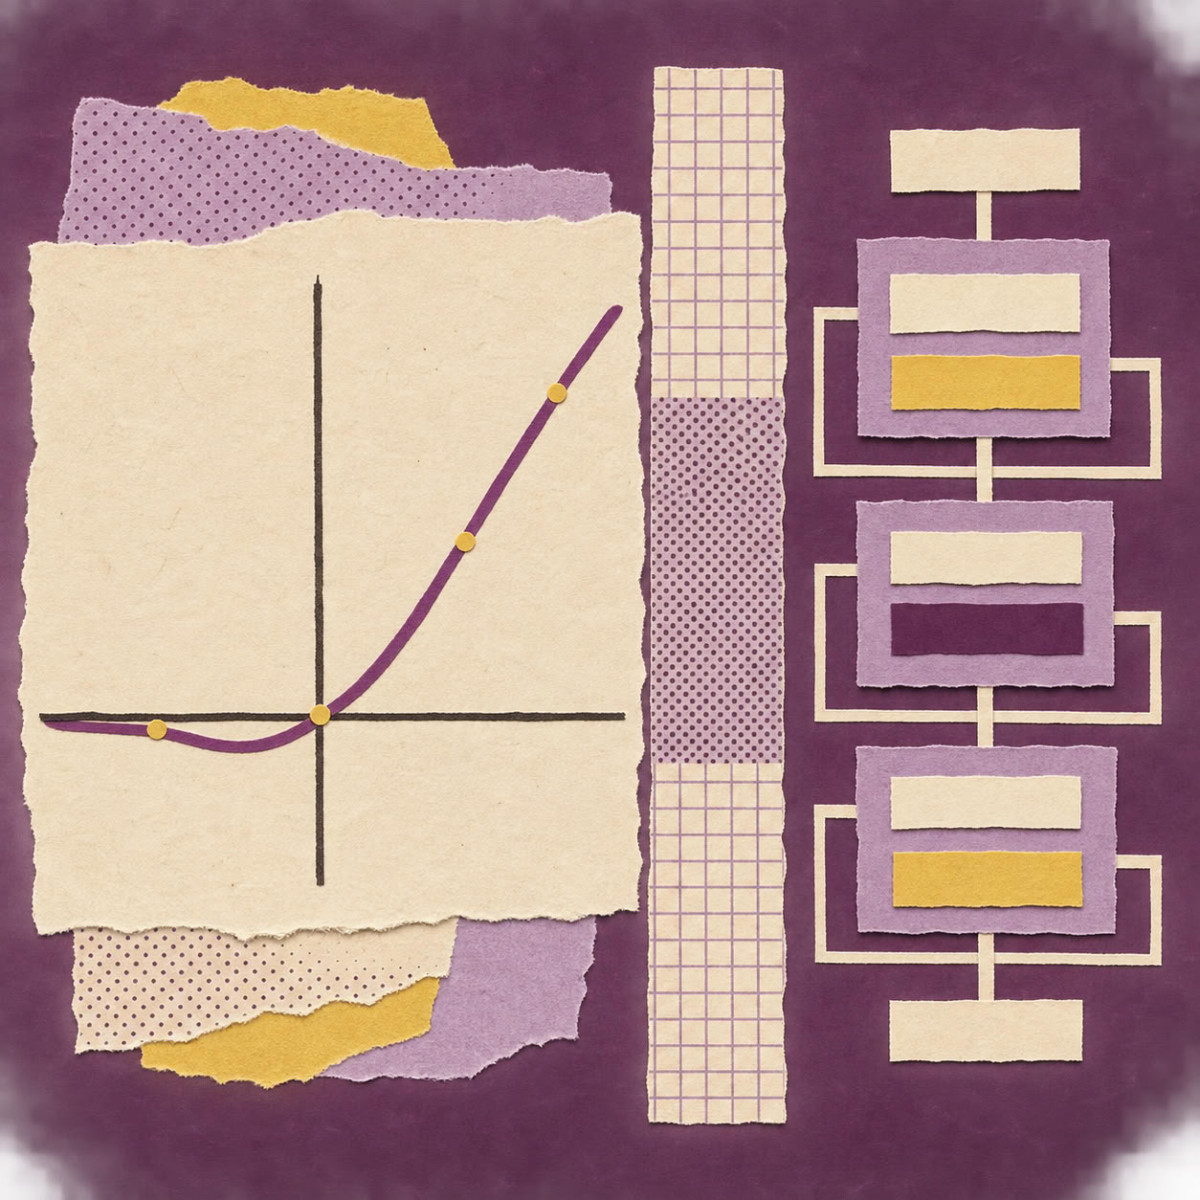

Почему модели Transformer, такие как BERT, используют функцию GELU вместо ReLU? Согласно статье Analytics Vidhya, ответ кроется в способе обработки информации. В то время как ReLU полностью отсекает отрицательные входные данные, GELU применяет плавный механизм, зависящий от значения каждого входа, чтобы решить, какая часть информации должна пройти.
GELU, или Gaussian Error Linear Unit, — это нелинейная функция активации, представленная в 2016 году Дэном Хендриксом и Кевином Гимпелом. Функция активации определяет, как нейрон преобразует свой вход перед передачей на следующий слой. Без неё наложение линейных слоёв давало бы лишь глобально линейное преобразование, что ограничивало бы возможности обучения нейронной сети.
GELU не применяет строгий порог. Она масштабирует каждый вход в зависимости от его значения. Сильные положительные значения проходят почти неизменными, значения близкие к нулю частично ослабляются, а сильные отрицательные значения приближаются к нулю. Умеренно отрицательные значения могут сохранять небольшой отрицательный выход. В статье отмечается, что оригинальная работа по GELU оценивала функцию в компьютерном зрении, обработке естественного языка и распознавании речи и сообщала об улучшениях по сравнению с несколькими традиционными функциями в своих экспериментах.
GELU против ReLU
ReLU, или Rectified Linear Unit, возвращает 0 для отрицательного входа и само значение для положительного входа. Так, для входа -1 она возвращает 0, а для входа 2 возвращает 2. GELU ведёт себя иначе: вход -1 даёт примерно -0.159, а вход 2 даёт примерно 1.954. Таким образом, функция не является строго возрастающей на всей своей области определения, её отрицательная область имеет небольшой провал перед приближением к нулю для очень отрицательных значений.
GELU записывается как x × Φ(x), где Φ(x) — это функция распределения стандартного нормального закона, то есть закона с нулевым средним и единичным стандартным отклонением. Эта функция выражается через функцию ошибок erf. Для входа 1 значение Φ составляет примерно 0.8413: таким образом, положительный сигнал в значительной степени сохраняется, в то время как отрицательный сигнал -1 сильно уменьшается. В тексте уточняется, что GELU детерминирована. Она не удаляет случайным образом выходы нейронов во время выполнения, даже если её работу иногда описывают как вероятностный механизм фильтрации.
ReLU остаётся популярной благодаря своей простоте и низкой вычислительной стоимости. GELU предлагает более плавное преобразование, но её математическая форма требует больше вычислений. В статье также подчёркивается, что ни одна из них не является автоматически лучше: архитектура модели, набор данных, аппаратное обеспечение и реализация — всё это влияет на конечный результат.
Почему GELU используется в Transformers
Transformer, архитектура, лежащая в основе BERT и многих больших языковых моделей, сочетает механизмы внимания, слои нормализации и так называемые полносвязные сети (FFN). GELU обычно используется в FFN, а не в вычислении вероятностей внимания. В архитектуре BERT она является функцией активации по умолчанию для скрытых слоёв, как указано в конфигурации BERT от Hugging Face. Она также появляется в Vision Transformers, хотя некоторые современные модели используют варианты с гейтированием на основе SiLU, такие как SwiGLU.
Точная формула GELU использует функцию распределения Гаусса, вычисление которой дороже, чем более простых функций. В статье представлено распространённое приближение, основанное на гиперболическом тангенсе, которое даёт значения, близкие к точной GELU. PyTorch позволяет использовать обе формулировки благодаря своему параметру approximate.
Эксперимент на Python
Автор сравнивает две идентичные сети, одну с ReLU, а другую с GELU, на наборе данных make_moons из scikit-learn, состоящем из 2000 образцов. Обе модели имеют одинаковую архитектуру, один и тот же оптимизатор Adam, одинаковую скорость обучения 0.001 и одинаковый случайный сид, и обучаются в течение 100 эпох. В статье предупреждается, что одного запуска недостаточно для определения лучшей функции: рекомендуется повторить эксперимент с несколькими случайными сидами и оставить тестовый набор для окончательной оценки. Её цель — не доказать, что GELU универсально лучше.
Для предобученной модели в тексте обычно рекомендуется сохранять исходную функцию активации. Замена GELU на ReLU в предобученном Transformer изменяет его вычисления и может снизить производительность, если только изменённая модель не будет должным образом дообучена или тонко настроена.
