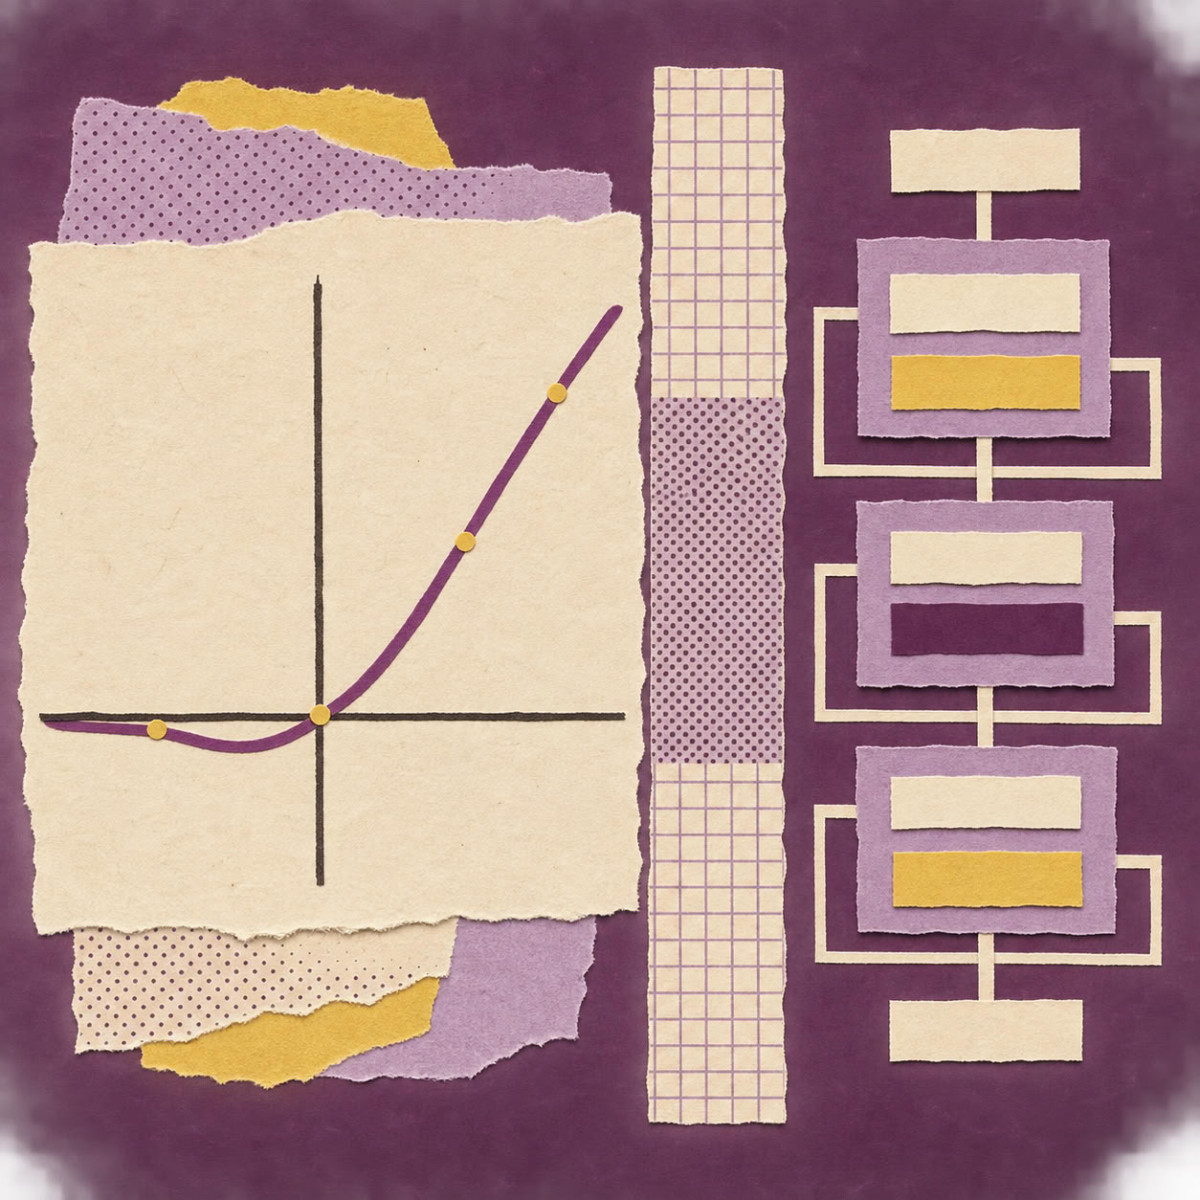

Por que razão os modelos Transformer, como o BERT, utilizam a função GELU em vez da função ReLU? De acordo com um artigo publicado pela Analytics Vidhya, a resposta reside na forma como cada uma processa a informação. Enquanto a ReLU elimina completamente as entradas negativas, a GELU aplica um mecanismo suave, que depende do valor de cada entrada, para decidir que parte da informação deve passar.
GELU, que significa Gaussian Error Linear Unit, é uma função de ativação não linear introduzida em 2016 por Dan Hendrycks e Kevin Gimpel. Uma função de ativação determina a forma como um neurónio transforma a sua entrada antes de a transmitir para a camada seguinte. Sem ela, a sobreposição de camadas lineares produziria apenas uma transformação globalmente linear, o que limitaria o que uma rede neuronal pode aprender.
A GELU não aplica um limiar estrito. Ela dimensiona cada entrada em função do seu valor. Os valores positivos elevados passam quase inalterados, os valores próximos de zero são parcialmente atenuados e os valores negativos elevados são aproximados a zero. Os valores moderadamente negativos podem manter uma pequena saída negativa. O artigo refere que o artigo original da GELU avaliou a função em visão por computador, processamento de linguagem natural e reconhecimento de voz, e que relatou melhorias em relação a várias funções tradicionais nas suas experiências.
GELU face à ReLU
A ReLU, que significa Rectified Linear Unit, devolve 0 para uma entrada negativa e o próprio valor para uma entrada positiva. Assim, para uma entrada de -1, devolve 0, e para uma entrada de 2, devolve 2. A GELU comporta-se de forma diferente: uma entrada de -1 dá aproximadamente -0,159, e uma entrada de 2 dá aproximadamente 1,954. A função não é, portanto, estritamente crescente em todo o seu domínio, apresentando a sua zona negativa uma ligeira depressão antes de se aproximar de zero para valores muito negativos.
A GELU escreve-se como x × Φ(x), onde Φ(x) é a função de distribuição cumulativa da distribuição normal padrão, ou seja, uma distribuição com média zero e desvio padrão um. Esta função expressa-se através da função de erro erf. Para uma entrada de 1, o valor de Φ é aproximadamente 0,8413: o sinal positivo é assim amplamente conservado, enquanto o sinal negativo de -1 é fortemente reduzido. O texto esclarece que a GELU é determinística. Ela não elimina aleatoriamente saídas de neurónios durante a execução, mesmo que o seu funcionamento seja por vezes descrito como um mecanismo de filtragem probabilística.
A ReLU mantém-se popular por ser simples e pouco dispendiosa em termos de cálculo. A GELU oferece uma transformação mais suave, mas a sua forma matemática exige mais cálculos. O artigo sublinha ainda que nenhuma das duas é automaticamente melhor: a arquitetura do modelo, o conjunto de dados, o hardware e a implementação influenciam todos o resultado final.
Por que razão a GELU está presente nos Transformers
Um Transformer, a arquitetura na qual se baseiam o BERT e muitos grandes modelos de linguagem, combina mecanismos de atenção, camadas de normalização e redes neuronais designadas de propagação direta, ou FFN. A GELU é comumente utilizada no FFN, e não no cálculo das probabilidades de atenção. Na arquitetura BERT, ela é a função de ativação padrão das camadas ocultas, como indica a configuração do BERT da Hugging Face. Aparece também nos Transformers de visão, mas alguns modelos recentes utilizam variantes com portas baseadas na SiLU, como a SwiGLU.
A fórmula exata da GELU recorre à função de distribuição cumulativa gaussiana, mais dispendiosa de calcular do que funções mais simples. O artigo apresenta uma aproximação comum baseada na função tangente hiperbólica, que produz valores próximos da GELU exata. O PyTorch permite utilizar ambas as formulações através do seu parâmetro approximate.
Uma experiência em Python
O autor compara duas redes idênticas, uma com ReLU e outra com GELU, no conjunto de dados make_moons do scikit-learn, composto por 2000 amostras. Ambos os modelos partilham a mesma arquitetura, o mesmo otimizador Adam, a mesma taxa de aprendizagem de 0,001 e a mesma semente aleatória, ao longo de 100 épocas. O artigo alerta que uma única execução não é suficiente para estabelecer qual a melhor função: recomenda repetir a experiência com várias sementes aleatórias e reservar o conjunto de teste para a avaliação final. O seu objetivo não é demonstrar que a GELU é universalmente superior.
Para um modelo pré-treinado, o texto recomenda geralmente manter a função de ativação original. Substituir a GELU pela ReLU num Transformer pré-treinado altera os seus cálculos e pode reduzir o seu desempenho, a menos que o modelo modificado seja corretamente retreinado ou afinado.
