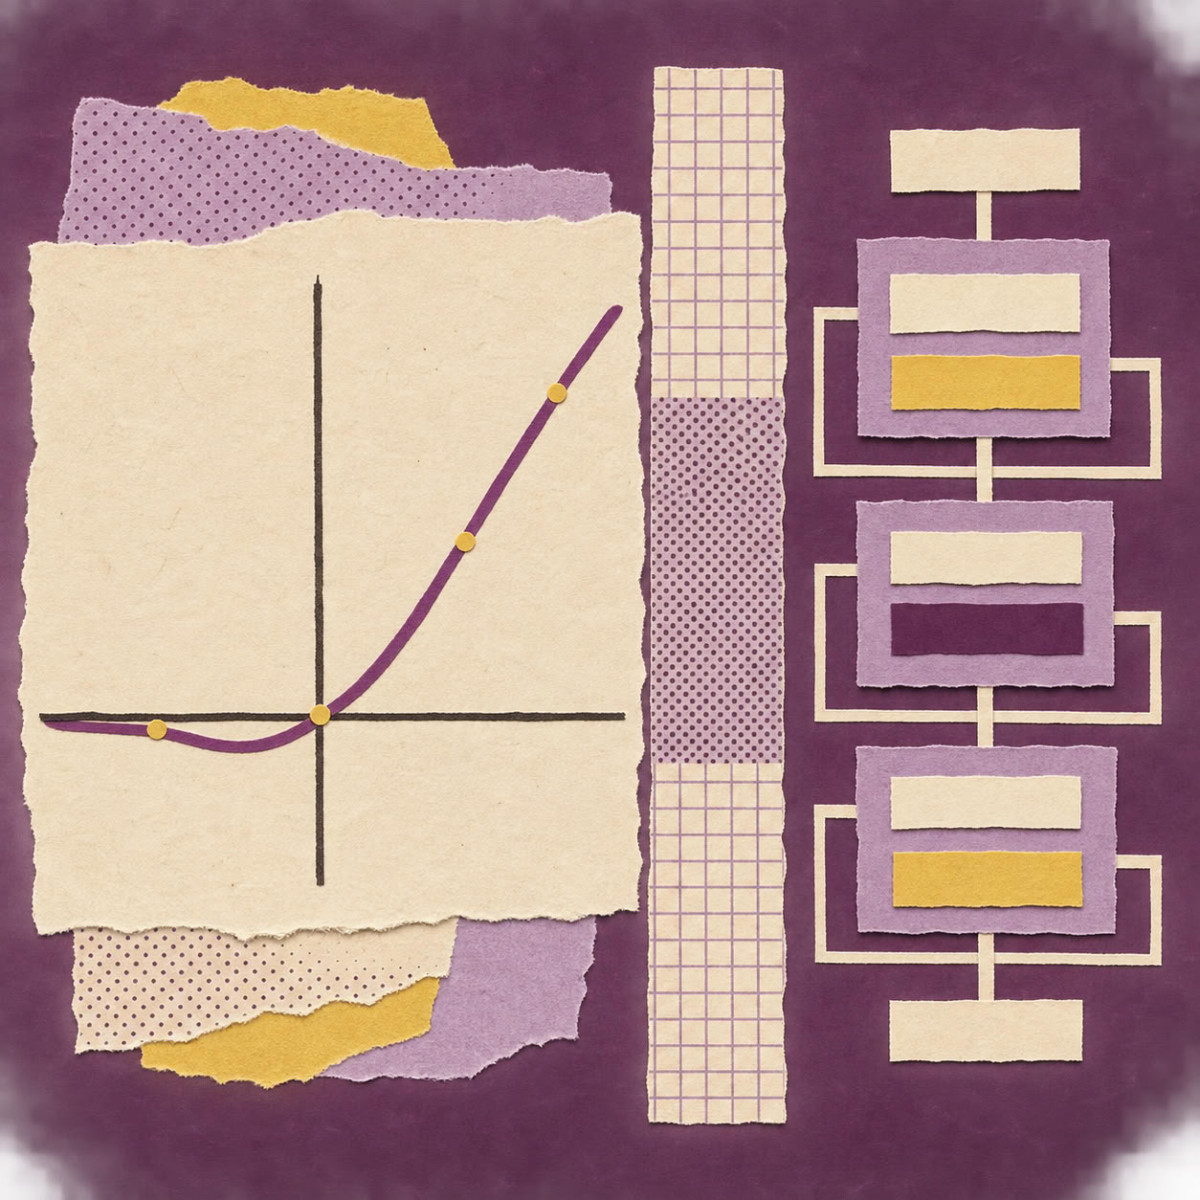

Perché i modelli Transformer, come BERT, utilizzano la funzione GELU invece della funzione ReLU? Secondo un articolo pubblicato da Analytics Vidhya, la risposta risiede nel modo in cui ciascuna tratta l’informazione. Mentre ReLU elimina completamente gli input negativi, GELU applica un meccanismo morbido, che dipende dal valore di ciascun input, per decidere quale parte dell’informazione deve passare.
GELU, per Gaussian Error Linear Unit, è una funzione di attivazione non lineare introdotta nel 2016 da Dan Hendrycks e Kevin Gimpel. Una funzione di attivazione determina il modo in cui un neurone trasforma il suo input prima di trasmetterlo allo strato successivo. Senza di essa, l’impilamento di strati lineari produrrebbe solo una trasformazione globalmente lineare, il che limiterebbe ciò che una rete neurale può apprendere.
GELU non applica una soglia rigida. Mette in scala ciascun input in base al suo valore. I forti valori positivi passano quasi inalterati, i valori vicini allo zero sono parzialmente attenuati e i forti valori negativi sono portati verso lo zero. I valori moderatamente negativi possono conservare un piccolo output negativo. L’articolo nota che l’articolo originale di GELU ha valutato la funzione in visione artificiale, elaborazione del linguaggio naturale e riconoscimento vocale, e ha riportato miglioramenti rispetto a diverse funzioni tradizionali nei suoi esperimenti.
GELU contro ReLU
ReLU, per Rectified Linear Unit, restituisce 0 per un input negativo e il valore stesso per un input positivo. Quindi, per un input di -1, restituisce 0, e per un input di 2, restituisce 2. GELU si comporta diversamente: un input di -1 dà circa -0,159, e un input di 2 dà circa 1,954. La funzione quindi non è strettamente crescente su tutto il suo dominio, la sua zona negativa presenta una leggera depressione prima di avvicinarsi a zero per valori molto negativi.
GELU si scrive x × Φ(x), dove Φ(x) è la funzione di ripartizione della legge normale centrata ridotta, cioè una legge di media zero e deviazione standard uno. Questa funzione si esprime utilizzando la funzione di errore erf. Per un input di 1, il valore di Φ è circa 0,8413: il segnale positivo è quindi ampiamente conservato, mentre il segnale negativo di -1 è fortemente ridotto. Il testo precisa che GELU è deterministica. Non elimina casualmente output di neuroni durante l’esecuzione, anche se il suo funzionamento è talvolta descritto come un meccanismo di filtraggio probabilistico.
ReLU rimane popolare perché è semplice e poco costosa dal punto di vista computazionale. GELU offre una trasformazione più morbida, ma la sua forma matematica richiede più calcoli. L’articolo sottolinea inoltre che nessuna delle due è automaticamente migliore: l’architettura del modello, il dataset, l’hardware e l’implementazione influenzano tutti il risultato finale.
Perché GELU è presente nei Transformer
Un Transformer, l’architettura su cui si basano BERT e molti grandi modelli linguistici, combina meccanismi di attenzione, strati di normalizzazione e reti neurali cosiddette feed-forward, o FFN. GELU è comunemente utilizzata nell’FFN, e non nel calcolo delle probabilità di attenzione. Nell’architettura BERT, è la funzione di attivazione predefinita degli strati nascosti, come indica la configurazione BERT di Hugging Face. Appare anche nei Transformer di visione, ma alcuni modelli recenti utilizzano varianti a gate basate su SiLU, come SwiGLU.
La formula esatta di GELU fa appello alla funzione di ripartizione gaussiana, più costosa da calcolare rispetto a funzioni più semplici. L’articolo presenta un’approssimazione comune basata sulla funzione tangente iperbolica, che produce valori vicini a GELU esatta. PyTorch permette di utilizzare entrambe le formulazioni grazie al suo parametro approximate.
Un esperimento in Python
L’autore confronta due reti identiche, una con ReLU e l’altra con GELU, sul dataset make_moons di scikit-learn, composto da 2000 campioni. Entrambi i modelli condividono la stessa architettura, lo stesso ottimizzatore Adam, lo stesso tasso di apprendimento di 0,001 e lo stesso seme casuale, su 100 epoche. L’articolo avverte che una sola esecuzione non basta a stabilire la funzione migliore: raccomanda di ripetere l’esperimento con più semi casuali e di riservare l’insieme di test alla valutazione finale. Il suo obiettivo non è dimostrare che GELU sia universalmente superiore.
Per un modello pre-addestrato, il testo raccomanda generalmente di conservare la funzione di attivazione originale. Sostituire GELU con ReLU in un Transformer pre-addestrato modifica i suoi calcoli e può ridurne le prestazioni, a meno che il modello modificato non sia correttamente ri-addestrato o affinato.
