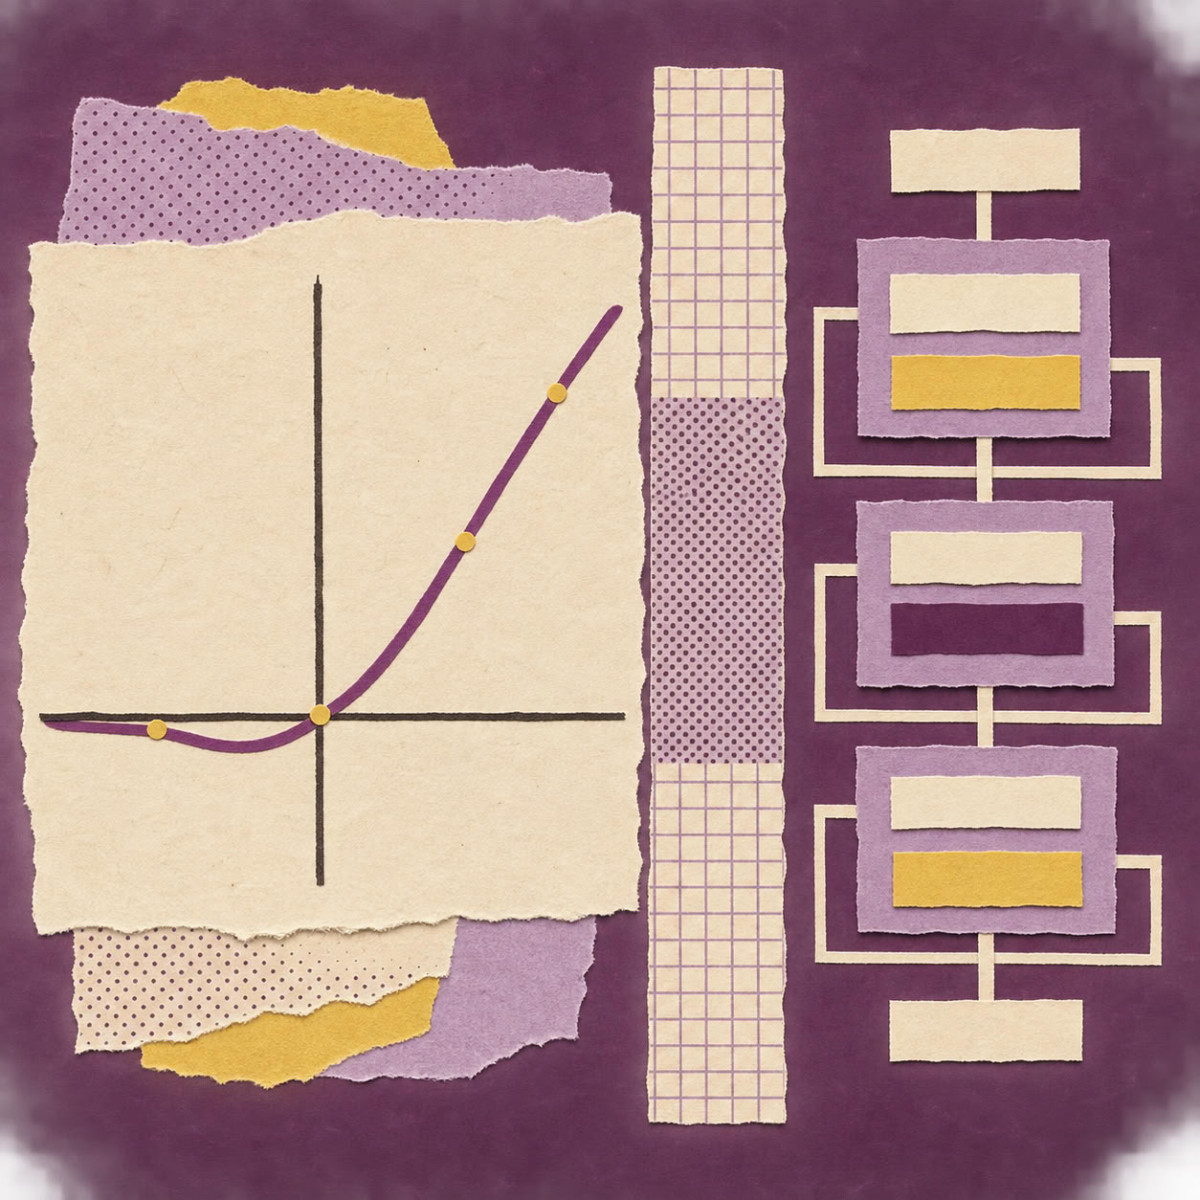

Dlaczego modele Transformer, takie jak BERT, używają funkcji GELU zamiast funkcji ReLU? Według artykułu opublikowanego przez Analytics Vidhya, odpowiedź tkwi w sposobie przetwarzania informacji przez każdą z nich. Tam, gdzie ReLU całkowicie usuwa wejścia ujemne, GELU stosuje płynny mechanizm, zależny od wartości każdego wejścia, aby zdecydować, jaka część informacji ma zostać przepuszczona.
- GELU pondère les entrées de façon douce, selon leur valeur, au lieu de les couper net comme ReLU.
- GELU est utilisée surtout dans les couches feed-forward des Transformers, comme BERT, et reste déterministe.
- ReLU reste populaire car elle est simple et peu coûteuse en calcul.
- Aucune des deux n’est universellement meilleure : il faut tester sur plusieurs graines et ne pas changer la fonction d’un modèle pré-entraîné.
GELU, czyli Gaussian Error Linear Unit, jest nieliniową funkcją aktywacji wprowadzoną w 2016 roku przez Dana Hendrycksa i Kevina Gimpela. Funkcja aktywacji określa sposób, w jaki neuron przekształca swoje wejście przed przekazaniem go do następnej warstwy. Bez niej układanie warstw liniowych dawałoby jedynie globalnie liniową transformację, co ograniczałoby możliwości uczenia się sieci neuronowej.
GELU nie stosuje ostrego progu. Skaluje każde wejście w zależności od jego wartości. Silne wartości dodatnie przechodzą prawie bez zmian, wartości bliskie zeru są częściowo tłumione, a silne wartości ujemne są sprowadzane w kierunku zera. Umiarkowanie ujemne wartości mogą zachować niewielkie ujemne wyjście. Artykuł zauważa, że oryginalna publikacja GELU oceniała funkcję w zakresie widzenia komputerowego, przetwarzania języka naturalnego i rozpoznawania mowy, i donosiła o poprawach w porównaniu z kilkoma tradycyjnymi funkcjami w swoich eksperymentach.
GELU kontra ReLU
ReLU, czyli Rectified Linear Unit, zwraca 0 dla wejścia ujemnego i samą wartość dla wejścia dodatniego. Zatem dla wejścia -1 zwraca 0, a dla wejścia 2 zwraca 2. GELU zachowuje się inaczej: wejście -1 daje około -0,159, a wejście 2 daje około 1,954. Funkcja nie jest więc ściśle rosnąca na całej swojej dziedzinie, jej obszar ujemny wykazuje lekkie zagłębienie przed zbliżeniem się do zera dla silnie ujemnych wartości.
GELU zapisuje się jako x × Φ(x), gdzie Φ(x) jest dystrybuantą standardowego rozkładu normalnego, czyli rozkładu o średniej zero i odchyleniu standardowym jeden. Funkcję tę wyraża się za pomocą funkcji błędu erf. Dla wejścia 1 wartość Φ wynosi około 0,8413: sygnał dodatni jest więc w dużej mierze zachowany, podczas gdy sygnał ujemny -1 jest silnie zredukowany. Tekst precyzuje, że GELU jest deterministyczna. Nie usuwa losowo wyjść neuronów podczas działania, nawet jeśli jej działanie jest czasem opisywane jako probabilistyczny mechanizm filtrowania.
ReLU pozostaje popularna, ponieważ jest prosta i mało kosztowna obliczeniowo. GELU oferuje płynniejszą transformację, ale jej postać matematyczna wymaga więcej obliczeń. Artykuł podkreśla ponadto, że żadna z nich nie jest automatycznie lepsza: architektura modelu, zestaw danych, sprzęt i implementacja wpływają na ostateczny wynik.
Dlaczego GELU występuje w Transformerach
Transformer, architektura leżąca u podstaw BERT-a i wielu dużych modeli językowych, łączy mechanizmy uwagi, warstwy normalizacji oraz tzw. sieci neuronowe typu feed-forward (FFN). GELU jest powszechnie używana w FFN, a nie w obliczaniu prawdopodobieństw uwagi. W architekturze BERT jest domyślną funkcją aktywacji warstw ukrytych, jak wskazuje konfiguracja BERT-a w Hugging Face. Pojawia się także w Transformerach wizyjnych, ale niektóre nowsze modele używają wariantów opartych na bramkach z SiLU, takich jak SwiGLU.
Dokładny wzór GELU wykorzystuje dystrybuantę rozkładu Gaussa, bardziej kosztowną obliczeniowo niż prostsze funkcje. Artykuł przedstawia powszechną aproksymację opartą na funkcji tangensa hiperbolicznego, która daje wartości zbliżone do dokładnej GELU. PyTorch umożliwia korzystanie z obu formuł dzięki swojemu parametrowi approximate.
Eksperyment w Pythonie
Autor porównuje dwie identyczne sieci, jedną z ReLU, a drugą z GELU, na zbiorze danych make_moons z scikit-learn, składającym się z 2000 próbek. Oba modele mają tę samą architekturę, ten sam optymalizator Adam, tę samą szybkość uczenia 0,001 i to samo ziarno losowe, przez 100 epok. Artykuł ostrzega, że jedno uruchomienie nie wystarczy, aby ustalić najlepszą funkcję: zaleca powtórzenie eksperymentu z wieloma ziarnami losowymi i zarezerwowanie zbioru testowego do końcowej oceny. Jego celem nie jest wykazanie, że GELU jest uniwersalnie lepsza.
W przypadku modelu wstępnie wytrenowanego tekst zaleca zazwyczaj zachowanie oryginalnej funkcji aktywacji. Zastąpienie GELU przez ReLU w wstępnie wytrenowanym Transformerze zmienia jego obliczenia i może obniżyć jego wydajność, chyba że zmodyfikowany model zostanie odpowiednio ponownie wytrenowany lub dostrojony.
