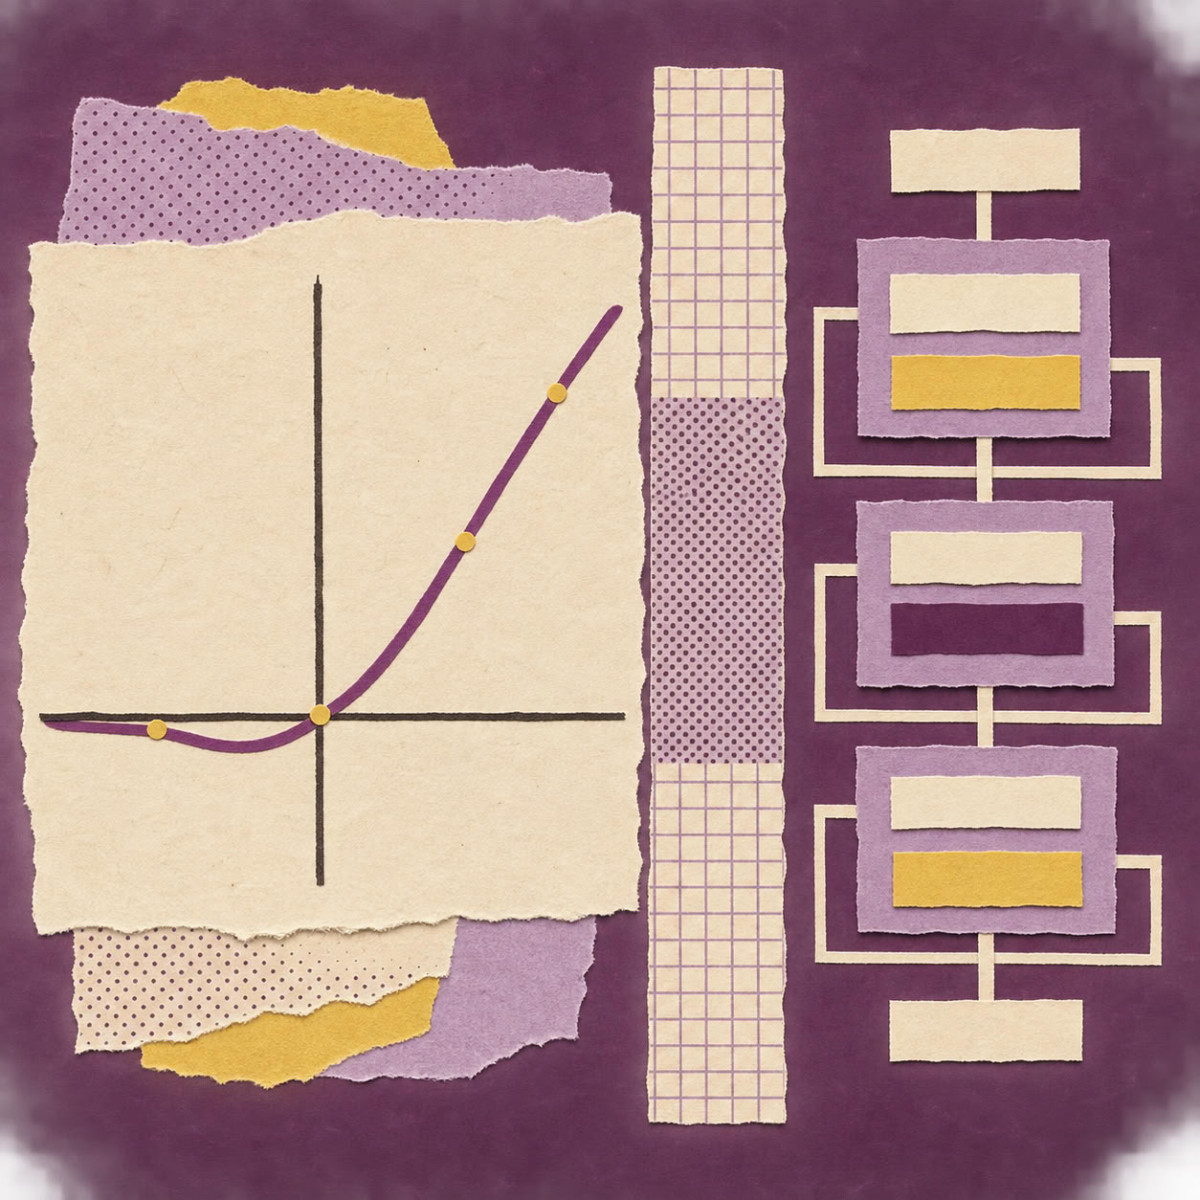

Waarom gebruiken Transformer-modellen, zoals BERT, de GELU-functie in plaats van de ReLU-functie? Volgens een artikel van Analytics Vidhya ligt het antwoord in de manier waarop elke functie informatie verwerkt. Waar ReLU negatieve invoeren volledig blokkeert, past GELU een vloeiend mechanisme toe, dat afhangt van de waarde van elke invoer, om te beslissen welk deel van de informatie doorgegeven moet worden.
GELU, voor Gaussian Error Linear Unit, is een niet-lineaire activatiefunctie die in 2016 werd geïntroduceerd door Dan Hendrycks en Kevin Gimpel. Een activatiefunctie bepaalt hoe een neuron zijn invoer transformeert voordat hij deze doorgeeft aan de volgende laag. Zonder deze functie zou een stapeling van lineaire lagen slechts een globaal lineaire transformatie opleveren, wat beperkt wat een neuraal netwerk kan leren.
GELU past geen strikte drempel toe. Ze schaalt elke invoer op basis van zijn waarde. Sterke positieve waarden gaan vrijwel onveranderd door, waarden dicht bij nul worden gedeeltelijk afgezwakt en sterke negatieve waarden worden naar nul getrokken. Matig negatieve waarden kunnen een kleine negatieve uitvoer behouden. Het artikel merkt op dat het oorspronkelijke GELU-artikel de functie evalueerde in computervisie, natuurlijke taalverwerking en spraakherkenning, en verbeteringen rapporteerde ten opzichte van verschillende traditionele functies in zijn experimenten.
GELU versus ReLU
ReLU, voor Rectified Linear Unit, geeft 0 terug voor een negatieve invoer en de waarde zelf voor een positieve invoer. Dus voor een invoer van -1 geeft ze 0 terug, en voor een invoer van 2 geeft ze 2 terug. GELU gedraagt zich anders: een invoer van -1 geeft ongeveer -0,159, en een invoer van 2 geeft ongeveer 1,954. De functie is dus niet strikt stijgend over haar hele domein; haar negatieve gebied vertoont een lichte dip voordat ze voor zeer negatieve waarden weer naar nul nadert.
GELU wordt geschreven als x × Φ(x), waarbij Φ(x) de cumulatieve verdelingsfunctie is van de standaardnormale verdeling, dat wil zeggen een verdeling met gemiddelde nul en standaardafwijking één. Deze functie wordt uitgedrukt met behulp van de foutfunctie erf. Voor een invoer van 1 is de waarde van Φ ongeveer 0,8413: het positieve signaal wordt dus grotendeels behouden, terwijl het negatieve signaal van -1 sterk wordt gereduceerd. De tekst preciseert dat GELU deterministisch is. Ze verwijdert niet willekeurig neuronuitvoeren tijdens de uitvoering, ook al wordt haar werking soms beschreven als een probabilistisch filtermechanisme.
ReLU blijft populair omdat ze eenvoudig en rekenkundig goedkoop is. GELU biedt een vloeiendere transformatie, maar haar wiskundige vorm vraagt meer berekeningen. Het artikel benadrukt verder dat geen van beide automatisch beter is: de modelarchitectuur, de dataset, de hardware en de implementatie beïnvloeden allemaal het eindresultaat.
Waarom GELU aanwezig is in Transformers
Een Transformer, de architectuur waarop BERT en vele grote taalmodellen zijn gebaseerd, combineert aandachtmechanismen, normalisatielagen en zogenaamde feedforward neurale netwerken, of FFN’s. GELU wordt vaak gebruikt in de FFN, en niet in de berekening van de aandachtskansen. In de BERT-architectuur is ze de standaard activatiefunctie voor de verborgen lagen, zoals aangegeven in de BERT-configuratie van Hugging Face. Ze komt ook voor in vision Transformers, maar sommige recente modellen gebruiken op SiLU gebaseerde poortvarianten, zoals SwiGLU.
De exacte formule van GELU maakt gebruik van de Gaussische cumulatieve verdelingsfunctie, die duurder is om te berekenen dan eenvoudigere functies. Het artikel presenteert een gebruikelijke benadering gebaseerd op de hyperbolische tangensfunctie, die waarden produceert die dicht bij de exacte GELU liggen. PyTorch maakt het gebruik van beide formuleringen mogelijk dankzij zijn approximate parameter.
Een experiment in Python
De auteur vergelijkt twee identieke netwerken, één met ReLU en één met GELU, op de make_moons dataset van scikit-learn, bestaande uit 2000 samples. Beide modellen delen dezelfde architectuur, dezelfde Adam-optimizer, hetzelfde leerpercentage van 0,001 en hetzelfde random seed, over 100 epochs. Het artikel waarschuwt dat één enkele run niet voldoende is om de beste functie vast te stellen: het raadt aan het experiment te herhalen met meerdere random seeds en de testset te reserveren voor de finale evaluatie. Het doel is niet om aan te tonen dat GELU universeel superieur is.
Voor een voorgetraind model raadt de tekst over het algemeen aan de oorspronkelijke activatiefunctie te behouden. Het vervangen van GELU door ReLU in een voorgetrainde Transformer verandert zijn berekeningen en kan de prestaties verminderen, tenzij het aangepaste model correct opnieuw wordt getraind of gefinetuned.
