
BERTのようなTransformerモデルは、なぜReLUではなくGELU関数を使用するのか? Analytics Vidhyaが公開した記事によれば、その答えは各関数が情報を処理する方法にある。ReLUが負の入力を完全に除去するのに対し、GELUは滑らかなメカニズムを適用し、各入力の値に基づいて情報のどの部分を通すべきかを決定する。
GELU(Gaussian Error Linear Unit)は、2016年にDan HendrycksとKevin Gimpelによって導入された非線形活性化関数である。活性化関数は、ニューロンが入力を次の層に渡す前にどのように変換するかを決定する。これがなければ、線形層を積み重ねても全体的に線形な変換しか生み出さず、ニューラルネットワークが学習できることが制限されてしまう。
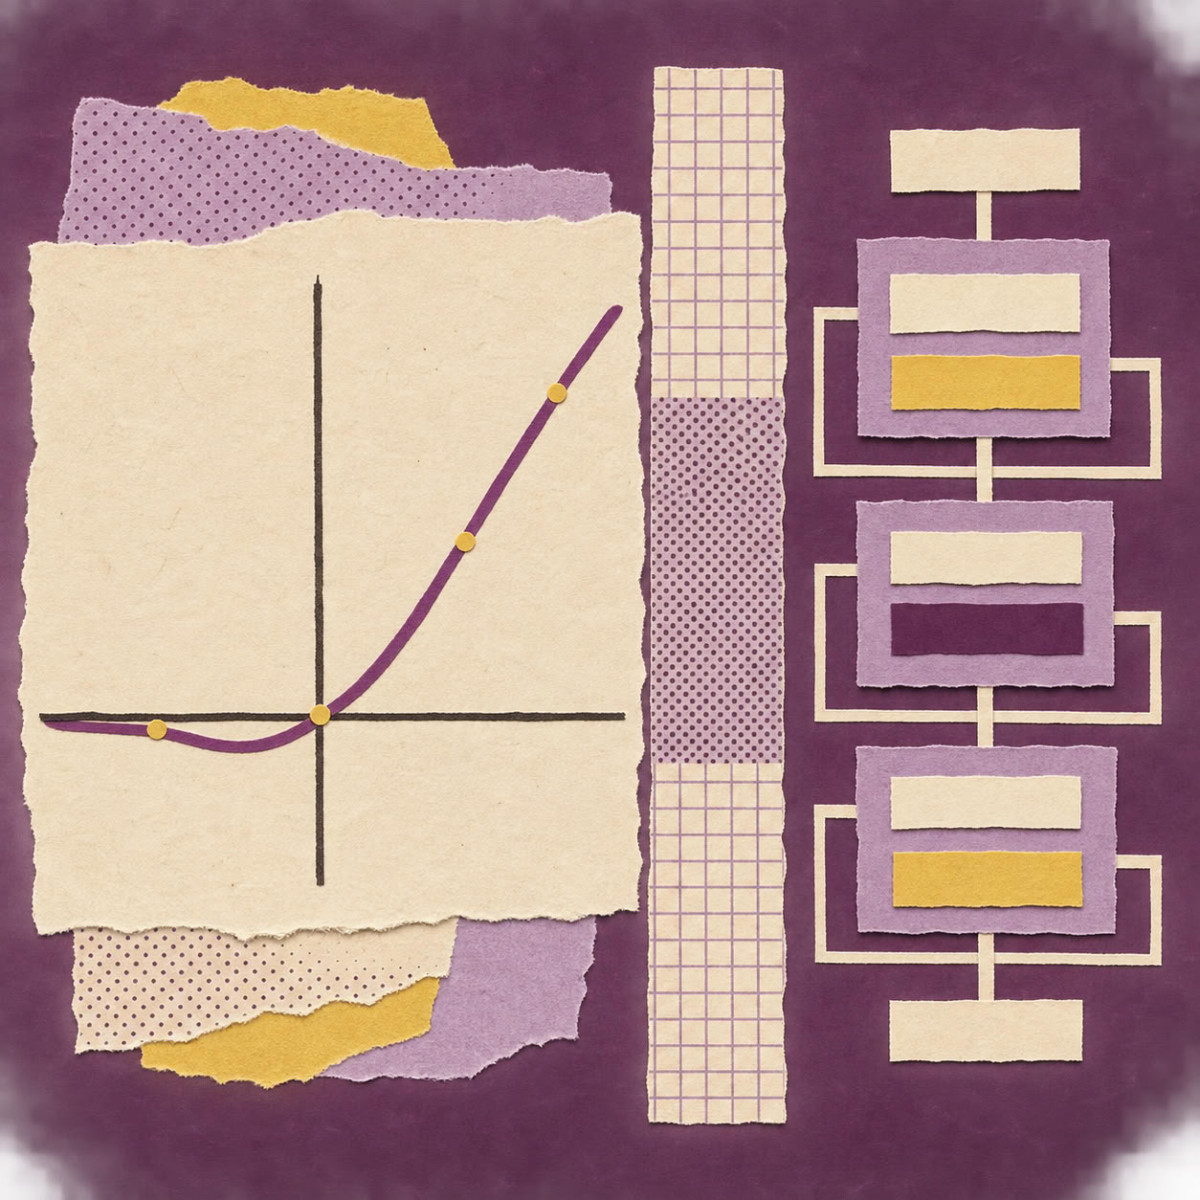
GELUは厳密なしきい値を適用しない。各入力をその値に応じてスケーリングする。強い正の値はほとんど変化せずに通過し、ゼロに近い値は部分的に減衰され、強い負の値はゼロに向かって引き寄せられる。中程度の負の値は、小さな負の出力を保持する可能性がある。記事では、GELUの原論文がコンピュータビジョン、自然言語処理、音声認識において関数を評価し、実験において従来のいくつかの関数に対する改善を報告したと記されている。
GELU対ReLU
ReLU(Rectified Linear Unit)は、負の入力に対して0を、正の入力に対して入力値そのものを返す。したがって、入力-1に対しては0を、入力2に対しては2を返す。GELUは異なる挙動を示す:入力-1は約-0.159を、入力2は約1.954を与える。この関数は定義域全体で厳密に単調増加ではなく、その負の領域は非常に負の値でゼロに近づく前にわずかな谷を示す。
GELUはx × Φ(x)と記述され、ここでΦ(x)は平均ゼロ、標準偏差1の標準正規分布の累積分布関数である。この関数は誤差関数erfを用いて表現される。入力1に対して、Φの値は約0.8413である:したがって正の信号は大部分が保持され、一方-1の負の信号は大幅に減少する。テキストは、GELUが決定的であることを明確にしている。その動作が確率的なフィルタリングメカニズムとして説明されることがあっても、実行中にニューロンの出力をランダムに削除することはない。
ReLUは、シンプルで計算コストが低いため、依然として人気がある。GELUはより滑らかな変換を提供するが、その数学的形式はより多くの計算を必要とする。記事はさらに、どちらも自動的に優れているわけではないと強調している:モデルのアーキテクチャ、データセット、ハードウェア、実装のすべてが最終結果に影響を与える。
TransformerにGELUが存在する理由
BERTや多くの大規模言語モデルの基盤となるアーキテクチャであるTransformerは、注意機構、正規化層、および順伝播ニューラルネットワーク(FFN)を組み合わせている。GELUは一般的にFFNで使用され、注意確率の計算では使用されない。BERTアーキテクチャでは、Hugging FaceのBERT設定が示すように、隠れ層のデフォルトの活性化関数である。また、ビジョンTransformerにも登場するが、最近の一部のモデルではSwiGLUのようなSiLUベースのゲート付き変種を使用している。
GELUの正確な式はガウス累積分布関数を用いており、より単純な関数よりも計算コストが高い。記事では、双曲線正接関数に基づく一般的な近似を紹介しており、これは正確なGELUに近い値を生成する。PyTorchはapproximateパラメータにより両方の定式化を使用可能にしている。
Pythonでの実験
著者は、scikit-learnの2,000サンプルからなるデータセットmake_moonsにおいて、ReLUを使用するものとGELUを使用するものという2つの同一のネットワークを比較している。両モデルは同じアーキテクチャ、同じAdamオプティマイザ、同じ学習率0.001、同じ乱数シードを共有し、100エポック実行した。記事は、単一の実行では最良の関数を確立するには不十分であると警告している:複数の乱数シードで実験を繰り返し、テストセットを最終評価のために取っておくことを推奨している。その目的はGELUが普遍的に優れていることを証明することではない。
事前学習済みモデルについては、テキストは一般的に元の活性化関数を保持することを推奨している。事前学習済みTransformerのGELUをReLUに置き換えることは、その計算を変更し、変更されたモデルが適切に再学習またはファインチューニングされない限り、性能を低下させる可能性がある。
